1. 课程导入
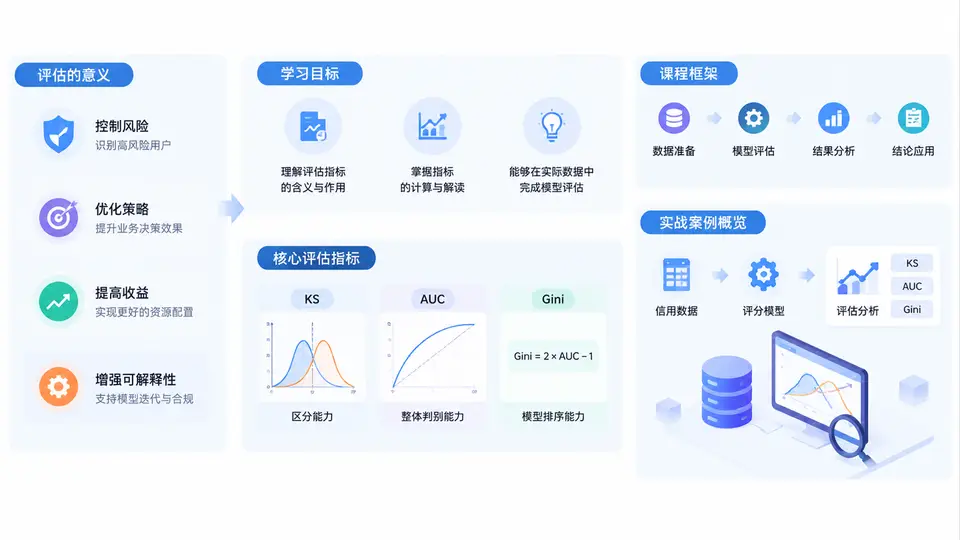
一、为什么信用评分模型必须“被评估”
在信贷、消费金融、小微信贷与互联网金融场景中,信用评分模型的核心任务是把借款人的违约风险映射为一个可排序的分数。模型上线后,业务方最关心的问题通常不是“模型用了什么算法”,而是:这个模型能不能把好人排在前面、把坏人排在后面?如果排序能力不足,审批通过率、坏账率、授信额度与定价策略都会失真。
信用评分模型的评估,本质上是对风险排序能力的量化验证。KS、AUC与Gini是三个最常用、也最容易混淆的指标。它们都来源于同一张排序表,却从不同角度回答“模型区分好坏客户的能力有多强”。理解它们的定义、计算逻辑、业务含义与使用边界,是从“会建模”走向“能交付模型”的关键一步。
核心结论:信用评分模型不是预测“某个人一定违约”,而是预测“某个人比另一个人更可能违约”。因此,评估的重点是排序能力,而不是单点准确率。
二、学习目标:学完本课程你能做到什么
本课程围绕KS、AUC与Gini三个指标展开,目标不是停留在公式记忆,而是形成一套可落地的评估工作流。具体学习目标如下:
- 理解原理:掌握KS、AUC、Gini的统计定义、几何含义与相互关系,能解释为什么AUC等于Gini的一半加0.5。
- 掌握计算:能够从样本分数与标签出发,手工或代码计算KS、AUC、Gini,并绘制KS曲线、ROC曲线与洛伦兹曲线。
- 业务解读:能把指标数值翻译成审批策略语言,例如“KS=0.42意味着在某个阈值下,好坏样本累计占比最大差距为42%”。
- 实战评估:能够完成跨时间验证、跨样本验证,识别指标虚高、样本穿越、标签泄漏等常见问题。
- 复盘优化:能够根据评估结果判断模型是否上线、如何分箱、如何设定cutoff、如何向业务方汇报。
三、整体课程框架:从指标到决策
本课程共30章,整体遵循“原理—计算—可视化—验证—业务决策”的递进结构。第1章作为导入,先建立全局认知;后续章节将逐步深入。
| 模块 | 核心内容 | 产出能力 |
|---|---|---|
| 基础原理 | 混淆矩阵、TPR、FPR、KS定义、AUC定义、Gini定义 | 能准确解释三个指标 |
| 计算与实现 | 排序表、累计好坏分布、梯形法、代码实现 | 能独立计算并复现结果 |
| 可视化 | KS曲线、ROC曲线、洛伦兹曲线、CAP曲线 | 能读图并定位最优阈值 |
| 模型验证 | 训练/测试/跨时间样本、OOT验证、稳定性 | 能判断模型是否过拟合 |
| 业务决策 | cutoff选择、通过率与坏账率权衡、指标汇报 | 能支持审批策略制定 |
| 误区复盘 | 样本不均衡、标签泄漏、指标虚高、分箱陷阱 | 能识别并修正评估偏差 |
四、核心原理速览:三个指标到底在算什么
假设我们已经有一组样本,每个样本有真实标签(好/坏)和模型分数。把所有样本按分数从高到低排序,然后逐步计算累计坏样本占比(TPR)与累计好样本占比(FPR)。
- KS:在某个阈值下,TPR与FPR的最大差值。它衡量的是“模型能把好坏样本拉开的最大距离”。
- AUC:ROC曲线下的面积,等价于随机抽取一个坏样本和一个好样本,模型给坏样本更高分的概率。
- Gini:洛伦兹曲线与对角线之间面积的两倍,也等于2×AUC−1。它常被用于衡量模型相对随机模型的提升幅度。
记忆口诀:KS看“最大差距”,AUC看“整体排序”,Gini看“相对提升”。三者同源,但回答的问题不同。
五、实战案例概览:一个可复现的信用评分评估场景
为了让指标不悬空,本课程将贯穿一个实战案例:某消费金融公司的小额现金贷申请评分模型。数据集包含申请人的历史行为、征信特征与最终表现标签,其中坏样本定义为“逾期90天以上”。
在案例中,我们会完成以下任务:
- 读取样本分数与标签,构建排序表。
- 计算每个阈值下的TPR、FPR,并绘制KS曲线。
- 计算AUC与Gini,验证三者关系。
- 在训练集、测试集与跨时间样本上分别评估,观察指标衰减。
- 根据KS最大点选择cutoff,并测算通过率与预期坏账率。
# 示例:从分数与标签计算KS、AUC、Gini的核心步骤
import numpy as np
from sklearn.metrics import roc_auc_score, roc_curve

# y_true: 1表示坏样本,0表示好样本
# y_score: 模型输出的违约概率或评分
fpr, tpr, thresholds = roc_curve(y_true, y_score)
ks = np.max(tpr - fpr)
auc = roc_auc_score(y_true, y_score)
gini = 2 * auc - 1

print(f"KS={ks:.4f}, AUC={auc:.4f}, Gini={gini:.4f}")
通过这个案例,你会看到:同一个模型在不同样本上的KS可能从0.45降到0.32,AUC从0.78降到0.71。指标下降不一定是模型变差,也可能是样本分布变化、时间窗口差异或标签定义不一致。评估的价值,正在于把这些变化解释清楚。
六、常见误区与复盘视角
在进入正式学习前,先建立几个“防坑”意识,能显著提升后续学习效率。
- 误区一:只看AUC,不看KS。AUC是全局指标,KS更关注局部最大区分能力。业务审批往往关心某个cutoff附近的区分度,此时KS更直接。
- 误区二:KS越高越好。KS过高可能意味着过拟合,尤其在样本量小或特征穿越时。需要结合跨时间验证判断。
- 误区三:忽略样本不均衡。坏样本极少时,AUC可能仍然很高,但KS对少数类更敏感,需同时观察。
- 误区四:把Gini当成独立指标。Gini与AUC是线性关系,报告时二者选其一即可,避免重复堆砌。
复盘提醒:任何评估指标都不能脱离样本定义、时间窗口与业务场景。看到KS=0.6不要急着高兴,先问:样本是否跨时间?标签是否泄漏?坏样本定义是否一致?
七、本章小结与学习准备
本章建立了信用评分模型评估的整体认知:评估的核心是排序能力,KS、AUC与Gini是三个互补的量化工具;课程将沿着“原理—计算—可视化—验证—决策”的路径展开,并以一个消费金融评分模型案例贯穿始终。接下来,你需要准备好Python环境、一份带标签的评分样本,以及一个基本问题:我的模型,到底能不能把坏人排到前面?