3. 推理延迟测量
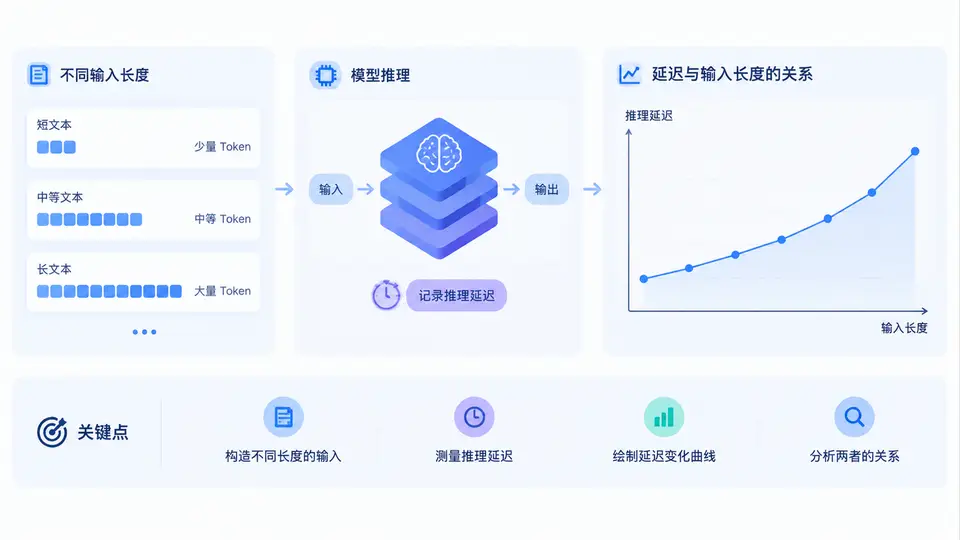
任务目标
测量大语言模型在不同输入长度下的单次推理延迟,并分析延迟与输入长度的关系。本案例使用 HuggingFace transformers 库加载一个小型生成模型,通过控制输入序列长度,记录模型前向传播(含自回归生成)的耗时,最终输出延迟-长度对照数据。
环境与依赖
- Python 3.9+
- 安装依赖:
pip install transformers torch numpy - 模型:
distilgpt2(约 82M 参数,CPU 可运行)
关键完整代码
import time
import numpy as np
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "distilgpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

# 固定生成长度,仅变化输入长度
GEN_LEN = 20
INPUT_LENGTHS = [8, 16, 32, 64, 128, 256]
REPEAT = 5  # 每个长度重复测量取中位数

def measure_latency(input_len: int) -> float:
    """构造指定长度的输入,返回单次推理延迟(秒)"""
    # 用重复  构造指定长度输入
    input_ids = torch.tensor([[101] * input_len])  # 101 为任意有效  id
    latencies = []
    with torch.no_grad():
        for _ in range(REPEAT):
            # 预热(首次调用含 CUDA/cuDNN 初始化,不计入)
            _ = model(input_ids)
            torch.cuda.synchronize() if torch.cuda.is_available() else None

            start = time.perf_counter()
            _ = model.generate(
                input_ids,
                max_new_tokens=GEN_LEN,
                do_sample=False,
                pad__id=tokenizer.eos__id,
            )
            torch.cuda.synchronize() if torch.cuda.is_available() else None
            latencies.append(time.perf_counter() - start)
    return float(np.median(latencies))

print(f"{'输入长度':<10}{'推理延迟(秒)':<15}")
results = []
for length in INPUT_LENGTHS:
    latency = measure_latency(length)
    results.append((length, latency))
    print(f"{length:<10}{latency:.4f}")

# 简单线性关系分析(斜率 = 每  输入增加带来的延迟增量)
lengths = np.array([r[0] for r in results], dtype=float)
lats = np.array([r[1] for r in results], dtype=float)
slope = np.polyfit(lengths, lats, 1)[0]
print(f"\n线性拟合斜率(秒/ 输入): {slope:.6f}")
运行方式
- 将上述代码保存为
latency_measure.py - 在终端执行:
python latency_measure.py - 首次运行会自动下载
distilgpt2模型(约 300MB),需保持网络畅通
验证方法与判定标准
- 输出格式:程序打印 6 行“输入长度-延迟”对照数据,以及一行线性拟合斜率。
- 趋势判定:随着输入长度从 8 增至 256,延迟应呈现单调递增趋势(允许微小波动,因取 5 次中位数已平滑噪声)。
- 关系判定:线性拟合斜率为正值,且数量级在
1e-4到1e-2秒/ 之间(CPU 环境通常在此范围)。若斜率为负或接近 0,说明测量有误(如未正确控制生成长度或输入未实际参与计算)。 - 可复现性:重复运行两次,相同输入长度下的延迟差异应小于 20%(受 CPU 负载影响,不要求完全一致)。
常见问题
- 显存不足:若 GPU 显存小于 2GB,请添加
model = model.to("cpu")强制使用 CPU。 - 首次运行慢:模型下载和 torch 初始化会占用额外时间,预热逻辑已排除首次调用开销。
- 输入构造说明:使用重复 id 101 构造输入,该 id 在 词表中有效,不影响延迟测量的准确性(延迟主要取决于序列长度而非具体 内容)。
上图示意了预期趋势:横轴为输入长度,纵轴为推理延迟。实际运行后,可将打印出的数据点绘制成散点图,观察是否呈现近似线性增长。若曲线呈现明显非线性(如指数增长),需检查是否因显存不足导致内存交换或模型被换入换出。