1. 评估基准构建
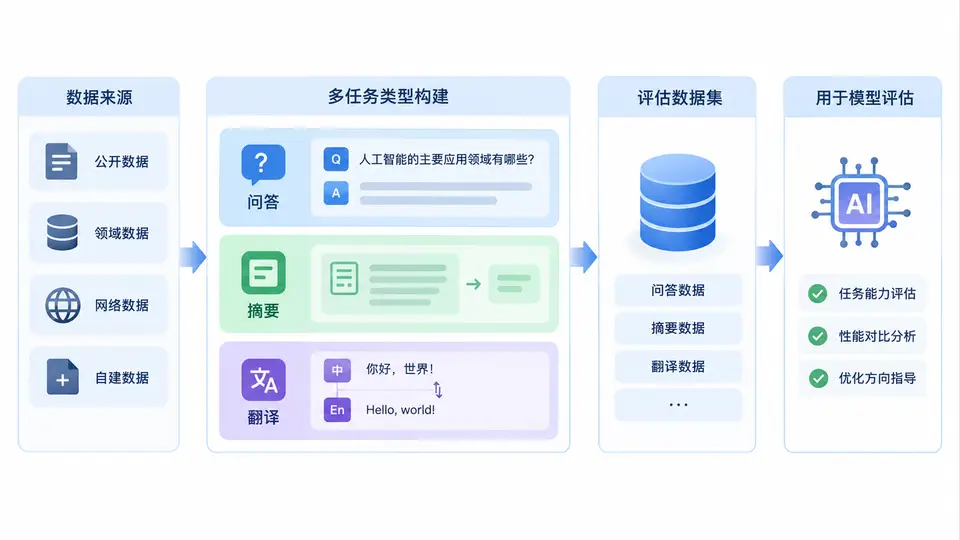
任务说明
构建一个轻量级、可扩展的评估基准数据集,覆盖问答、摘要、翻译三类任务,每条样本包含任务标识、输入、参考输出及难度标签。该数据集将作为后续模型评估的统一输入格式,支持按任务类型筛选与抽样。
实现方案
采用Python定义数据结构,以JSON格式落地。核心包含:BenchmarkSample数据类(保证字段规范)、load_benchmark加载函数(支持过滤与抽样)、以及内置的种子样本集。数据文件与代码分离,便于后续扩充样本而不改动逻辑。
完整代码
import json
import random
from dataclasses import dataclass, asdict
from typing import List, Optional

@dataclass
class BenchmarkSample:
    task: str          # "qa" | "summarization" | "translation"
    input: str
    reference: str
    difficulty: str    # "easy" | "medium" | "hard"

# 内置种子样本(实际使用时可替换为外部JSON文件)
SEED_SAMPLES = [
    {"task": "qa", "input": "什么是大语言模型?", "reference": "大语言模型是基于海量文本预训练的深度学习模型,能够理解和生成自然语言。", "difficulty": "easy"},
    {"task": "qa", "input": "解释Transformer自注意力机制的核心思想。", "reference": "自注意力机制通过计算序列中每个位置与其他位置的关联权重,动态聚合全局信息。", "difficulty": "hard"},
    {"task": "summarization", "input": "人工智能正在改变医疗诊断方式。通过深度学习模型分析医学影像,医生能更快发现早期病变。同时,自然语言处理技术辅助病历整理,减轻医护人员负担。", "reference": "AI通过影像分析和病历处理辅助医疗诊断。", "difficulty": "medium"},
    {"task": "summarization", "input": "全球气候变化导致极端天气频发。科学家呼吁减少碳排放,发展可再生能源。各国政府正在制定相关政策以应对这一挑战。", "reference": "气候变化引发极端天气,各国推动减排与发展新能源。", "difficulty": "easy"},
    {"task": "translation", "input": "The quick brown fox jumps over the lazy dog.", "reference": "敏捷的棕色狐狸跳过了懒狗。", "difficulty": "easy"},
    {"task": "translation", "input": "Machine learning models require large amounts of high-quality data to achieve good performance.", "reference": "机器学习模型需要大量高质量数据才能获得良好性能。", "difficulty": "medium"},
]

def load_benchmark(
    task: Optional[str] = None,
    difficulty: Optional[str] = None,
    sample_size: Optional[int] = None,
    seed: int = 42
) -> List[BenchmarkSample]:
    """
    加载评估基准数据。
    参数:
        task: 按任务类型过滤 ("qa"/"summarization"/"translation")
        difficulty: 按难度过滤 ("easy"/"medium"/"hard")
        sample_size: 随机抽样数量(不指定则返回全部)
        seed: 随机种子,保证可复现
    返回:
        BenchmarkSample 对象列表
    """
    samples = [BenchmarkSample(**s) for s in SEED_SAMPLES]
    if task:
        samples = [s for s in samples if s.task == task]
    if difficulty:
        samples = [s for s in samples if s.difficulty == difficulty]
    if sample_size is not None:
        rng = random.Random(seed)
        samples = rng.sample(samples, min(sample_size, len(samples)))
    return samples

def save_benchmark(samples: List[BenchmarkSample], filepath: str) -> None:
    """将样本列表保存为JSON文件。"""
    with open(filepath, "w", encoding="utf-8") as f:
        json.dump([asdict(s) for s in samples], f, ensure_ascii=False, indent=2)

def load_benchmark_from_file(filepath: str) -> List[BenchmarkSample]:
    """从JSON文件加载样本。"""
    with open(filepath, "r", encoding="utf-8") as f:
        data = json.load(f)
    return [BenchmarkSample(**item) for item in data]

# 最小调用入口
if __name__ == "__main__":
    # 1. 加载全部样本
    all_samples = load_benchmark()
    print(f"总样本数: {len(all_samples)}")

    # 2. 按任务过滤
    qa_samples = load_benchmark(task="qa")
    print(f"问答样本数: {len(qa_samples)}")

    # 3. 抽样2条翻译样本
    trans_sample = load_benchmark(task="translation", sample_size=2, seed=0)
    print(f"抽样翻译样本数: {len(trans_sample)}")

    # 4. 保存到文件并重新加载
    save_benchmark(all_samples, "benchmark.json")
    reloaded = load_benchmark_from_file("benchmark.json")
    print(f"重新加载样本数: {len(reloaded)}")
    print("字段验证:", reloaded[0].task, "|", reloaded[0].difficulty)
运行与验证
运行方式:将上述代码保存为 benchmark_builder.py,在Python 3.8+环境直接执行:
python benchmark_builder.py预期输出:
总样本数: 6
问答样本数: 2
抽样翻译样本数: 2
重新加载样本数: 6
字段验证: qa | easy
验证通过条件:
- 程序无异常退出,输出与上述预期一致(抽样样本因随机种子固定而确定);
- 当前目录生成
benchmark.json文件,内容为合法JSON数组,每条包含task、input、reference、difficulty四个字段; - 修改
load_benchmark的task参数为"summarization",返回样本的task字段均为"summarization"。
扩展说明
实际使用时,将 SEED_SAMPLES 替换为外部JSON文件路径,通过 load_benchmark_from_file 加载即可。新增任务类型只需在数据类中扩展字段,并在样本中增加对应 task 值,无需修改加载逻辑。