4. 识别闲置云资源并生成优化清单
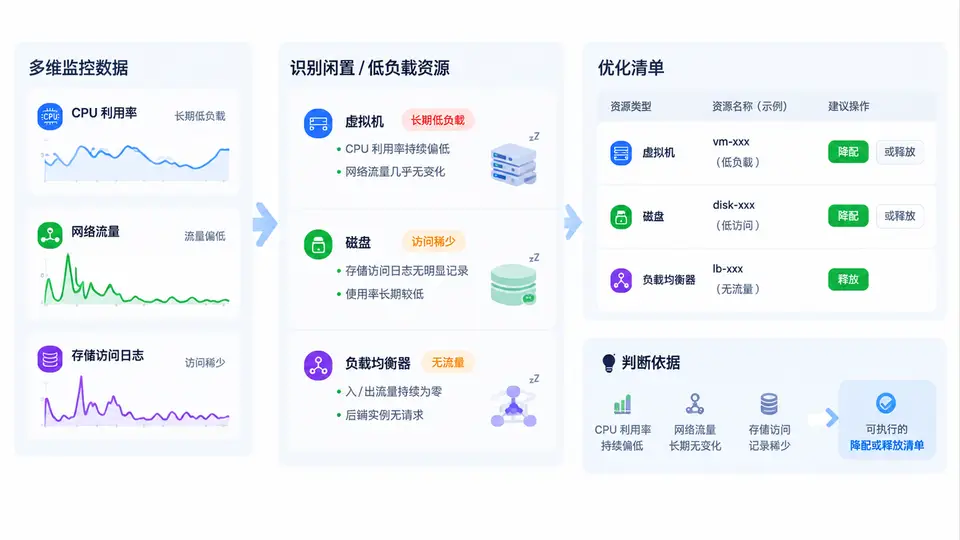
从“账单贵”到“资源闲”:识别逻辑与判定阈值
闲置资源识别的核心不是看单点快照,而是看时间窗口内的持续低负载。对虚拟机、磁盘和负载均衡器,需要分别采集不同的指标,并用“观察期 + 阈值 + 持续时长”三要素做判定,避免把夜间低谷或业务波谷误判为闲置。
- 虚拟机(VM):CPU 利用率、网络入/出流量。典型判定:近 14 天 P95 CPU < 5% 且日均网络流量 < 1 Mbps。
- 云盘/磁盘:读写 IOPS、吞吐量、是否挂载。典型判定:近 30 天无挂载记录,或已挂载但 IOPS 持续为 0。
- 负载均衡器(LB):活跃连接数、请求数、后端健康实例数。典型判定:近 14 天日均请求数 < 100 且无健康后端。
判定阈值必须结合业务基线调整:批处理节点白天低 CPU 但夜间跑批,不能仅凭 CPU 判闲置;应叠加网络流量与磁盘 IO 交叉验证。
采集与判定:用查询语句把“闲”筛出来
以下以常见的云监控指标为例,展示如何从指标数据中筛选出候选闲置资源。假设指标已按小时粒度写入本地表 metric_hourly,字段包括 resource_id、resource_type、metric_name、ts、value。
-- 1) 虚拟机:近14天 P95 CPU < 5% 且日均网络流量 < 1 Mbps
WITH vm_cpu AS (
  SELECT resource_id,
         PERCENTILE_CONT(0.95) WITHIN GROUP (ORDER BY value) AS p95_cpu
  FROM metric_hourly
  WHERE resource_type = 'vm'
    AND metric_name = 'cpu_utilization'
    AND ts >= NOW() - INTERVAL '14 days'
  GROUP BY resource_id
),
vm_net AS (
  SELECT resource_id,
         AVG(value) AS avg_net_mbps
  FROM metric_hourly
  WHERE resource_type = 'vm'
    AND metric_name = 'network_total_mbps'
    AND ts >= NOW() - INTERVAL '14 days'
  GROUP BY resource_id
)
SELECT c.resource_id, c.p95_cpu, n.avg_net_mbps
FROM vm_cpu c
JOIN vm_net n USING (resource_id)
WHERE c.p95_cpu < 5
  AND n.avg_net_mbps < 1;

-- 2) 磁盘:近30天无挂载 或 IOPS 持续为0
SELECT resource_id, MAX(value) AS max_iops
FROM metric_hourly
WHERE resource_type = 'disk'
  AND metric_name = 'disk_iops'
  AND ts >= NOW() - INTERVAL '30 days'
GROUP BY resource_id
HAVING MAX(value) = 0;

-- 3) 负载均衡器:近14天日均请求 < 100 且无健康后端
SELECT resource_id, AVG(value) AS avg_requests
FROM metric_hourly
WHERE resource_type = 'lb'
  AND metric_name = 'request_count'
  AND ts >= NOW() - INTERVAL '14 days'
GROUP BY resource_id
HAVING AVG(value) < 100;
上述 SQL 为教学示例,实际字段名和函数需按所用监控系统(如 Prometheus、CloudWatch、云监控)调整。执行前先用小范围时间窗口验证结果是否符合预期。
生成可执行的优化清单
把判定结果与资源元数据(规格、标签、负责人、计费方式)关联,输出一张可直接分派执行的清单。清单至少包含以下字段:
| 字段 | 说明 | 示例 |
|---|---|---|
| resource_id | 资源唯一标识 | i-0a1b2c3d4e5f |
| resource_type | vm / disk / lb | vm |
| current_spec | 当前规格或容量 | 4 vCPU / 8 GB |
| suggested_action | 释放 / 降配 / 合并 / 保留观察 | 降配 |
| target_spec | 建议目标规格 | 2 vCPU / 4 GB |
| estimated_monthly_saving | 预估月节省(按当前单价估算) | ¥420 |
| risk_level | 低 / 中 / 高 | 中 |
| owner | 资源负责人(来自标签) | team-pay |
| review_deadline | 复核截止日期 | 2025-07-15 |
清单生成后,先按 risk_level 分组:低风险项可直接进入变更窗口;中风险项需负责人确认;高风险项(如疑似灾备、合规相关)必须人工复核并记录保留原因。
验证与闭环
执行优化动作后,需要验证两件事:资源是否已按预期变更,以及业务是否出现异常。建议在变更后 24 小时和 7 天分别检查:
- 目标资源的规格、挂载状态、LB 后端是否与清单一致。
- 关联业务的关键指标(错误率、延迟、请求量)是否在基线范围内。
- 下一期账单中对应资源费用是否下降,下降金额与预估是否接近。
若出现业务异常,立即回滚并调整判定阈值;若费用未下降,检查是否有最低消费、预留实例或其它计费约束。