2. 按标签体系构建成本分摊模型
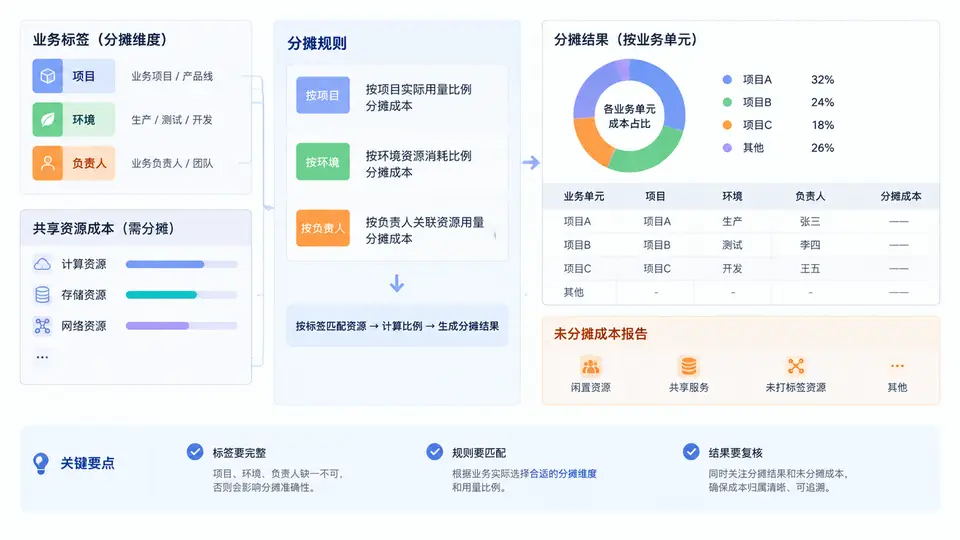
为什么共享资源必须“二次分摊”
标签体系只能把可直接归属的成本落到业务单元,例如带 project=pay、env=prod 的 ECS 实例。但真实账单里还有大量共享资源:Kubernetes 集群、NAT 网关、日志服务、监控平台、数据库集群、负载均衡器等。它们没有单一项目标签,却同时服务多个业务单元。若直接丢弃,会低估业务成本;若平均分配,又会扭曲单位经济指标。因此需要按“用量比例”把共享成本二次分摊到各业务单元。
分摊模型的三层结构
本案例把成本分成三层处理,避免把所有费用混在一起:
- 直接成本:账单行本身带
project标签,直接归属,不参与分摊。 - 共享成本:资源带
shared=true或缺少project标签,但能通过用量指标(CPU 核时、流量 GB、存储 GB·天、请求数)拆分。 - 未分摊成本:既无归属标签、又找不到合理用量驱动因子的费用,单独进入报告,不强行摊派。
分摊规则的核心是“驱动因子(driver)”。同一共享资源只能选一个主驱动因子,且该因子必须能被各业务单元量化,否则分摊结果不可审计。
分摊规则设计
下面给出一个可直接落地的规则表。每条规则把一类共享资源映射到驱动因子和用量来源:
| 共享资源类型 | 识别条件 | 驱动因子 | 用量来源 |
|---|---|---|---|
| K8s 集群节点 | service=k8s, shared=true | CPU 核时 | 命名空间 CPU request × 运行时长 |
| NAT 网关 | service=nat | 出流量 GB | VPC Flow Log 按 project 聚合 |
| 对象存储 | service=oss, shared=true | 存储 GB·天 | 按 bucket 前缀映射 project |
| 日志/监控 | service=observability | 写入量 GB | 按日志组标签聚合 |
| 数据库集群 | service=rds, shared=true | 连接数·小时 | 按库名映射 project |
分摊计算过程
以某月 K8s 集群共享成本 ¥48,000 为例,三个业务单元的 CPU 核时用量分别为:pay 12,000、order 6,000、user 2,000,合计 20,000 核时。分摊公式为:
某业务分摊额 = 共享总成本 × (该业务用量 / 全部业务用量合计)

pay   = 48000 × (12000 / 20000) = ¥28,800
order = 48000 × ( 6000 / 20000) = ¥14,400
user  = 48000 × ( 2000 / 20000) = ¥ 4,800
合计校验:28800 + 14400 + 4800 = 48000 ✓
对每条共享规则重复该计算,即可得到每个业务单元的分摊成本。最后把直接成本与分摊成本相加,得到业务单元总成本。
分摊结果与未分摊报告
分摊完成后必须做两项校验:守恒校验(各业务分摊额之和 = 共享成本总额)和覆盖率校验(已分摊 + 未分摊 = 账单总额)。未分摊成本要按原因归类,便于后续治理。
未分摊成本报告字段
未分摊成本不能只给一个总数,必须能定位原因。建议报告包含以下字段:
| 字段 | 说明 | 示例 |
|---|---|---|
| 资源ID | 账单中的资源唯一标识 | i-0a1b2c3d |
| 服务类型 | 云产品类别 | NAT 网关 |
| 金额 | 未分摊费用 | ¥3,200 |
| 未分摊原因 | 缺失标签 / 无驱动因子 / 用量数据缺失 | 无 project 标签 |
| 建议动作 | 补标签 / 接入用量采集 / 人工确认 | 补充 owner 标签 |
若某共享资源的用量数据缺失,不要用“平均分摊”兜底,否则会污染业务成本。正确做法是将其列入未分摊报告,并推动补齐用量采集。
可执行的分摊规则清单
下面是一份可直接用于配置或脚本实现的分摊规则清单,按优先级从上到下匹配:
- 账单行含
project标签 → 直接归属,不参与分摊。 - 账单行含
shared=true且服务类型在驱动因子表中 → 按对应驱动因子分摊。 - 账单行含
shared=true但无匹配驱动因子 → 进入未分摊报告,原因标记为“无驱动因子”。 - 账单行既无
project也无shared标签 → 进入未分摊报告,原因标记为“标签缺失”。 - 分摊后执行守恒校验:各业务分摊额之和必须等于共享成本总额,误差为 0。
分摊模型的价值不在于把每一分钱都摊出去,而在于让每一分钱都有可解释的去向。直接成本看标签,共享成本看驱动因子,无法解释的成本单独暴露——这三层结构才是可审计的成本分摊。