1. 云账单数据清洗与标准化
多云账单清洗的核心问题
从 AWS、Azure、阿里云等平台导出的原始账单 CSV,字段名、币种、时间格式、金额精度各不相同。直接合并会导致后续分摊计算出现重复计费、汇率错配或时间归属错误。清洗的目标是产出一张字段统一、币种统一、时间对齐、异常可追溯的标准化账单表。
字段映射与标准化规则
不同云厂商的账单字段需要映射到统一列名。以下是一份可直接使用的映射对照表(示例):
| 标准字段 | AWS 原始字段 | Azure 原始字段 | 阿里云原始字段 | 处理规则 |
|---|---|---|---|---|
| billing_date | lineItem/UsageStartDate | Date | 账单日期 | 统一为 UTC+0 的 YYYY-MM-DD |
| account_id | lineItem/UsageAccountId | SubscriptionId | 账号ID | 去空格、统一为字符串 |
| service_name | product/ProductName | MeterCategory | 产品名称 | 映射到标准服务目录 |
| region | product/Region | ResourceLocation | 地域 | 空值填 "global" |
| usage_amount | lineItem/UsageAmount | Quantity | 用量 | 转 float,负值标记异常 |
| cost | lineItem/UnblendedCost | CostInBillingCurrency | 应付金额 | 转 float,保留 6 位小数 |
| currency | lineItem/CurrencyCode | BillingCurrency | 币种 | 统一折算为 USD |
币种统一与时间对齐
币种统一需要一张汇率表,按账单日期的汇率折算,而不是用固定汇率。时间对齐的关键是:所有平台的账单日期统一转换为 UTC 零点,避免跨时区导致同一天的费用被拆到两天。
汇率折算示例:某 Azure 账单 2024-06-15 费用为 1,200 CNY,当日 USD/CNY 汇率为 7.2450,则折算后 cost = 1200 / 7.2450 ≈ 165.63 USD。若用月末汇率 7.2600,则结果为 165.29 USD,差异 0.34 USD——单条不大,但全月累计会产生显著偏差。
异常值剔除策略
- 负用量:usage_amount < 0,通常为退款或调整行,单独标记为 adjustment 而非直接删除。
- 零成本大用量:cost = 0 且 usage_amount > 0,可能是免费额度或数据缺失,需人工确认。
- 币种缺失:currency 为空时,按该账号历史币种填充;无法判断则整行隔离。
- 日期越界:billing_date 不在账单周期内,标记为 out_of_period。
不要直接 drop 异常行。正确做法是增加
quality_flag 列,保留原始数据,让后续分摊模型可以决定是否纳入。直接删除会导致总成本与云平台账单对不上。
清洗流程与数据流
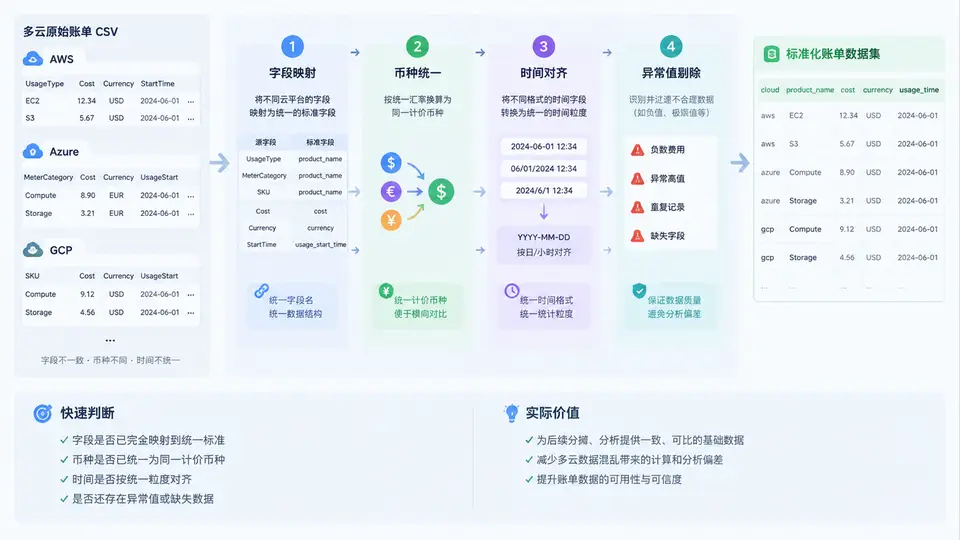
下图展示从多云原始 CSV 到标准化账单数据集的处理链路,包括字段映射、币种折算、时间对齐、异常标记四个关键环节,以及最终输出的标准列结构。
关键实现片段
以下 Python 片段展示字段映射、币种折算和异常标记的核心逻辑,可直接用于清洗脚本:
import pandas as pd

# 1. 字段映射:将各平台原始列名统一为标准列名
FIELD_MAP = {
    "lineItem/UsageStartDate": "billing_date",
    "lineItem/UsageAccountId": "account_id",
    "product/ProductName": "service_name",
    "product/Region": "region",
    "lineItem/UsageAmount": "usage_amount",
    "lineItem/UnblendedCost": "cost",
    "lineItem/CurrencyCode": "currency",
    "Date": "billing_date",
    "SubscriptionId": "account_id",
    "MeterCategory": "service_name",
    "ResourceLocation": "region",
    "Quantity": "usage_amount",
    "CostInBillingCurrency": "cost",
    "BillingCurrency": "currency",
    "账单日期": "billing_date",
    "账号ID": "account_id",
    "产品名称": "service_name",
    "地域": "region",
    "用量": "usage_amount",
    "应付金额": "cost",
    "币种": "currency",
}

def standardize_columns(df):
    df = df.rename(columns=FIELD_MAP)
    required = ["billing_date", "account_id", "service_name",
                "region", "usage_amount", "cost", "currency"]
    for col in required:
        if col not in df.columns:
            df[col] = None
    return df[required]

# 2. 币种折算:按账单日期查汇率
def convert_to_usd(df, rate_table):
    # rate_table: DataFrame with columns [date, currency, rate_to_usd]
    df = df.merge(rate_table, left_on=["billing_date", "currency"],
                  right_on=["date", "currency"], how="left")
    df["cost_usd"] = df["cost"] / df["rate_to_usd"]
    df["original_currency"] = df["currency"]
    df["original_cost"] = df["cost"]
    df["exchange_rate"] = df["rate_to_usd"]
    return df

# 3. 异常标记
def flag_quality(df):
    df["quality_flag"] = "normal"
    df.loc[df["usage_amount"] < 0, "quality_flag"] = "adjustment"
    df.loc[(df["cost"] == 0) & (df["usage_amount"] > 0), "quality_flag"] = "zero_cost"
    df.loc[df["currency"].isna(), "quality_flag"] = "missing_currency"
    return df
验证清洗结果
清洗完成后,用以下检查确认数据集可用:
- 总成本对账:按平台分别汇总 cost_usd,与云平台控制台显示的账单总额对比,差异应小于 0.5%(汇率波动导致)。
- 重复行检查:按 billing_date + account_id + service_name + region + usage_amount 分组,确认无完全重复记录。
- 币种一致性:确认 cost_usd 列全部为数值,original_currency 列无空值。
- 异常行比例:quality_flag != normal 的行占比应低于 5%;若过高,需检查映射规则或汇率表覆盖范围。
建议将清洗后的标准化账单保存为 Parquet 格式,按 billing_date 分区。这样后续分摊模型和单位经济指标计算可以直接读取,避免每次重复清洗。