4. HTTP接口健康检查与自动降级
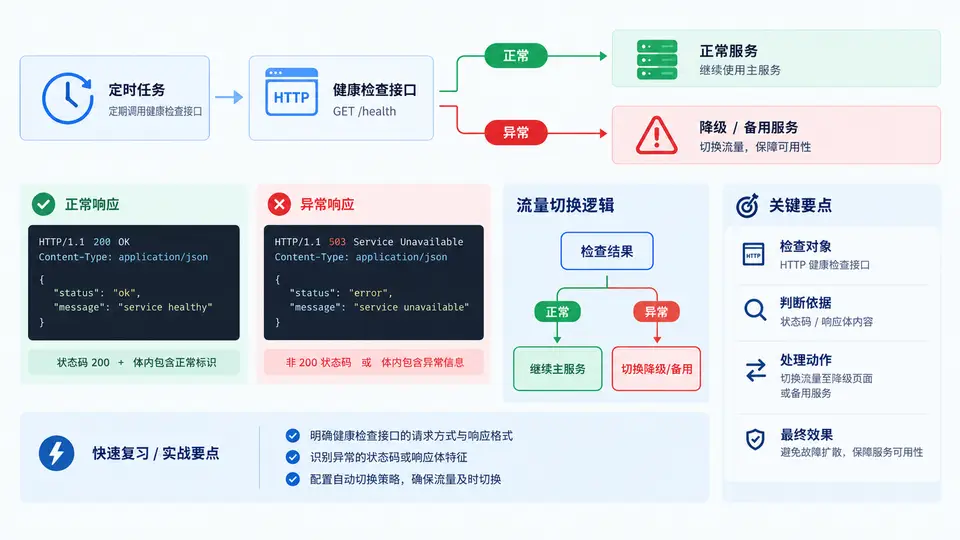
健康检查与降级切换的核心链路
本例针对一个对外提供核心业务能力的 HTTP 服务,编写自动化脚本周期性调用其健康检查接口(如 /healthz),依据 HTTP 状态码 与 响应体关键字段 双重判定服务健康度。当连续失败达到阈值时,自动将流量切换至降级页面或备用服务,并持续探测主服务,待其恢复后自动切回。
脚本实现
以下脚本使用 Python 标准库 urllib 完成 HTTP 探测,避免额外依赖。核心逻辑:每轮检查主服务健康接口,维护连续失败/成功计数器,达到阈值时执行降级或恢复动作。
#!/usr/bin/env python3
# health_check_degrade.py
import json
import time
import urllib.request
import urllib.error
import subprocess
import logging
from datetime import datetime

# ---------- 配置 ----------
PRIMARY_URL   = "http://127.0.0.1:8080/healthz"
BACKUP_URL    = "http://127.0.0.1:9090/healthz"
CHECK_INTERVAL = 10          # 秒
TIMEOUT        = 3           # 秒
FAIL_THRESHOLD = 3           # 连续失败次数触发降级
RECOVER_THRESHOLD = 3        # 连续成功次数触发恢复
RESP_TIME_LIMIT = 2.0        # 响应时间上限(秒)

# 降级/恢复命令(示例:切换 Nginx upstream 配置文件并 reload)
DEGRADE_CMD = ["sudo", "cp", "/etc/nginx/upstream_backup.conf",
               "/etc/nginx/conf.d/upstream.conf"]
RECOVER_CMD = ["sudo", "cp", "/etc/nginx/upstream_primary.conf",
               "/etc/nginx/conf.d/upstream.conf"]
RELOAD_CMD  = ["sudo", "nginx", "-s", "reload"]

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    handlers=[logging.FileHandler("health_degrade.log"), logging.StreamHandler()]
)

# ---------- 状态 ----------
fail_count = 0
success_count = 0
degraded = False

def check_health(url):
    """返回 (healthy: bool, detail: str)"""
    start = time.time()
    try:
        req = urllib.request.Request(url, method="GET")
        with urllib.request.urlopen(req, timeout=TIMEOUT) as resp:
            elapsed = time.time() - start
            code = resp.getcode()
            body = resp.read().decode("utf-8", errors="replace")

            if code != 200:
                return False, f"HTTP {code}"
            if elapsed > RESP_TIME_LIMIT:
                return False, f"响应超时 {elapsed:.2f}s > {RESP_TIME_LIMIT}s"

            try:
                data = json.loads(body)
            except json.JSONDecodeError:
                return False, f"响应体非 JSON: {body[:80]}"

            status = data.get("status", "")
            if status != "UP":
                return False, f"body.status={status}"

            return True, f"OK ({elapsed:.2f}s)"

    except urllib.error.HTTPError as e:
        return False, f"HTTPError {e.code}"
    except urllib.error.URLError as e:
        return False, f"URLError {e.reason}"
    except Exception as e:
        return False, f"Exception {e}"

def run_cmd(cmd):
    try:
        subprocess.run(cmd, check=True, capture_output=True, timeout=10)
        return True
    except Exception as e:
        logging.error("命令执行失败 %s: %s", cmd, e)
        return False

def do_degrade():
    global degraded
    logging.warning("触发降级:连续失败 %d 次,切换至备用服务", fail_count)
    if run_cmd(DEGRADE_CMD) and run_cmd(RELOAD_CMD):
        degraded = True
        logging.warning("降级完成,流量已切换至备用服务")
    else:
        logging.error("降级命令执行失败,请人工介入")

def do_recover():
    global degraded
    logging.info("触发恢复:连续成功 %d 次,切回主服务", success_count)
    if run_cmd(RECOVER_CMD) and run_cmd(RELOAD_CMD):
        degraded = False
        logging.info("恢复完成,流量已切回主服务")
    else:
        logging.error("恢复命令执行失败,请人工介入")

def main():
    global fail_count, success_count
    logging.info("健康检查启动,主服务=%s,间隔=%ds", PRIMARY_URL, CHECK_INTERVAL)

    while True:
        healthy, detail = check_health(PRIMARY_URL)

        if healthy:
            success_count += 1
            fail_count = 0
            logging.info("主服务健康: %s (连续成功 %d)", detail, success_count)
            if degraded and success_count >= RECOVER_THRESHOLD:
                do_recover()
                success_count = 0
        else:
            fail_count += 1
            success_count = 0
            logging.warning("主服务异常: %s (连续失败 %d)", detail, fail_count)
            if not degraded and fail_count >= FAIL_THRESHOLD:
                do_degrade()
                fail_count = 0

        time.sleep(CHECK_INTERVAL)

if __name__ == "__main__":
    main()
关键设计说明
- 双重判定:仅检查 HTTP 200 不够,还需解析响应体中的
status字段,防止服务返回 200 但内部状态异常(如数据库连接断开)。 - 响应时间约束:即使返回 200,若响应超过 2 秒也视为不健康,避免慢请求拖垮上游。
- 连续计数而非累计:单次抖动不触发降级,连续 3 次失败才切换,减少误判。
- 降级期间持续探测:降级后脚本不退出,继续检查主服务,连续 3 次健康后自动切回,实现闭环。
- 命令可替换:
DEGRADE_CMD/RECOVER_CMD可根据实际环境替换为修改 DNS、调整负载均衡权重、切换 Kubernetes Service 等操作。
首次部署时建议将
DEGRADE_CMD 和 RECOVER_CMD 替换为仅记录日志的空操作,观察判定逻辑是否符合预期,确认无误后再接入真实流量切换命令。
验证方法
- 启动脚本,观察日志中主服务健康时的
OK输出与连续成功计数。 - 手动停止主服务(如
kill进程或关闭端口),观察连续失败计数递增,达到 3 次后日志出现“触发降级”。 - 确认降级命令执行后,访问入口地址应返回备用服务或降级页面内容。
- 重新启动主服务,观察脚本在连续 3 次健康检查通过后自动执行恢复命令,日志出现“触发恢复”。
- 检查
health_degrade.log中是否完整记录了每次状态变化的时间、原因和动作。
降级命令涉及
sudo 和 Nginx reload,需确保运行脚本的用户具有相应权限,且配置文件路径与实际环境一致。生产环境建议配合配置管理工具(如 Ansible)或服务发现机制,避免直接操作配置文件。