2. 基于日志关键字的故障自动检测
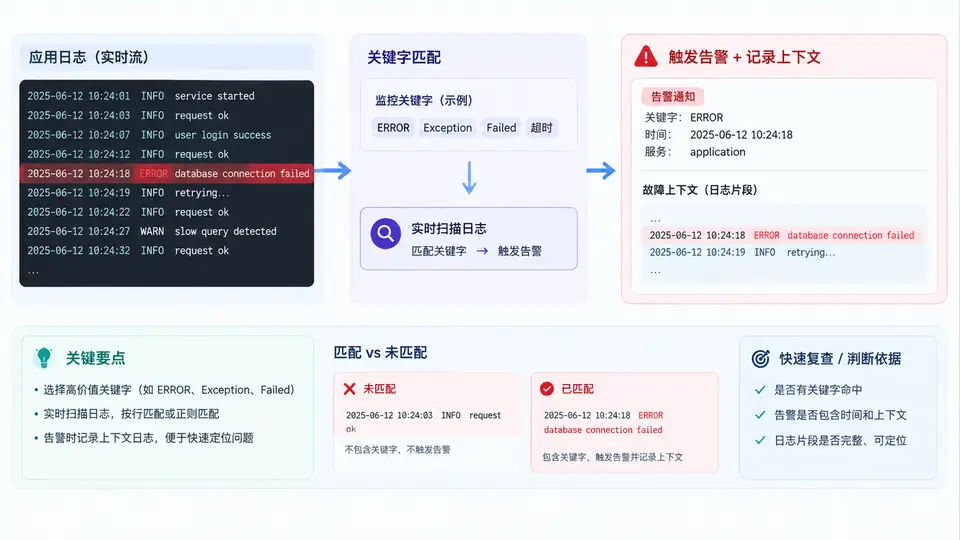
日志关键字检测的核心机制
日志驱动故障检测的本质是一条“行级过滤 + 状态判定 + 上下文捕获”的流水线。与端口巡检、HTTP 健康检查不同,它不主动探测服务,而是被动消费应用已经写出的日志行,因此检测延迟取决于日志写入频率与轮询间隔,误报则主要来自关键字过宽或上下文不足。
本案例要解决三个具体问题:如何持续读取不断增长的文件、如何判断一行是否命中故障、命中后如何保留足够定位问题的上下文。下面这张图给出了这三者的数据流关系,包括正常行被丢弃、命中行触发告警并回溯上下文的路径。
增量读取:不重复、不遗漏
日志文件会持续增长,每次从头读取既浪费又会导致重复告警。正确做法是记录上次读取到的字节偏移量(offset),每次只读取 offset 之后的新内容。Python 中可以用 open(path, 'r') 配合 seek(offset) 实现,但要注意文件被轮转(rotate)后 inode 变化,需要重新打开并重置 offset。
import os, time, re, json
from datetime import datetime

class LogWatcher:
    def __init__(self, path, keywords, context_lines=5):
        self.path = path
        self.keywords = [k.lower() for k in keywords]
        self.context_lines = context_lines
        self.offset = 0
        self.buffer = []          # 保留最近 N 行用于回溯上下文
        self.last_alert = {}      # 关键字 -> 上次告警时间,用于抑制

    def _open(self):
        self.fh = open(self.path, 'r', encoding='utf-8', errors='replace')
        self.fh.seek(self.offset)

    def _read_new_lines(self):
        lines = self.fh.readlines()
        self.offset = self.fh.tell()
        return lines

    def _match(self, line):
        low = line.lower()
        for kw in self.keywords:
            if kw in low:
                return kw
        return None

    def _should_alert(self, kw, cooldown=30):
        now = time.time()
        if now - self.last_alert.get(kw, 0) < cooldown:
            return False
        self.last_alert[kw] = now
        return True

    def _capture_context(self, hit_line, kw):
        return {
            "time": datetime.now().isoformat(timespec="seconds"),
            "keyword": kw,
            "hit_line": hit_line.rstrip(),
            "before": [l.rstrip() for l in self.buffer[-self.context_lines:]],
            "offset": self.offset,
            "file": self.path,
        }

    def run(self, interval=1.0):
        self._open()
        while True:
            lines = self._read_new_lines()
            for line in lines:
                kw = self._match(line)
                if kw and self._should_alert(kw):
                    ctx = self._capture_context(line, kw)
                    self._emit_alert(ctx)
                self.buffer.append(line)
                if len(self.buffer) > 100:
                    self.buffer.pop(0)
            time.sleep(interval)

    def _emit_alert(self, ctx):
        print(json.dumps(ctx, ensure_ascii=False, indent=2))
关键字选择与误报控制
关键字过宽会把正常日志当成故障。例如只匹配 error 会命中 error_count=0 这类正常输出。建议采用“级别词 + 异常词”组合,并明确排除白名单:
| 关键字 | 典型命中场景 | 误报风险 | 建议 |
|---|---|---|---|
| ERROR | 业务异常、连接失败 | 中 | 配合排除 error_count=0 |
| FATAL | 进程崩溃、数据库断开 | 低 | 直接告警 |
| Exception | 未捕获异常堆栈 | 低 | 直接告警 |
| Timeout | 下游超时 | 中 | 排除 timeout=0 |
| OutOfMemory | 内存溢出 | 低 | 直接告警 |
冷却窗口(cooldown)是抑制告警风暴的第一道防线。同一关键字在 30 秒内只告警一次,避免一个持续报错的服务刷出成百上千条告警。
运行与验证
启动脚本后,向被监控的日志文件追加一行包含 ERROR 的内容,观察是否在 1 秒内输出 JSON 格式的告警上下文:
# 终端 1:启动监控
python log_watcher.py

# 终端 2:模拟故障日志
echo "2024-01-01 10:03:00 ERROR connection timeout to db-01" >> app.log
预期输出应包含 keyword、hit_line、before(前 5 行)、offset 和 file 字段。若 before 为空,说明缓冲区尚未积累足够行数,属于正常现象;若同一关键字在 30 秒内重复追加却只输出一次告警,说明冷却机制生效。
文件轮转后
self.fh 仍指向旧 inode,会读不到新文件内容。生产环境应定期检查 os.stat(path).st_ino 是否变化,变化时重新打开文件并将 offset 归零。