4. 数据库连接池与云原生数据库最大连接数匹配
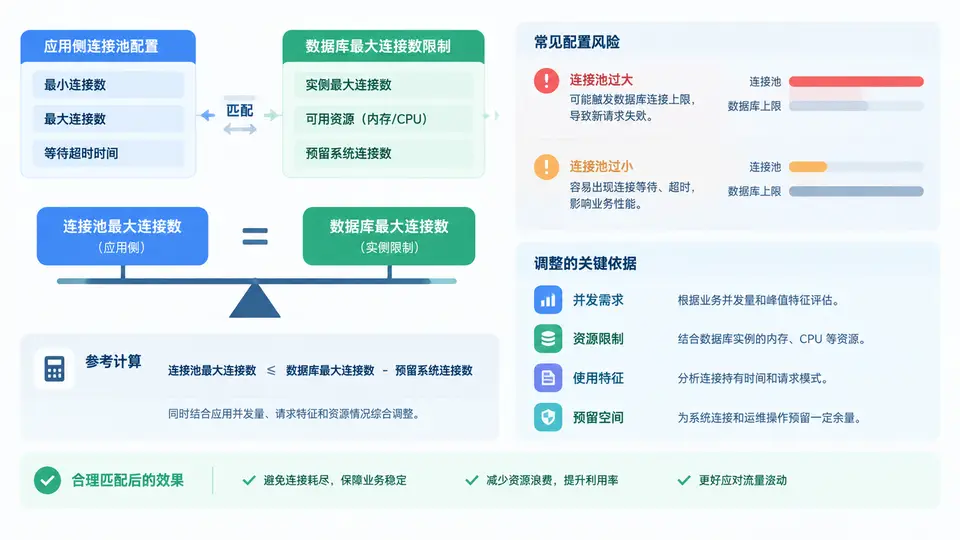
连接池与数据库连接上限的匹配关系
应用侧连接池的 maxPoolSize 决定单个应用实例最多向数据库申请多少条连接;数据库侧 max_connections 决定整个实例允许同时存在的连接总数。二者不匹配时会出现两类典型问题:连接池总和超过数据库上限,导致部分连接请求被拒绝(too many clients);连接池过小,则应用并发能力被压制,数据库连接资源闲置。
匹配的核心约束是:所有应用实例的连接池上限之和 + 运维/监控预留连接 ≤ 数据库 max_connections。云原生环境下 Pod 会动态扩缩容,因此必须按最大副本数计算,而不是当前副本数。
计算与调整步骤
- 确认数据库当前上限:查询
SHOW max_connections;和SHOW superuser_reserved_connections;,得到可用业务连接数 = max_connections − superuser_reserved_connections。 - 确认应用侧参数:读取连接池配置中的
maxPoolSize(或 maximumPoolSize),以及 HPA 的maxReplicas。 - 计算池总和:maxPoolSize × maxReplicas。若总和超过可用业务连接数,进入调整。
- 选择调整方向:优先降低 maxPoolSize(减少单实例占用),或提升 max_connections(需评估内存开销,每连接约 5–10 MB)。
- 验证:调整后查询
SELECT count(*) FROM pg_stat_activity;观察实际连接数是否在安全水位内。
示例计算:数据库 max_connections = 100,superuser_reserved = 3,可用业务连接 = 97。应用 HPA maxReplicas = 6,当前 maxPoolSize = 20,池总和 = 120 > 97。调整方案:将 maxPoolSize 降至 16,池总和 = 96 ≤ 97,留 1 条余量。或保持 maxPoolSize = 20,将 max_connections 提升至 130(需确认实例内存可支撑)。
云原生环境中 Pod 重启、滚动更新期间可能出现新旧 Pod 并存,瞬时连接数会短暂超过稳态值。建议在计算时额外预留 10%–15% 的缓冲,或设置连接池的 connectionTimeout 避免请求无限等待。
关键参数速查
| 参数 | 位置 | 含义 | 调整影响 |
|---|---|---|---|
| max_connections | 数据库 | 允许的最大并发连接总数 | 提升需更多内存,过高可能导致 OOM |
| superuser_reserved_connections | 数据库 | 为超级用户保留的连接数 | 确保运维通道可用,不参与业务计算 |
| maxPoolSize | 应用连接池 | 单实例最大连接数 | 降低可避免耗尽,但可能限制并发 |
| maxReplicas | HPA | Pod 最大副本数 | 决定池总和的上界 |