3. 云原生数据库集群初始化参数配置
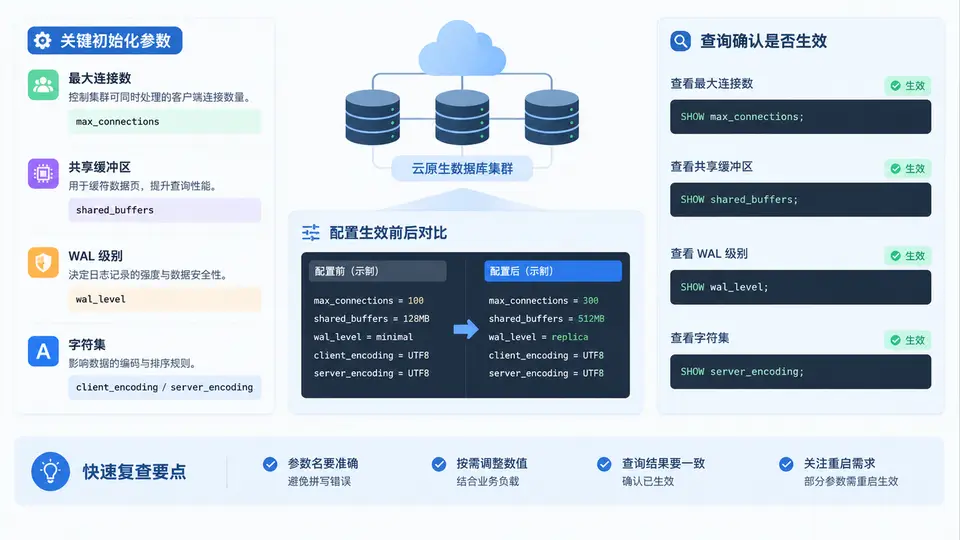
参数配置的落地对象与生效路径
云原生数据库集群的参数配置不是“改一个配置文件再重启”这么简单。以 Kubernetes Operator 托管的 PostgreSQL 集群为例,参数分为两类:一类是实例级参数(如 max_connections、shared_buffers、wal_level、client_encoding),需要写入 Operator 管理的自定义资源(CR)中,由 Operator 生成新的 postgresql.conf 并触发实例滚动重启;另一类是会话级参数,可通过 ALTER SYSTEM 或 SET 动态调整,但云原生场景下应优先通过 CR 声明,避免 Operator 调谐时覆盖手工修改。
下面这张图展示了从 CR 声明到参数生效的完整链路,以及四个关键参数各自的作用位置:
关键参数取值与配置方式
四个参数中,max_connections 和 shared_buffers 需要根据节点规格计算,wal_level 和 client_encoding 则取决于业务是否需要逻辑复制以及客户端语言环境。
| 参数 | 推荐取值 | 计算/选择依据 | 生效方式 |
|---|---|---|---|
max_connections |
200 | 预留 20% 给超级用户和复制连接;应用侧连接池总上限不超过 160 | 需重启实例 |
shared_buffers |
512MB | 取节点内存的 25%,示例节点 2GB 内存 → 512MB | 需重启实例 |
wal_level |
logical | 需要逻辑复制或 CDC 时设为 logical;仅物理复制用 replica | 需重启实例 |
client_encoding |
UTF8 | 与客户端应用字符集一致,避免乱码 | 可动态生效 |
云原生场景注意:不要直接进入 Pod 执行
ALTER SYSTEM SET max_connections = 200;。Operator 在下次调谐时会用 CR 中的值覆盖 postgresql.conf,手工修改会丢失。正确做法是修改 Cluster CR 的 spec.postgresql.parameters 字段。
通过 CR 声明参数并触发调谐
以下 YAML 片段展示了在 CloudNativePG Operator 管理的集群中声明四个关键参数的方式。修改后 Operator 会自动检测差异并滚动重启实例。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: pg-cluster
spec:
  instances: 3
  postgresql:
    parameters:
      max_connections: "200"
      shared_buffers: "512MB"
      wal_level: "logical"
      client_encoding: "UTF8"
  storage:
    size: 10Gi
    storageClass: standard
应用配置后,观察 Operator 日志确认调谐动作:
kubectl logs -l app.kubernetes.io/name=cloudnative-pg -n cnpg-system --tail=50 | grep -i "parameter\|restart"预期看到类似输出,表明 Operator 检测到参数变更并触发了实例重启:
{"level":"info","msg":"Updating PostgreSQL configuration","cluster":"pg-cluster"}
{"level":"info","msg":"Rolling restart required for parameter change","instance":"pg-cluster-1"}
{"level":"info","msg":"Instance restarted successfully","instance":"pg-cluster-1"}
参数生效验证
实例重启完成后,通过以下查询确认四个参数均已生效。注意 shared_buffers 在 pg_settings 中返回的单位是 8KB 块,需要换算:512MB ÷ 8KB = 65536。
-- 查询四个关键参数的当前生效值
SELECT name, setting, unit,
       CASE
         WHEN name = 'shared_buffers' THEN (setting::bigint * 8 / 1024)::text || ' MB'
         ELSE setting
       END AS display_value
FROM pg_settings
WHERE name IN ('max_connections','shared_buffers','wal_level','client_encoding')
ORDER BY name;
预期结果如下表所示:
| name | setting | unit | display_value |
|---|---|---|---|
| client_encoding | UTF8 | UTF8 | |
| max_connections | 200 | 200 | |
| shared_buffers | 65536 | 8kB | 512 MB |
| wal_level | logical | logical |
常见问题:如果
wal_level 仍显示 replica,说明 Operator 尚未完成滚动重启,或 CR 中的参数值未正确写入。检查 kubectl get cluster pg-cluster -o yaml 中 spec.postgresql.parameters 字段是否与预期一致,并确认所有实例 Pod 的 AGE 在配置修改之后。
配置检查清单
max_connections是否已根据节点规格和应用连接池总量计算,并预留了超级用户连接余量。shared_buffers是否设置为节点内存的 25% 左右,且未超过系统可用内存。wal_level是否与业务复制需求匹配(逻辑复制/CDC 用logical,仅物理复制用replica)。client_encoding是否与客户端应用字符集一致。- 所有参数是否通过 CR 声明而非手工
ALTER SYSTEM,避免 Operator 调谐覆盖。 - 修改后是否确认 Operator 已完成滚动重启,且所有实例的
pg_settings查询结果一致。