1. 云原生数据库部署形态选型与容量规划
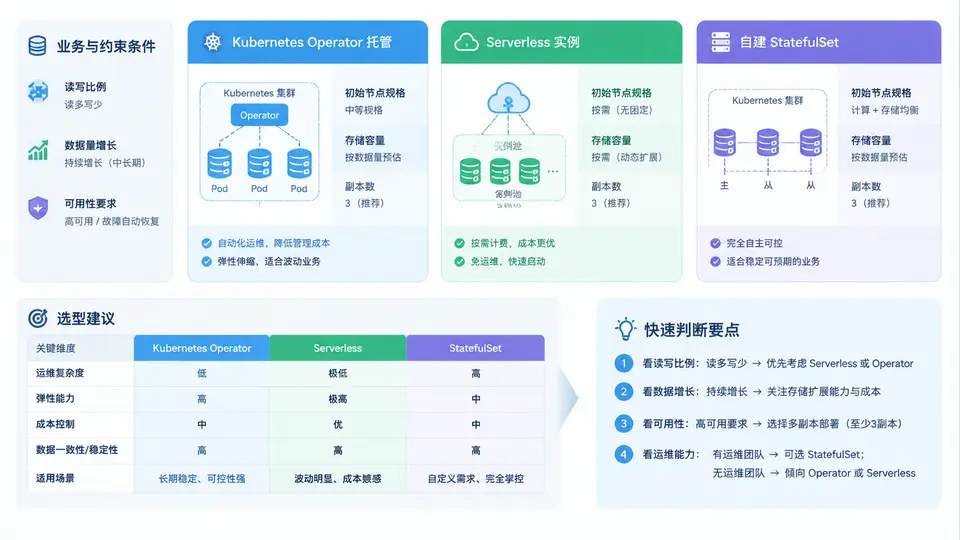
三种部署形态的决策边界
选型不是比较“哪个更先进”,而是把业务约束映射到三种形态的能力边界上。先明确三个输入维度:读写比例决定是否需要读写分离与只读副本;数据量增长曲线决定存储扩容方式与单节点容量上限;可用性要求决定副本数、故障切换时间与跨可用区拓扑。三种形态的核心差异如下:
- Kubernetes Operator 托管:Operator 负责副本编排、故障自愈、备份与版本升级,适合需要高可用但团队不想自建控制面的场景;代价是受 Operator 支持的参数与拓扑约束。
- Serverless 实例:按实际用量计费、自动扩缩容,适合负载波动大、增长曲线不确定的业务;代价是冷启动延迟、连接数上限与长事务受限。
- 自建 StatefulSet:完全掌控镜像版本、参数与调度策略,适合有特殊内核参数或合规要求;代价是自建备份、故障切换与扩缩容逻辑,运维成本最高。
容量规划计算示例
假设某订单业务:日均写入 200 万行、读取 2000 万行,读写比约 1:10;当前数据量 500 GB,年增长 60%;要求 RTO ≤ 30 秒、RPO ≈ 0。按上述决策路径,负载波动中等且需高可用,选择 Operator 托管三副本形态。容量计算如下:
| 规划项 | 计算过程 | 结果 |
|---|---|---|
| 峰值 QPS | 2000 万 ÷ 86400 ≈ 231 QPS,峰值系数 3 → 约 700 QPS | 700 QPS |
| 节点规格 | 单节点约 250 QPS,需 3 节点承载 700 QPS,每节点 4 vCPU / 16 GB | 3 × (4C/16G) |
| 存储容量 | 500 GB × 1.6(一年增长)× 3(副本)× 1.5(冗余)≈ 3600 GB | 每副本 1.2 TB |
| 副本数 | RTO ≤ 30s 要求自动切换,至少 3 副本跨 3 可用区 | 3 副本 |
若读写比进一步倾斜到 1:20 以上,应在 Operator 托管形态中额外增加只读副本,而不是简单提升单节点规格——只读副本可水平扩展读能力,成本低于纵向扩容。
Serverless 实例虽然弹性好,但需确认业务能否接受冷启动延迟(通常数百毫秒到数秒)以及单实例连接数上限。长事务、大批量导入场景不适合 Serverless。