4. 数据平台容量水位评估与扩容阈值设定
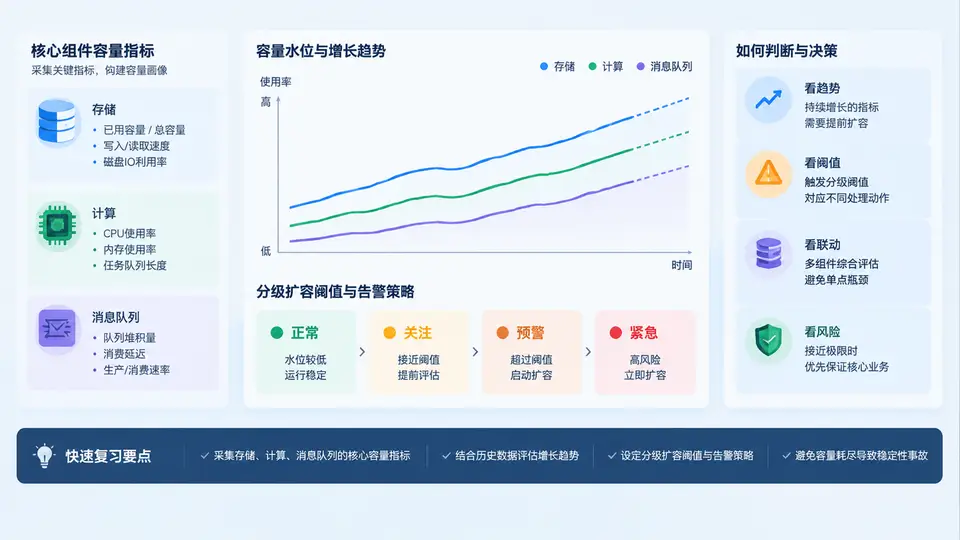
容量水位评估的核心对象与指标口径
容量水位评估不是简单看“磁盘用了百分之几”,而是对存储、计算、消息队列三类核心组件分别采集已用量、总量、增长率、峰值余量四类信息,再换算成统一的水位百分比与预计耗尽时间。评估前必须先固定口径,否则同一集群在不同人手里会得出不同结论。
- 存储:HDFS 已用容量 / 总容量;单 DataNode 磁盘使用率;小文件数量增速。
- 计算:YARN 队列已分配 vCore / 总 vCore;已分配内存 / 总内存;队列 Pending 任务数。
- 消息队列:Kafka 单 Broker 磁盘使用率;Topic 分区副本总大小;消费 Lag 增速。
水位百分比统一按 used / total × 100% 计算。增长率建议取近 7 天日均增量,并用近 30 天峰值做修正,避免被单日批量导入误导。预计耗尽天数按 (total × 安全上限 − used) / 日均增量 估算,安全上限即下文的分级阈值。
分级扩容阈值与告警策略
阈值分三级,分别对应“观察、预警、扩容”三种动作。阈值不是拍脑袋定的,而是由扩容操作所需时间倒推:如果一次扩容从申请到生效需要 3 天,那么预警线必须保证在剩余可用天数大于 3 天时触发。
| 级别 | 水位区间 | 触发动作 | 告警对象 |
|---|---|---|---|
| 正常 | < 70% | 仅记录趋势 | 无 |
| 预警 | 70% ~ 80% | 提交扩容申请,准备资源 | 平台值班 + 负责人 |
| 扩容 | 80% ~ 90% | 执行扩容,验证生效 | 平台负责人 + 业务方 |
| 紧急 | > 90% | 立即扩容 + 限流/清理 | 全员 + 升级通报 |
阈值必须与“预计耗尽天数”联合判断:水位 75% 但日均增长 5%,可能比水位 85% 但增长 0.5% 更危险。单一水位百分比不能作为唯一扩容依据。
容量水位评估与扩容决策链路
下图把采集对象、指标换算、趋势判断、阈值比对和扩容动作串成一条决策链路,重点表达“同一水位在不同增长率下会走向不同结论”这一关键判读逻辑。
采集与评估的实操要点
以 HDFS 为例,采集命令与判断逻辑如下。其他组件按同样口径替换指标来源即可。
# 1. 采集 HDFS 总容量与已用容量(单位:字节)
hdfs dfsadmin -report | grep -E "Configured Capacity|DFS Used"

# 2. 计算水位百分比(示例:已用 82TB,总量 100TB)
# 水位 = 82 / 100 × 100% = 82%

# 3. 计算日均增量(近7天)
# 第1天 78TB → 第7天 82TB,增量 4TB
# 日均增量 = 4TB / 7 ≈ 0.57TB/天

# 4. 计算预计耗尽天数(安全上限 80%)
# 可用余量 = 100 × 0.8 − 82 = −2TB(已越过扩容线)
# 结论:立即扩容,无需等待耗尽天数计算
当水位未越过扩容线时,预计耗尽天数才有意义。例如已用 72TB、总量 100TB、日均增量 0.5TB/天:可用余量 = 80 − 72 = 8TB,预计耗尽 = 8 / 0.5 = 16 天,落在 7~30 天区间,触发预警并提交扩容申请。
建议把上述采集与计算固化为每日定时任务,输出一张“组件—水位—日均增量—预计耗尽天数—当前级别”的容量日报,作为扩容决策的唯一依据,避免临时估算。
告警策略配置示例
告警不能只设一个 90% 的硬阈值,否则发现时往往已来不及扩容。按分级阈值配置多条规则,并叠加增长率条件:
| 规则 | 条件 | 告警级别 | 通知方式 |
|---|---|---|---|
| 存储预警 | HDFS 水位 ≥ 70% 且预计耗尽 ≤ 30 天 | Warning | 值班群 |
| 存储扩容 | HDFS 水位 ≥ 80% | Critical | 电话 + 群 |
| 计算预警 | YARN 队列内存分配率 ≥ 75% 持续 30 分钟 | Warning | 值班群 |
| 消息紧急 | Kafka Broker 磁盘 ≥ 85% 或 Lag 增速 > 10 万/小时 | Critical | 电话 + 群 |
告警触发后必须能回答三个问题:当前水位多少、按当前增速还能撑几天、扩容动作由谁在什么时间前完成。若无法回答,说明采集口径或阈值定义还不完整,需要回到评估链路补齐。