1. 数据平台稳定性需求分析与SLO定义
为什么稳定性要先从 SLO 开始
数据平台的稳定性不是“尽量不宕机”,而是“在业务可接受的范围内,把有限资源投入到最关键的链路上”。SLO(Service Level Objective,服务等级目标)就是把这种“可接受范围”写成可度量、可验证、可追责的规格。没有 SLO,稳定性治理会退化成救火:谁报警声音大就先修谁,容量和人力被随机分配。
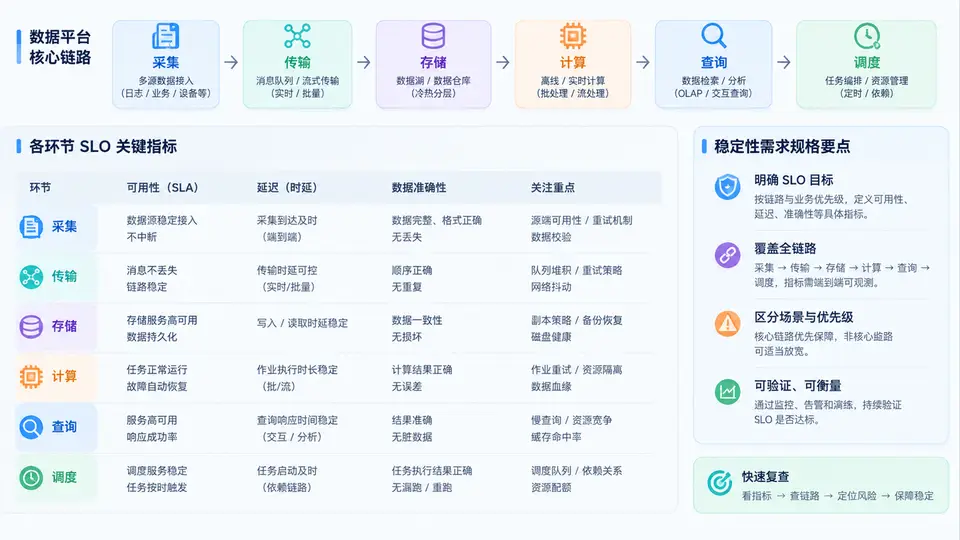
本节以一个典型电商数据平台为例,梳理六段核心链路,并为每段定义可用性、延迟、数据准确性三类 SLO,最终输出一份稳定性需求规格说明。
典型数据平台的六段核心链路
该平台从业务库和日志端采集数据,经消息队列传输,落入对象存储与数仓,再由计算引擎加工,最终通过查询服务对外提供指标,调度系统贯穿全链路。六段链路各自承担不同职责,稳定性需求也不同:
- 采集:从 MySQL binlog、应用日志、埋点 SDK 拉取或接收数据,关注采集延迟与丢数。
- 传输:Kafka 等消息队列承接削峰与解耦,关注端到端投递延迟与消息不丢。
- 存储:对象存储 + 数仓表,关注写入成功率与数据可读性。
- 计算:批处理与流计算任务,关注任务按时产出与结果正确。
- 查询:OLAP 查询服务与指标 API,关注查询响应时间与结果一致性。
- 调度:编排依赖与触发,关注调度准时率与失败重试。
从业务影响反推 SLO 目标值
SLO 目标值不能拍脑袋,要从业务影响反推。以“T+1 报表”为例:业务方要求每天 08:00 前看到昨日销售报表,那么计算链路必须在 07:30 前完成,留 30 分钟缓冲。若计算任务平均耗时 2 小时,则最晚 05:30 必须开始,倒推调度准时率必须足够高,采集和传输的延迟也必须控制在分钟级。
可用性目标同样如此。若查询服务每月不可用超过 43 分钟(99.9%),运营团队就无法在早高峰查看实时指标,因此查询链路可用性目标定为 99.9%,而存储链路因为承载所有下游,目标提高到 99.99%。
SLO 不是越高越好。99.99% 的可用性意味着每月停机不超过 4.3 分钟,每提高一个 9,成本可能翻倍。目标值应匹配业务真实容忍度,而不是追求技术极限。
稳定性需求规格说明(示例)
将上述分析整理成可评审、可验收的规格说明,是本节的核心交付物。以下为示例表格,可直接作为模板使用:
| 链路 | SLI(指标) | SLO(目标) | 测量窗口 | 业务影响 | 告警阈值 |
|---|---|---|---|---|---|
| 采集 | 采集任务成功率 | ≥ 99.9% | 滚动 7 天 | 数据缺失,报表口径不全 | 连续 2 次失败 |
| 传输 | 消息端到端延迟 P99 | ≤ 30 s | 滚动 1 小时 | 实时看板延迟 | P99 > 60 s 持续 5 min |
| 存储 | 写入可用性 | ≥ 99.99% | 自然月 | 全链路阻塞 | 写入错误率 > 0.1% |
| 计算 | 任务按时产出率 | ≥ 99.5% | 滚动 7 天 | 报表延迟,决策滞后 | 07:30 未完成 |
| 查询 | 查询响应 P95 | ≤ 3 s | 滚动 1 小时 | 运营无法实时查看 | P95 > 5 s 持续 10 min |
| 调度 | 准时触发率 | ≥ 99.5% | 滚动 7 天 | 下游任务连锁延迟 | 延迟 > 5 min 未触发 |
定义 SLO 时的三个关键判断
- 区分“强依赖”与“弱依赖”:存储是强依赖,不可用会阻塞全链路,SLO 应最严;查询是弱依赖,短时不可用只影响体验,目标可适当放宽。
- 延迟用分位数而非平均值:平均值会掩盖长尾。P95 或 P99 才能反映真实用户体验,尤其是查询和传输链路。
- 准确性要有对账机制:数据准确性 SLO 必须配套对账任务,例如每日比对源库与数仓的行数、金额汇总,差异超过阈值即触发告警。
SLO 定义完成后必须与业务方共同评审确认。技术团队单方面设定的目标,往往在故障复盘时被业务方质疑“这个目标不代表我们的需求”。评审记录应作为规格说明的附件留存。
验证 SLO 是否可落地
定义完成后,用三个问题自检:
- 每个 SLI 是否都有明确的数据来源和采集方式?例如“采集任务成功率”来自调度系统日志,“消息延迟”来自 Kafka 消费位点差值。
- 每个 SLO 是否都有对应的告警规则和责任人?没有责任人的 SLO 只是文档。
- 测量窗口是否合理?滚动 7 天适合波动较大的链路,自然月适合存储这类需要长期观察的链路。
完成以上步骤后,即可输出一份可评审的稳定性需求规格说明,作为后续风险清单、依赖拓扑和容量规划的共同基线。