3. 数据平台关键链路依赖拓扑绘制与脆弱点标注
为什么需要端到端依赖拓扑
数据平台的稳定性事故很少由单个组件“自己坏掉”引发,更多是依赖链上的传导:上游数据源延迟 → 同步调用阻塞采集线程 → 消息积压 → 下游计算任务超时 → 报表不可用。要定位这类问题,必须先把“谁依赖谁、怎么依赖、依赖有多强”画成一张可判读的拓扑图,再在图上标注脆弱点与环路。
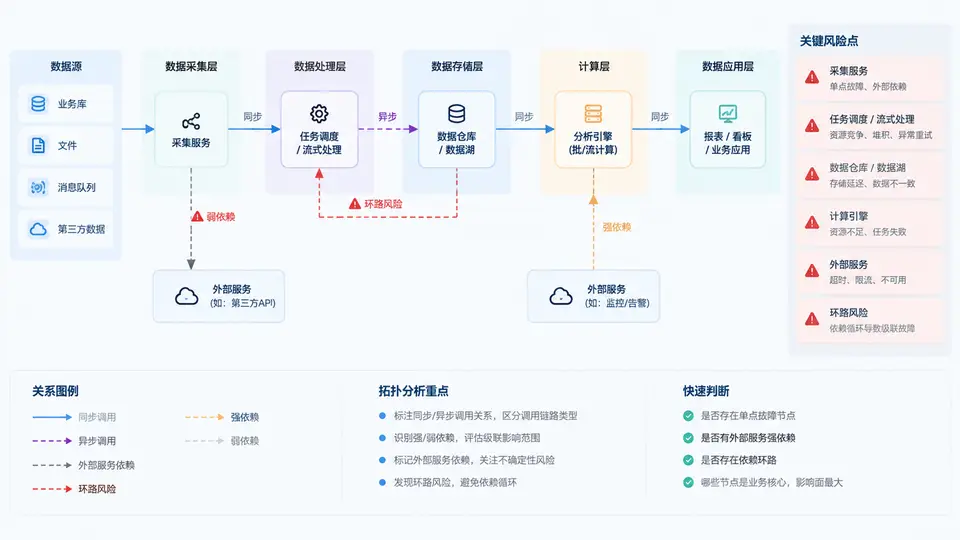
本案例以一个典型离线+实时混合数据平台为对象,绘制从数据源到数据应用的端到端依赖拓扑,并完成三类标注:调用方式(同步/异步)、依赖强度(强/弱)、外部服务依赖,最后识别脆弱节点与环路风险。
拓扑建模的四个要素
- 节点:数据源、采集/同步组件、消息队列、存储、计算引擎、调度器、查询服务、数据应用、外部服务。
- 边:表示依赖方向,箭头由“被依赖方”指向“依赖方”或按调用方向统一约定,本图统一为调用/数据流方向(上游 → 下游)。
- 边属性:同步(实线)/异步(虚线);强依赖(粗线)/弱依赖(细线);外部依赖(红色描边)。
- 风险标记:脆弱节点用橙色警示标,环路用红色回边标出。
约定:图中箭头方向 = 数据/调用流向(上游指向下游)。同步调用意味着上游阻塞等待下游返回,下游故障会立即向上游传导;异步调用通过消息队列解耦,下游故障表现为积压而非立即失败。
端到端依赖拓扑与脆弱点标注
拓扑判读与脆弱点识别方法
拿到这张图后,按以下顺序判读,即可快速定位风险:
- 找同步强依赖链:沿实线粗箭头追踪。图中“业务库 → CDC 采集器 → Kafka”中,CDC 到业务库是同步读取,业务库慢查询会直接拖慢采集;而“HDFS → Spark → BI 报表”是同步强依赖,Spark 任务失败会立即导致报表不可用。
- 找异步解耦点:虚线箭头处是缓冲层。Kafka 把采集与计算解耦,下游故障表现为 lag 增长而非立即报错,这是稳定性设计中的“减震器”。
- 找外部依赖:红色边“第三方 API → API 拉取任务”是外部服务依赖,其可用性不受平台控制,必须配置超时、重试与降级。
- 找脆弱节点:橙色警示标节点满足“被多条链路共享”或“单点部署”特征。Kafka、ClickHouse、Airflow 均被多个下游共享,一旦故障影响面呈扇出放大。
- 找环路:粉色回边表示调度器与计算之间的环路依赖——调度器触发 Spark 任务,而 Spark 任务产出又反过来决定下一次调度触发条件。环路会导致故障时无法确定恢复起点,必须打破。
环路风险的本质:当 A 依赖 B、B 又依赖 A 时,任一环节故障都会让恢复流程陷入“等对方先恢复”的死锁。治理方式通常是引入人工确认节点、设置超时熔断,或将环路中的一条边改为异步事件通知。
脆弱点标注清单(可直接用于评审)
| 节点/边 | 依赖类型 | 脆弱特征 | 影响面 | 建议动作 |
|---|---|---|---|---|
| Kafka 集群 | 异步(弱依赖) | 单集群共享、无跨集群容灾 | 实时+离线全链路积压 | 评估多集群/镜像容灾,设置 lag 告警 |
| ClickHouse | 同步(强依赖) | BI 与大屏共用、慢查询互相影响 | 报表与实时大屏同时不可用 | 读写分离或资源组隔离,设置查询超时 |
| Airflow 调度器 | 同步(强依赖) | 单点部署、与计算存在环路 | 全部批处理任务停摆 | 主备切换,打破环路依赖 |
| 第三方 API | 外部依赖 | 不可控、无降级 | API 拉取任务阻塞 | 配置超时/重试/熔断,准备本地缓存兜底 |
| 调度器 ↔ Spark | 环路 | 双向依赖,恢复起点不明确 | 故障恢复困难 | 改为事件驱动单向通知 |
绘制与维护建议
- 拓扑图应随架构变更同步更新,建议纳入变更评审流程,避免“图与真实依赖脱节”。
- 同步/异步、强/弱依赖的标注必须与真实调用方式一致,否则会误导故障定位方向。
- 脆弱节点标注不是一次性工作,每次故障复盘后应回填新的脆弱点与环路。
- 可结合链路追踪数据自动生成依赖边,减少人工维护成本。