4. ReplacingMergeTree去重表设计与验证
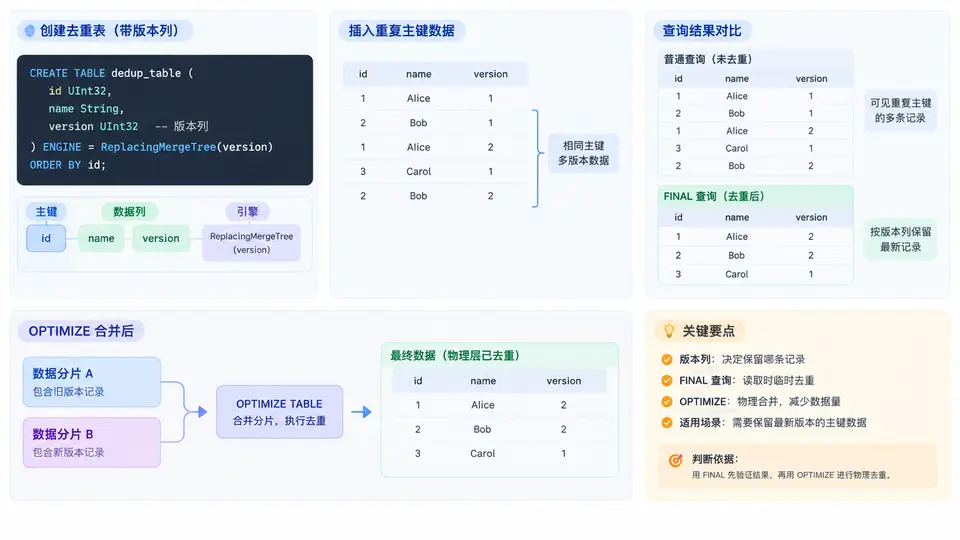
ReplacingMergeTree 的版本语义与去重时机
ReplacingMergeTree 在后台合并分区内的数据片段时,会按 ORDER BY 键(即排序键)识别重复行,并保留版本列值最大的那一行。如果建表时指定了 ver 列,则版本大的胜出;未指定版本列时,保留最后插入的那一行。需要特别注意的是:去重只发生在后台合并时,且只在单个分区内进行,查询时未合并的重复行仍然可见。
建表与验证操作
下面创建一个带版本列的 ReplacingMergeTree 表,插入同一主键的多版本数据,然后分别用普通查询、FINAL 查询和 OPTIMIZE 后的查询验证去重效果。
-- 1. 建表:以 user_id 为排序键,ver 为版本列
CREATE TABLE user_replacing
(
    user_id   UInt32,
    name      String,
    city      String,
    ver       UInt32
)
ENGINE = ReplacingMergeTree(ver)
ORDER BY user_id;

-- 2. 插入同一 user_id 的三条不同版本数据
INSERT INTO user_replacing VALUES
(101, 'Alice',  'Beijing',  1),
(101, 'Ally',   'Shanghai', 2),
(101, 'Alicia', 'Shenzhen', 3);

-- 3. 未合并时查询:三条都可见
SELECT * FROM user_replacing WHERE user_id = 101;
-- 结果:3 行(ver=1,2,3)

-- 4. FINAL 查询:查询时实时去重
SELECT * FROM user_replacing FINAL WHERE user_id = 101;
-- 结果:1 行(ver=3, name=Alicia, city=Shenzhen)

-- 5. 手动触发合并
OPTIMIZE TABLE user_replacing FINAL;

-- 6. 合并后普通查询:重复行已被物理清除
SELECT * FROM user_replacing WHERE user_id = 101;
-- 结果:1 行(ver=3, name=Alicia, city=Shenzhen)
验证要点:步骤 3 返回 3 行说明去重尚未发生;步骤 4 返回 1 行说明 FINAL 在查询时按版本列正确裁决;步骤 6 返回 1 行说明 OPTIMIZE 已触发后台合并并物理去重。三步结果对比即可确认 ReplacingMergeTree 的去重行为符合预期。
注意事项:ReplacingMergeTree 的去重只在单个分区内生效。如果建表时使用了分区键(如
PARTITION BY toYYYYMM(create_time)),跨分区的相同排序键不会被去重。此外,后台合并时机由 ClickHouse 自主调度,不保证实时性,对去重有强实时要求的场景应在查询时使用 FINAL。