3. MergeTree引擎建表与分区键设计
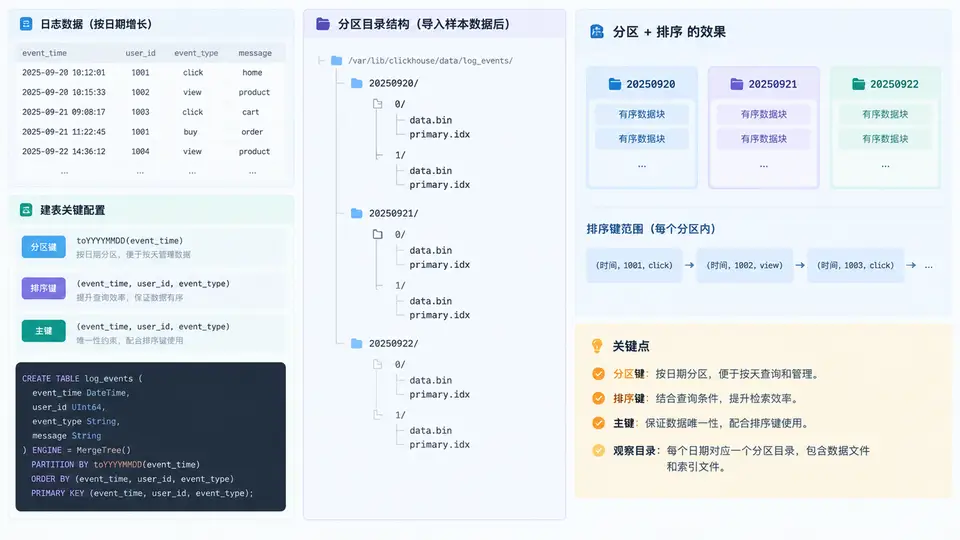
为什么日志表的分区键不能随便选
日志数据按天持续写入,如果分区键选得过细(例如按小时),分区数量会迅速膨胀;选得过粗(例如按月),单分区数据量过大,查询时无法有效裁剪。对“按日期增长的日志”这类场景,分区键通常取日期粒度(toYYYYMM 或 toDate),排序键则按“先过滤维度、后时间”的顺序排列,让高频查询条件落在主键前缀上。
建表语句与关键参数
下面针对日志表 app_log 给出完整建表语句。分区键使用 toYYYYMM(event_time) 按月分区,排序键使用 (service_name, event_time),让按服务名过滤的查询能命中主键前缀。
CREATE TABLE app_log
(
    event_time   DateTime,
    service_name LowCardinality(String),
    level        LowCardinality(String),
    message      String,
    trace_id     String
)
ENGINE = MergeTree()
PARTITION BY toYYYYMM(event_time)
ORDER BY (service_name, event_time)
SETTINGS index_granularity = 8192;
设计要点:分区键用
toYYYYMM 而非 toDate,是因为日志按月增长时,月分区数量可控(一年 12 个),而按天分区一年会产生 365 个分区,元数据开销和合并压力都会明显上升。排序键把 service_name 放在 event_time 前面,是因为日志查询通常先按服务名过滤,再按时间范围筛选。
导入样本数据并观察分区目录
插入跨两个月的样本数据,然后查看分区目录结构,验证分区键是否按预期切分。
INSERT INTO app_log VALUES
('2024-01-15 08:30:00', 'order-service', 'INFO',  'order created',   't-001'),
('2024-01-20 14:12:00', 'order-service', 'ERROR', 'payment timeout', 't-002'),
('2024-02-03 09:45:00', 'user-service',  'INFO',  'user login',      't-003'),
('2024-02-11 22:05:00', 'user-service',  'WARN',  'slow query',      't-004'),
('2024-02-28 16:30:00', 'order-service', 'INFO',  'order shipped',   't-005');
查询分区信息:
SELECT
    partition,
    name,
    rows,
    bytes_on_disk
FROM system.parts
WHERE table = 'app_log' AND active = 1
ORDER BY partition;预期结果中会出现两个分区:202401 和 202402。每个分区对应一个独立目录,目录名格式为 202401_1_1_0(分区ID_最小块号_最大块号_层级)。
验证要点:执行
SELECT partition, rows FROM system.parts WHERE table='app_log' AND active=1,应看到 202401 分区 2 行、202402 分区 3 行。如果分区数量与预期不符,检查 PARTITION BY 表达式是否与插入数据的时间字段匹配。
分区键与排序键的常见误用
| 误用方式 | 问题 | 正确做法 |
|---|---|---|
| PARTITION BY toDate(event_time) | 按天分区,一年 365 个分区,元数据膨胀 | 按月分区 toYYYYMM(event_time) |
| ORDER BY (event_time, service_name) | 时间在前,按服务名过滤无法命中主键前缀 | 高频过滤维度放前面 |
| PARTITION BY service_name | 分区数随服务数量增长,且时间范围查询无法裁剪 | 分区键用时间,服务名放排序键 |
| ORDER BY 与 PRIMARY KEY 不一致且未显式指定 | 主键默认取 ORDER BY 前缀,可能不符合预期 | 显式声明 PRIMARY KEY 或保持默认一致 |
注意:分区键一旦建表后修改成本很高,需要重建表并迁移数据。设计阶段应结合数据增长速度和查询模式确定分区粒度,日志类数据通常按月或按周分区,避免按天或按小时。