4. 材料工艺参数编码与标准化
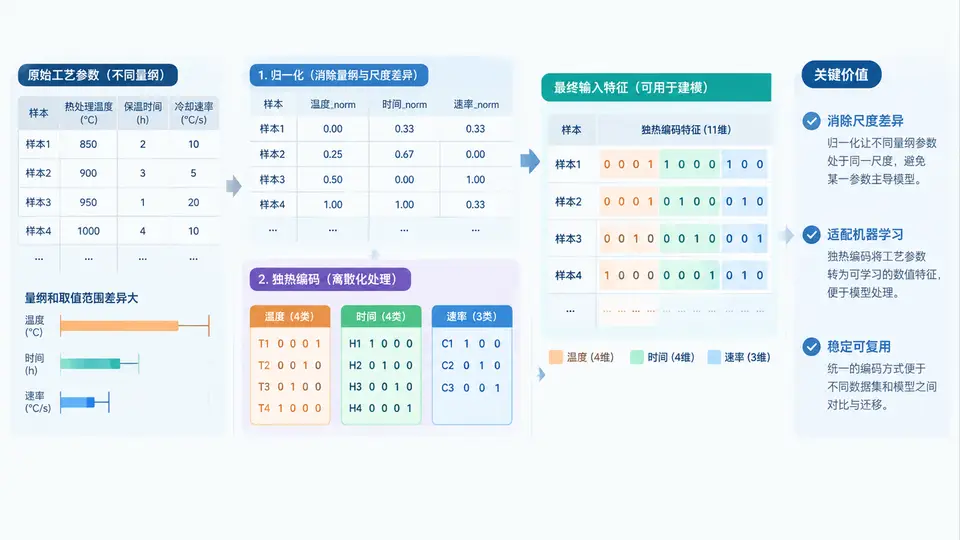
为什么工艺参数不能直接喂给模型
热处理工艺参数天然带有不同量纲:温度是 800–1250 ℃ 的连续量,保温时间是 0.5–24 h 的连续量,冷却速率跨越 0.01–200 ℃/s 数个数量级,而冷却方式(炉冷/空冷/油淬/水淬)是类别量。若直接拼接成特征矩阵,温度会因数值大而主导距离计算,冷却速率会因长尾分布被压缩,类别量则会被误当作有序数值。本节的任务是把这三类参数分别映射到统一尺度,并保留工艺语义。
三类参数的编码策略
- 温度、保温时间:量纲一致、分布近似单峰,采用 Min-Max 归一化到 [0,1],保留相对位置。
- 冷却速率:跨 4 个数量级,先取 log10 再 Min-Max,避免小速率区间被挤压。
- 冷却方式:无序类别,采用独热编码(One-Hot),生成 4 个 0/1 列,避免引入虚假序关系。
归一化公式:x' = (x − x_min) / (x_max − x_max)。注意 x_min/x_max 必须来自训练集统计量,并保存下来用于测试集与线上推理,否则会造成数据泄漏。
用 Python 完成编码
下面代码基于 pandas 与 scikit-learn,输入是一张含工艺列的合金数据表,输出是编码后的特征矩阵与可复用的变换器。
import numpy as np
import pandas as pd
from sklearn.preprocessing import MinMaxScaler, OneHotEncoder

# 示例数据:温度(℃)、保温时间(h)、冷却速率(℃/s)、冷却方式
df = pd.DataFrame({
    "T":     [850, 1050, 920, 1180, 760, 1000],
    "t":     [2.0, 6.0, 1.5, 12.0, 0.5, 8.0],
    "v":     [0.05, 30.0, 1.2, 150.0, 0.01, 8.0],
    "cool":  ["炉冷", "油淬", "空冷", "水淬", "炉冷", "空冷"],
})

# 1) 连续量:温度、时间直接 Min-Max
num_cols = ["T", "t"]
scaler_num = MinMaxScaler()
X_num = scaler_num.fit_transform(df[num_cols])

# 2) 冷却速率:先 log10 再 Min-Max
v_log = np.log10(df[["v"]].values)
scaler_v = MinMaxScaler()
X_v = scaler_v.fit_transform(v_log)

# 3) 冷却方式:独热编码
enc = OneHotEncoder(sparse_output=False, categories=[["炉冷","空冷","油淬","水淬"]])
X_cat = enc.fit_transform(df[["cool"]])

# 4) 拼接为统一特征矩阵
X = np.hstack([X_num, X_v, X_cat])
cols = num_cols + ["v_log_norm"] + list(enc.get_feature_names_out(["cool"]))
X_df = pd.DataFrame(X, columns=cols)
print(X_df.round(3))
运行后得到 6 行 × 7 列的特征矩阵:温度、时间、冷却速率均落在 [0,1],冷却方式展开为 4 个 0/1 列。例如水淬样本的 cool_水淬=1,其余三列为 0。
关键检查点
| 检查项 | 判断标准 | 常见错误 |
|---|---|---|
| 连续量范围 | 所有归一化列 ∈ [0,1] | 用全量数据 fit,造成泄漏 |
| 冷却速率分布 | log 变换后近似对称 | 直接归一化导致小速率被压缩 |
| 独热列数 | 等于类别数(4 列) | drop='first' 后列数不匹配 |
| 变换器复用 | 测试集用训练集 scaler | 测试集重新 fit,尺度漂移 |
若后续模型是树模型(如随机森林),归一化对分裂点不敏感,但独热编码仍必要;若模型是线性回归或神经网络,则归一化与 log 变换都会显著影响收敛与系数解释。
冷却速率为 0 或负值(如炉冷近似 0.01 ℃/s)时,log10 前需确认无 0 值;若存在 0,应先加极小量 eps 或改用其他变换,否则会产生 -inf。