2. 材料数据清洗与缺失值处理
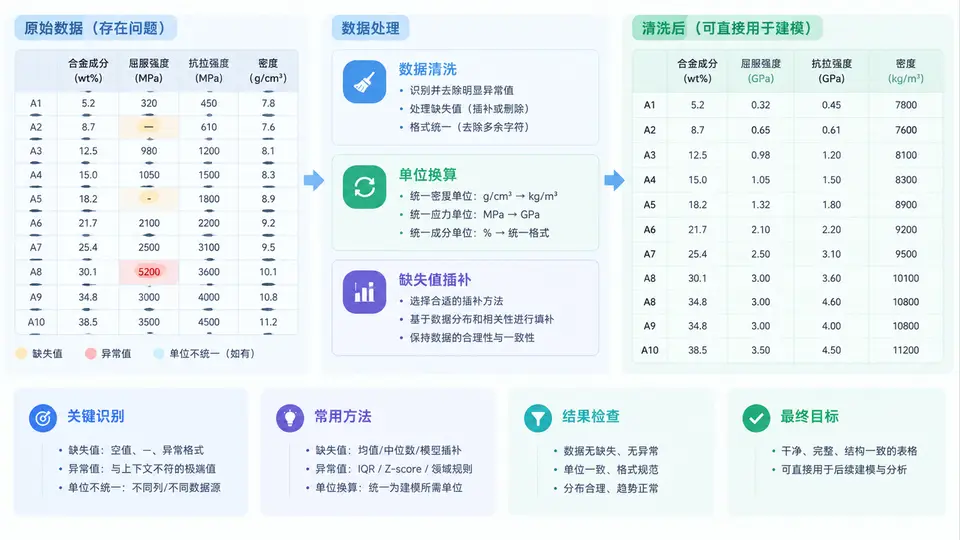
任务对象与数据问题
本节使用一份包含 12 条记录的镍基高温合金性能数据集,字段包括:alloy_id、Cr_wt%、Co_wt%、Mo_wt%、Ti_wt%、Al_wt%、solution_T_C、aging_T_C、aging_h、YS_MPa、UTS_MPa、elong_%。数据中存在三类典型问题:
- 缺失值:
Co_wt%、Mo_wt%、YS_MPa、elong_%等列存在空值。 - 异常值:
YS_MPa出现 9999 的占位值,aging_h出现负值,elong_%出现 250 的明显越界值。 - 单位不统一:
solution_T_C与aging_T_C部分记录以 K 为单位填写(如 1273、1173),需统一换算为 ℃。
清洗与插补流程
整体处理链为:读取原始表 → 单位统一 → 异常值识别与修正 → 缺失值插补 → 输出干净表。单位换算采用 T(℃) = T(K) - 273.15,对温度列中大于 1000 的值判定为 K 并换算。异常值处理策略:YS_MPa 中 9999 视为缺失后插补;aging_h 负值取绝对值;elong_% 大于 100 视为缺失后插补。缺失值插补采用按合金体系分组的中位数插补,对成分列用全体中位数,对性能列用同 Cr_wt% 分档的中位数,避免不同体系间差异被抹平。
Python 实现
以下代码可直接运行,输入为 raw_alloy.csv,输出为 clean_alloy.csv。代码中同时打印每列插补数量,便于核对处理结果。
import pandas as pd
import numpy as np

# 1. 读取原始数据
df = pd.read_csv("raw_alloy.csv")
print("原始形状:", df.shape)
print("原始缺失:\n", df.isna().sum())

# 2. 单位统一:温度列中 >1000 的视为 K,换算为 ℃
for col in ["solution_T_C", "aging_T_C"]:
    mask_k = df[col] > 1000
    df.loc[mask_k, col] = df.loc[mask_k, col] - 273.15
    print(f"{col} 换算 K→℃ 条数: {mask_k.sum()}")

# 3. 异常值处理
# YS_MPa 中 9999 为占位异常值,置为 NaN
df.loc[df["YS_MPa"] == 9999, "YS_MPa"] = np.nan
# aging_h 负值取绝对值
df["aging_h"] = df["aging_h"].abs()
# elong_% 大于 100 视为越界,置为 NaN
df.loc[df["elong_%"] > 100, "elong_%"] = np.nan

# 4. 缺失值插补
# 4.1 成分列用全体中位数
comp_cols = ["Cr_wt%", "Co_wt%", "Mo_wt%", "Ti_wt%", "Al_wt%"]
for col in comp_cols:
    if df[col].isna().any():
        median_val = df[col].median()
        df[col] = df[col].fillna(median_val)
        print(f"{col} 中位数插补: {median_val:.3f}")

# 4.2 性能列按 Cr 含量分档中位数插补
df["Cr_bin"] = pd.cut(df["Cr_wt%"], bins=[0, 15, 20, 25, 100],
                      labels=["低Cr", "中Cr", "高Cr", "超高Cr"])
perf_cols = ["YS_MPa", "UTS_MPa", "elong_%"]
for col in perf_cols:
    if df[col].isna().any():
        df[col] = df.groupby("Cr_bin", observed=True)[col].transform(
            lambda s: s.fillna(s.median())
        )
        # 若某档全空,回退到全体中位数
        df[col] = df[col].fillna(df[col].median())

# 5. 记录插补标记
df["imputed_flag"] = df[["YS_MPa", "UTS_MPa", "elong_%",
                          "Co_wt%", "Mo_wt%"]].isna().any(axis=1).astype(int)

# 6. 输出干净表
df = df.drop(columns=["Cr_bin"])
df.to_csv("clean_alloy.csv", index=False)
print("清洗后形状:", df.shape)
print("清洗后缺失:\n", df.isna().sum())
print("输出文件: clean_alloy.csv")
结果判读与验证
运行后应满足以下条件,方可认为清洗完成:
df.isna().sum()所有列均为 0,无残留缺失。solution_T_C与aging_T_C全部落在合理 ℃ 区间(如 800–1300 ℃)。YS_MPa无 9999,aging_h无负值,elong_%全部 ≤ 100。imputed_flag为 0/1,可追溯哪些行经过插补。
若某 Cr 分档内性能列全部缺失,分组中位数会返回 NaN,代码已回退到全体中位数。实际数据中若某档样本过少(如少于 3 条),建议合并相邻档或改用全体中位数,避免插补值不稳定。
不要用 0 填充成分或性能缺失值。0 在成分中代表“不含该元素”,在性能中代表“无强度”,都会引入严重偏差。中位数插补是保守且可解释的基线策略,后续建模时可通过
imputed_flag 做敏感性分析。