2. XRD 基线扣除与背景拟合对比
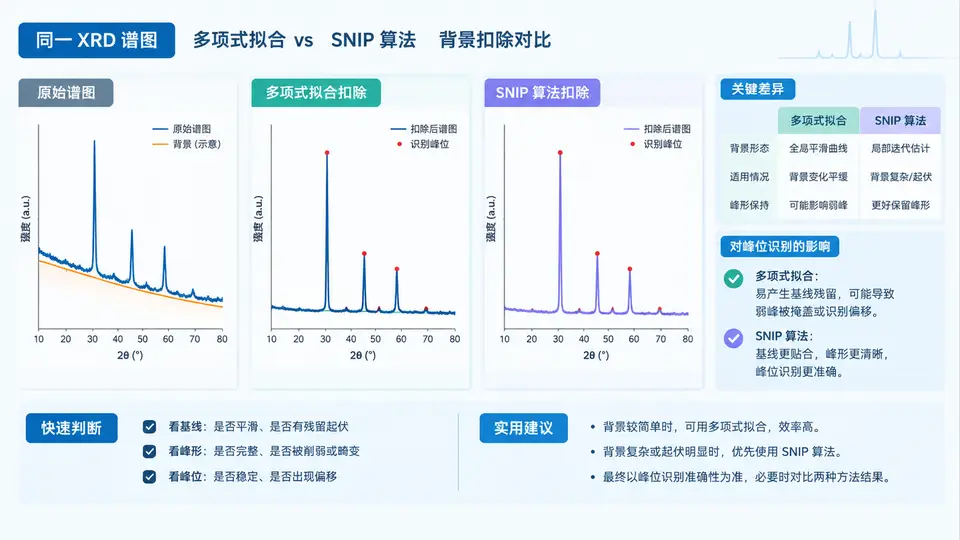
为什么同一张谱图会有两种“背景”
XRD 谱图的实测强度可以写成:
I实测(2θ) = I衍射峰(2θ) + I背景(2θ) + 噪声
背景来源包括样品自身非晶散射、空气散射、样品架与狭缝杂散辐射、探测器本底等。背景扣除的目标是估计出 I背景(2θ) 并从实测谱中减去,使后续寻峰算法面对的是“峰 + 残余噪声”,而不是“峰 + 缓慢起伏基线”。
本例使用同一张已清洗的两列谱图(2θ 与强度),分别用多项式拟合和 SNIP 算法扣除背景,再比较两者对峰位识别的影响。两种方法的本质差异是:多项式拟合用一条低阶曲线去“贴合”背景,SNIP 则用迭代统计的方式逐点估计背景上限。
两种背景估计方法的原理与参数
| 方法 | 核心思想 | 关键参数 | 适用场景 |
|---|---|---|---|
| 多项式拟合 | 在无峰区间选点,拟合低阶多项式作为背景 | 多项式阶数 n、选点区间 | 背景平缓、峰区分布稀疏 |
| SNIP | 对谱做 LLS 变换后迭代削峰,得到背景估计 | 迭代次数 m、窗口宽度 w | 背景起伏复杂、峰密集 |
多项式阶数过高会把宽峰“吃掉”,阶数过低则背景残留明显;SNIP 的迭代次数过小背景估计偏高,过大则会把弱峰也削掉。两者都需要在扣除后检查峰位是否偏移、弱峰是否丢失。
实现:同一谱图跑两条背景扣除路径
下面代码假设输入为两列文本文件 xrd_clean.txt(第一列 2θ,第二列强度),已在前一例完成清洗。代码不依赖外部数据,可直接替换为自己的谱图。
import numpy as np
import matplotlib.pyplot as plt
from scipy.signal import find_peaks

# ---------- 1. 读取清洗后的两列谱图 ----------
data = np.loadtxt("xrd_clean.txt")
two_theta = data[:, 0]
intensity = data[:, 1]

# ---------- 2. 多项式背景拟合 ----------
# 在无峰区间选点:这里用低强度分位数区间作为候选背景点
def poly_background(x, y, order=5, low_frac=0.25):
    thr = np.quantile(y, low_frac)
    mask = y <= thr
    coeff = np.polyfit(x[mask], y[mask], order)
    return np.polyval(coeff, x)

bg_poly = poly_background(two_theta, intensity, order=5)
corr_poly = intensity - bg_poly

# ---------- 3. SNIP 背景估计 ----------
def snip_background(y, iterations=40, window=21):
    y = np.log(np.log(np.sqrt(np.maximum(y, 1e-6)) + 1) + 1)
    n = len(y)
    for p in range(1, iterations + 1):
        w = min(p, window)
        for i in range(w, n - w):
            y[i] = min(y[i], 0.5 * (y[i - w] + y[i + w]))
    y = (np.exp(np.exp(y) - 1) - 1) ** 2
    return y

bg_snip = snip_background(intensity.copy(), iterations=40, window=21)
corr_snip = intensity - bg_snip

# ---------- 4. 寻峰并比较峰位 ----------
def peak_positions(x, y, height_frac=0.05, distance=5):
    h = height_frac * (y.max() - y.min())
    idx, _ = find_peaks(y, height=h, distance=distance)
    return x[idx]

peaks_poly = peak_positions(two_theta, corr_poly)
peaks_snip = peak_positions(two_theta, corr_snip)

print("多项式扣除后峰位:", np.round(peaks_poly, 3))
print("SNIP 扣除后峰位:", np.round(peaks_snip, 3))

# ---------- 5. 可视化对比 ----------
fig, ax = plt.subplots(3, 1, figsize=(9, 8), sharex=True)
ax[0].plot(two_theta, intensity, color="black", lw=0.8, label="原始谱")
ax[0].plot(two_theta, bg_poly, color="tab:blue", lw=1.2, label="多项式背景")
ax[0].plot(two_theta, bg_snip, color="tab:orange", lw=1.2, label="SNIP 背景")
ax[0].legend(); ax[0].set_ylabel("强度")

ax[1].plot(two_theta, corr_poly, color="tab:blue", lw=0.8)
ax[1].plot(peaks_poly, corr_poly[np.searchsorted(two_theta, peaks_poly)],
           "v", color="tab:blue")
ax[1].set_ylabel("多项式扣除")

ax[2].plot(two_theta, corr_snip, color="tab:orange", lw=0.8)
ax[2].plot(peaks_snip, corr_snip[np.searchsorted(two_theta, peaks_snip)],
           "v", color="tab:orange")
ax[2].set_ylabel("SNIP 扣除")
ax[2].set_xlabel("2θ (°)")
plt.tight_layout()
plt.show()
结果判读:峰位偏移与弱峰保留
运行后重点看三件事:
- 峰位是否一致:两种方法给出的峰位若相差超过约 0.05°,说明背景扣除已经影响到峰形对称性,需要回查参数。
- 弱峰是否被削掉:SNIP 迭代次数偏大时,低强度峰会被当作背景削去,表现为峰数减少。
- 背景是否残留:多项式阶数偏低时,扣除后曲线仍有缓慢起伏,寻峰阈值会被抬高,导致弱峰漏检。
建议把两种扣除后的谱图叠在同一张图上,用同一组寻峰参数(峰高阈值、峰宽范围、信噪比)分别寻峰,再对比峰位列表,这样比较的是“背景扣除方法”本身,而不是寻峰参数差异。
参数调整与验证建议
若发现 SNIP 把弱峰削掉,优先减小迭代次数(如从 40 降到 20)或减小窗口宽度;若多项式扣除后背景残留明显,可提高阶数(如从 5 升到 7),但需同时检查宽峰是否被拟合掉。验证方式:用同一组寻峰参数分别处理两种扣除结果,比较峰位列表的差异;若偏差超过 0.05° 或峰数不一致,说明背景扣除参数需要重新调整。
不要用“看起来更平”作为唯一判断标准。背景扣得过狠会把弱峰一起削掉,扣得不够则寻峰阈值被抬高,两者都会导致峰位识别错误。应以峰位一致性和弱峰保留情况作为最终判据。