1. XRD 原始谱图读取与两列数据清洗
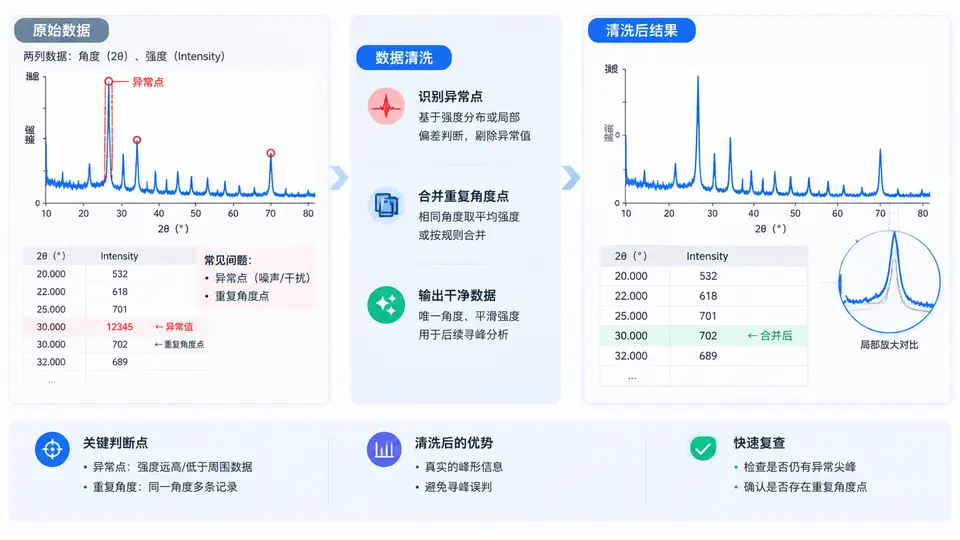
任务对象与数据形态
实验导出的 XRD 文件通常为两列:2θ(°) 与 Intensity(counts)。原始数据常见四类问题:角度重复、角度非单调、强度异常尖刺、缺失/空值。清洗目标是得到角度严格递增、无重复、无异常点的干净谱图,供后续基线扣除与寻峰使用。
清洗判定规则(示例阈值,需按仪器步长调整):
- 重复角度:同一 2θ 值出现多次 → 强度取算术平均,保留一个点。
- 非单调:若 2θ[i] ≤ 2θ[i-1],视为乱序 → 按角度升序重排。
- 异常尖刺:单点强度相对相邻中位数偏离超过
k×MAD(k 取 6~10)→ 剔除。 - 空值/非数值:直接剔除该行。
Python 实现:读取、清洗、输出
以下代码使用 numpy 与 pandas,输入为两列文本文件(空格或制表符分隔),输出为清洗后的 CSV。异常点检测采用滑动窗口中位数 + MAD 准则,对尖刺鲁棒。
import numpy as np
import pandas as pd

# ---------- 1. 读取两列数据 ----------
def load_xrd(path):
    # 自动跳过注释行,按空白分隔读取
    df = pd.read_csv(path, sep=r'\s+', comment='#', header=None,
                     names=['two_theta', 'intensity'])
    # 强制转数值,无法转换的变为 NaN
    df['two_theta'] = pd.to_numeric(df['two_theta'], errors='coerce')
    df['intensity'] = pd.to_numeric(df['intensity'], errors='coerce')
    return df

# ---------- 2. 清洗 ----------
def clean_xrd(df, k_mad=8.0, win=3):
    # 2.1 剔除空值/非数值
    df = df.dropna(subset=['two_theta', 'intensity']).copy()

    # 2.2 按角度升序排序
    df = df.sort_values('two_theta').reset_index(drop=True)

    # 2.3 合并重复角度:相同 2θ 的强度取均值
    df = df.groupby('two_theta', as_index=False)['intensity'].mean()

    # 2.4 异常尖刺剔除(滑动窗口中位数 + MAD)
    I = df['intensity'].values
    n = len(I)
    keep = np.ones(n, dtype=bool)
    for i in range(n):
        lo = max(0, i - win)
        hi = min(n, i + win + 1)
        window = I[lo:hi]
        med = np.median(window)
        mad = np.median(np.abs(window - med))
        if mad == 0:
            mad = 1e-6  # 防止除零
        if np.abs(I[i] - med) > k_mad * 1.4826 * mad:
            keep[i] = False
    df = df[keep].reset_index(drop=True)
    return df

# ---------- 3. 输出 ----------
if __name__ == '__main__':
    raw = load_xrd('xrd_raw.txt')
    clean = clean_xrd(raw, k_mad=8.0, win=3)
    clean.to_csv('xrd_clean.csv', index=False,
                 header=['two_theta', 'intensity'], float_format='%.4f')
    print(f'原始点数: {len(raw)}, 清洗后点数: {len(clean)}')
    print(f'角度范围: {clean.two_theta.min():.2f} ~ {clean.two_theta.max():.2f}')
关键参数与判读
| 参数 | 含义 | 建议取值 | 影响 |
|---|---|---|---|
k_mad | MAD 倍数阈值 | 6 ~ 10 | 过小会误删真实弱峰;过大漏删尖刺 |
win | 滑动窗口半宽 | 2 ~ 5 | 窗口越大越平滑,但可能掩盖窄峰 |
| 重复点合并 | 同角度强度处理 | 均值 | 避免后续寻峰出现虚假双峰 |
验证清洗是否合格:检查
two_theta 是否严格递增(np.all(np.diff(clean.two_theta) > 0) 为 True),并绘制清洗前后叠图确认尖刺已消失、真实峰形未被削平。
若仪器步长为 0.02°,而数据中出现 0.001° 级别的角度抖动,说明导出时精度过高或存在噪声,建议先按步长四舍五入再合并重复点,否则去重效果有限。