4. Halcon深度学习架构概览
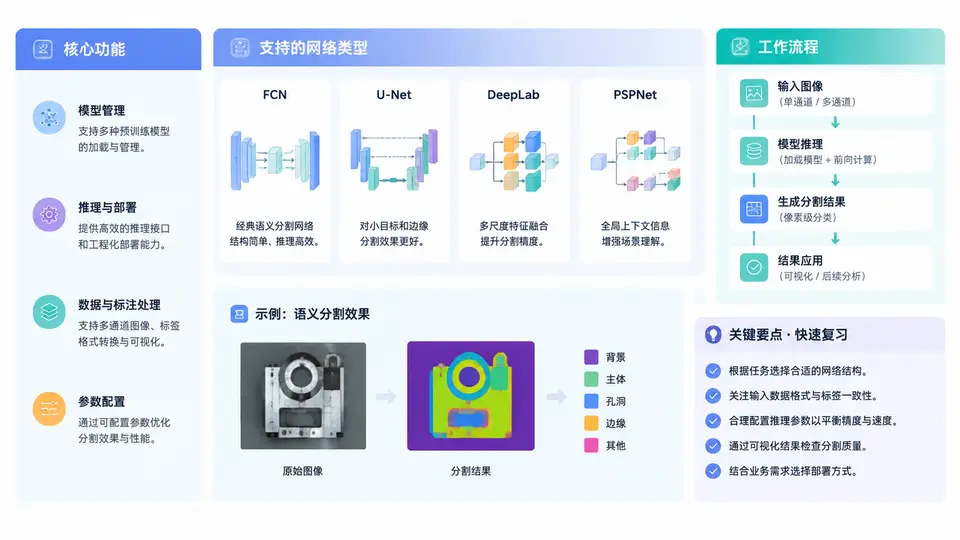
在开始编写第一行语义分割代码之前,我们必须先建立对 Halcon 深度学习架构的整体认知。Halcon 的深度学习能力并非一个孤立的“黑盒”,而是一套与经典机器视觉方法深度耦合的工程化体系。本章将系统梳理 Halcon 中深度学习模块的功能边界、支持的网络类型,以及从数据准备到模型部署的完整工作流程。理解这一架构,能帮助你在实际项目中避免“模型训练成功但无法落地”的常见困境。
4.1 深度学习模块的功能定位:不是替代,而是增强
Halcon 自 19.11 版本起将深度学习功能集成到主发行版中,其核心设计理念是:深度学习是经典视觉算法的补充,而非替代品。在 Halcon 中,深度学习模块主要承担以下三类功能:
- 目标检测(Object Detection):定位图像中物体的边界框与类别,适用于缺陷定位、零件计数等场景。
- 语义分割(Semantic Segmentation):对图像中的每个像素进行分类,输出像素级掩膜,适用于精密缺陷分割、道路区域提取等。
- 分类(Classification):对整幅图像或感兴趣区域(ROI)进行类别判定,适用于产品分拣、质量等级评定。
此外,Halcon 还提供了 异常检测(Anomaly Detection) 和 OCR/物体识别 的深度学习变体,但语义分割是其中对像素精度要求最高、训练数据标注成本也最高的任务。值得注意的是,Halcon 的深度学习模块并不提供“从零训练一个全新网络架构”的能力——它不允许你自定义网络层结构,而是让你在预定义的网络骨架(Backbone)上进行微调(Fine-tuning)或重新训练(Training from scratch,仅限特定网络)。
4.2 支持的网络类型与选择策略
Halcon 针对不同任务预置了若干网络架构,这些网络在深度、参数量和推理速度上各有取舍。对于语义分割任务,Halcon 主要提供以下两类网络:
| 网络名称 | 任务类型 | 输入尺寸(典型值) | 特点与适用场景 |
|---|---|---|---|
| DL Segmentation (U-Net 变体) | 语义分割 | 512×512 或 256×256 | 编码器-解码器结构,适合中小尺寸缺陷分割;对内存占用友好,训练速度较快。 |
| DL Segmentation (ResNet-50 编码器) | 语义分割 | 512×512 | 更深层的编码器,对复杂背景下的细小目标分割精度更高,但需要更多训练数据和显存。 |
| DL Object Detection (YOLO 变体) | 目标检测 | 512×512 | 用于缺陷定位而非像素分割,输出边界框,速度极快。 |
在实际工程中,选择网络类型不能只看精度指标。Halcon 的 read_dl_model 算子会加载预训练模型,而 set_dl_model_param 允许你调整输入尺寸、批大小等超参数。对于语义分割,输入尺寸的选择直接影响感受野与细节保留的平衡。例如,在检测 PCB 板上 0.5mm 的微小划痕时,若输入尺寸被压缩到 256×256,小目标可能仅占几个像素,导致分割掩膜断裂;而盲目增大到 1024×1024 又会显著增加显存占用和推理延迟。
4.3 标准工作流程:从数据到部署的六阶段
Halcon 的深度学习工作流程被封装为一系列高层算子,但底层逻辑遵循一个清晰的六阶段管线。理解这一管线,是后续章节所有实战操作的基础。
- 数据准备与标注:使用
read_image读取图像,通过gen_dl_segmentation_dataset创建数据集,并利用 Halcon 的标注工具(或外部导入 COCO 格式)生成像素级标签。此阶段输出为.hdict格式的字典,包含图像路径、标签路径和类别映射。 - 数据预处理与增强:调用
preprocess_dl_training_data将原始图像和标签缩放到网络输入尺寸,并执行归一化。Halcon 内置了随机裁剪、旋转、缩放等数据增强策略,通过set_dl_model_param的augmentation参数控制。 - 模型初始化与配置:使用
create_dl_model创建模型,并通过set_dl_model_param设置class_ids、batch_size、learning_rate等关键超参数。此阶段决定了训练的效率与收敛性。 - 模型训练:调用
train_dl_model执行训练。Halcon 支持在训练过程中通过get_dl_model_status实时监控损失值(loss)和验证精度(IoU)。训练产生的中间权重会自动保存为.hd5文件。 - 模型评估与优化:使用
evaluate_dl_model在验证集上计算 IoU、Dice 系数等指标。若精度不达标,可调整超参数或增加数据增强强度,重新训练。 - 模型导出与推理部署:通过
optimize_dl_model进行量化(如 INT8)和剪枝,然后使用apply_dl_model在推理阶段对单张图像执行分割。推理结果可直接转换为 Halcon 的region对象,供后续测量或决策使用。
以下是一个典型的训练配置代码片段,展示了 Halcon 中如何设置关键参数:
* 创建语义分割模型
create_dl_model ('dl_segmentation_compact.hdl', DLModelHandle)

* 设置类别ID(假设背景为0,缺陷为1)
set_dl_model_param (DLModelHandle, 'class_ids', [0, 1])

* 设置输入尺寸
set_dl_model_param (DLModelHandle, 'input_dimensions', [512, 512, 3])

* 设置批大小与学习率
set_dl_model_param (DLModelHandle, 'batch_size', 4)
set_dl_model_param (DLModelHandle, 'learning_rate', 0.0001)

* 启用数据增强(随机旋转和缩放)
set_dl_model_param (DLModelHandle, 'augmentation', 'rotation_scale')

* 开始训练,最大迭代次数为 500
train_dl_model (DLModelHandle, DLDataset, 500, 10, [], [], ExecutionMode)
4.4 案例场景:工业零件表面缺陷分割
让我们通过一个具体的案例来串联上述流程。假设我们需要检测金属垫圈表面的划痕和凹坑,图像分辨率为 1024×1024,缺陷面积最小为 50 像素。
第一步:数据准备。我们采集了 300 张正常零件图像和 300 张含缺陷图像。使用 Halcon 的标注工具逐像素绘制缺陷区域,生成标签图。由于原始图像过大,直接输入网络会导致显存溢出,因此我们在预处理阶段将图像裁剪为 512×512 的块(Patch),并确保每个 Patch 至少包含一个完整缺陷。
第二步:模型选择与训练。考虑到缺陷尺寸较小且样本量适中,我们选择 U-Net 变体网络。设置 class_ids 为 [0,1](背景与缺陷),batch_size 为 4。训练过程中,我们观察到验证 IoU 在 300 个 epoch 后达到 0.82,继续训练出现轻微过拟合(训练 loss 下降但验证 loss 上升),于是提前终止。
第三步:推理与后处理。在推理阶段,我们将测试图像分割为 512×512 的 Patch 分别推理,再将结果拼接回原图尺寸。分割掩膜输出为 region 后,我们使用 connection 算子将连通域分离,并通过 select_shape 过滤掉面积小于 50 像素的噪声区域。最终,每个缺陷区域被转换为一个独立的 region,可直接用于计算面积、周长等几何参数。
以下代码展示了推理与后处理的关键步骤:
* 读取训练好的模型
read_dl_model ('trained_segmentation.hdl', DLModelHandle)

* 读取测试图像
read_image (Image, 'test_part_01.png')

* 执行推理
apply_dl_model (DLModelHandle, Image, [], DLResult)

* 提取分割掩膜(类别1为缺陷)
get_dl_model_result (DLResult, 'segmentation', ClassMask)

* 将掩膜转换为Halcon区域
threshold (ClassMask, DefectRegion, 1, 1)

* 分离连通域并过滤小区域
connection (DefectRegion, ConnectedDefects)
select_shape (ConnectedDefects, FinalDefects, 'area', 'and', 50, 99999)

* 计算缺陷总面积
area (FinalDefects, DefectArea)
4.5 常见误区与复盘:架构理解层面的三大陷阱
在指导学员进行 Halcon 深度学习项目时,我发现以下三个架构理解层面的误区最具破坏性,它们往往导致项目在后期返工。
train_dl_model 默认会加载预训练权重(在 ImageNet 或 Halcon 内部数据集上预训练)。如果你在 create_dl_model 后直接训练,实际上是在做微调。但如果你将 set_dl_model_param 中的 init_train 设置为 from_scratch,则会随机初始化权重。对于语义分割,除非你有超过 10 万张的标注数据,否则永远不要使用 from_scratch,否则模型将难以收敛。
preprocess_dl_training_data 会将标签图同步缩放到网络输入尺寸。如果你的原始标注非常精细(例如 1 像素宽的裂纹),而输入尺寸被缩小到 256×256,那么标签中的裂纹可能被压缩成 0 像素,导致模型无法学习到该特征。务必在预处理后可视化检查标签图,确认关键特征仍然清晰可见。
area 或 min_max_gray 等算子测量会导致误差。正确的做法是:先使用 opening_circle 或 closing_circle 进行形态学平滑,再使用 gen_contour_region_xld 生成亚像素轮廓进行测量。这一步骤在 Halcon 中至关重要,因为 Halcon 的测量算子(如 measure_pos)对轮廓的平滑度高度敏感。
4.6 架构总结:Halcon 深度学习模块的工程化优势
回顾本章内容,Halcon 的深度学习架构可以概括为“预训练模型 + 高层封装 + 无缝集成”三位一体。其核心优势在于:
- 低代码门槛:所有深度学习操作均通过 HALCON 算子完成,无需编写 Python 或 C++ 代码,降低了团队的学习成本。
- 内存与显存管理自动化:Halcon 自动处理数据加载、批处理队列和显存分配,开发者无需关心底层 CUDA 调用。
- 与经典视觉算法协同:分割结果可以直接作为
region或XLD对象参与 Blob 分析、边缘提取、模板匹配等经典流程,形成完整的视觉解决方案。
但这一架构也有其局限性:不支持自定义网络层、对超参数的解释性较弱(例如 learning_rate 的调整对收敛速度的影响不如 PyTorch 中直观)、以及训练过程的可视化工具相对简陋。理解这些边界,能帮助你在面对复杂需求时,合理判断是使用 Halcon 原生模块,还是通过 Halcon 的 inference 接口集成外部 ONNX 模型。