2. 语义分割基础
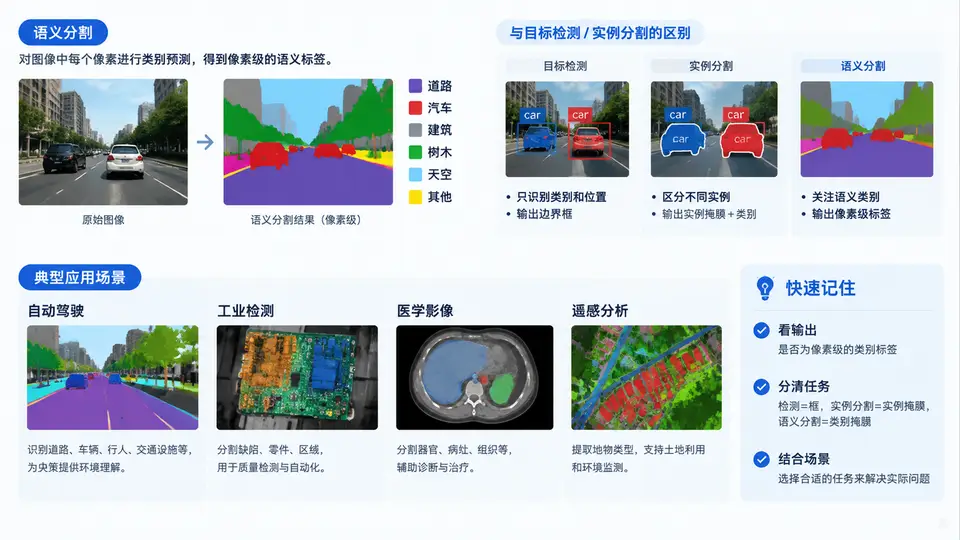
在进入 Halcon 深度学习语义分割实战之前,我们首先需要建立清晰的概念框架。语义分割(Semantic Segmentation)是计算机视觉中“像素级理解”任务的代表,它回答的问题不是“图像里有什么”,而是“图像中每一个像素属于什么类别”。本章将围绕语义分割的定义、与目标检测及实例分割的边界、典型应用场景三个核心模块展开,并给出一个贯穿全书的“像素分类”思维模型。
2.1 语义分割的定义:从“看见”到“理解”
语义分割的任务可以形式化描述为:给定一张输入图像 \( I \in \mathbb{R}^{H \times W \times 3} \),输出一个与输入同分辨率的标签图 \( S \in \{0, 1, ..., C-1\}^{H \times W} \),其中 \( C \) 是预定义的类别总数(包括背景类)。每个像素位置 \( (i, j) \) 的标签 \( S(i,j) \) 表示该像素所属的语义类别。
与图像分类(输出一个标签)和目标检测(输出若干边界框)不同,语义分割的输出是稠密的、逐像素的。这意味着模型需要对图像中的每一个点做出决策,包括物体边缘、遮挡区域、阴影部分等细节。在 Halcon 中,语义分割的输出通常以 HObject 多通道图像或 HTuple 标签数组的形式呈现,每个像素值对应一个类别 ID。
2.2 语义分割与目标检测、实例分割的边界
为了在后续章节中正确选择 Halcon 的算子(如 apply_dl_model 用于分割,find_dl_model 用于检测),我们必须清晰区分三种任务的输出粒度。下表从输出形式、目标数量、边界精度、典型 Halcon 算子四个维度进行了对比:
| 对比维度 | 语义分割 | 目标检测 | 实例分割 |
|---|---|---|---|
| 输出形式 | 像素级标签图(每个像素一个类别) | 边界框(矩形框 + 类别 + 置信度) | 像素级标签图(每个实例独立掩码) |
| 是否区分个体 | 否(所有同类像素归为一类) | 是(每个框对应一个个体) | 是(每个实例有独立掩码) |
| 边界精度 | 像素级精确(可达亚像素边缘) | 矩形框,无法贴合物体轮廓 | 像素级精确,且区分个体 |
| Halcon 典型算子 | apply_dl_model(输出 DL_SEMANTIC_SEGMENTATION) |
apply_dl_model(输出 DL_DETECTION) |
Halcon 20.11+ 支持 DL_INSTANCE_SEGMENTATION |
| 典型输出尺寸 | 与输入图像同尺寸 | 固定维度(如 4+1+类别数) | 与输入同尺寸 + 实例 ID 图 |
从信息量角度看,语义分割的输出信息密度最高,但丢失了“个体”概念。目标检测输出信息密度低,但提供了“可计数”的语义。实例分割则试图兼顾两者,但模型复杂度和训练成本也最高。在工业场景中,如果只需要判断“缺陷区域在哪里”,语义分割足够;如果需要“数清有多少个缺陷”,则需实例分割或目标检测。
2.2.1 一个直观的类比
想象你在看一张街道照片:
- 目标检测:用矩形框框出每辆车、每个人,告诉你“这里有车、有人”,但框内可能包含背景或其他物体。
- 语义分割:将图像中所有属于“车”的像素涂成红色,所有属于“人”的像素涂成绿色,背景涂成黑色。你看到的是“哪里是车”,但两辆紧挨着的车会连成一片红色。
- 实例分割:在语义分割的基础上,将第一辆车涂成红色,第二辆车涂成深红色,第三辆车涂成浅红色……每个个体有独立颜色。
在 Halcon 中,这种差异直接体现在标注工具 MVTec Deep Learning Tool 的标注界面中:语义分割使用“画笔”逐像素涂抹,目标检测使用“矩形框”拖拽,实例分割则使用“多边形 + 实例 ID”标注。
2.3 典型应用场景:工业视觉的“像素级”刚需
语义分割在工业质检、医疗影像、自动驾驶等领域有广泛应用。结合 Halcon 的强项(工业机器视觉),我们重点分析以下三类场景:
2.3.1 工业表面缺陷检测(核心场景)
在金属表面、纺织物、半导体晶圆等场景中,缺陷(划痕、凹坑、污渍)往往没有固定的形状和大小。传统规则算法(如阈值分割、Blob 分析)难以应对复杂纹理背景。语义分割模型可以逐像素判断“正常”与“缺陷”,输出缺陷的精确轮廓,便于后续测量缺陷面积、周长等参数。
// Halcon 中语义分割推理的典型代码结构(伪代码)
read_dl_model('defect_model.hdl', DLModelHandle)
read_image(Image, 'surface_01.png')
// 设置预处理参数(归一化、缩放)
create_dl_preprocess_param_from_model(DLModelHandle, 'auto', PreprocessParam)
apply_dl_model(DLModelHandle, Image, PreprocessParam, DLResult)
// 从结果中提取分割掩码
get_dl_object(DLResult, 'segmentation', SegmentationMask)
// 将掩码转换为 HObject 用于后续 Blob 分析
threshold(SegmentationMask, DefectRegion, 1, 255)该场景的典型特征是:类别不平衡严重(缺陷像素通常占比 < 1%)、缺陷形态多样、实时性要求高(通常需 < 100ms/帧)。Halcon 的 apply_dl_model 在 GPU 上对 512×512 输入可达到 5-10ms 的推理速度,满足大部分产线节拍。
2.3.2 医学影像中的器官/组织分割
在 CT、MRI 图像中分割肝脏、肿瘤、血管等结构。虽然 Halcon 在医学领域应用不如工业广泛,但其深度学习模块同样支持医学影像的预处理(如窗宽窗位调整)和分割。该场景对边界精度要求极高,且需要处理 3D 数据(Halcon 通过逐层切片方式处理)。
2.3.3 自动驾驶与遥感图像分析
道路分割、建筑物提取、植被分类等。这类场景通常类别数较多(10-30 类),且存在严重的类别不平衡(如“道路”像素远多于“行人”)。Halcon 的 train_dl_model 支持类别权重配置,可有效缓解不平衡问题。
2.4 语义分割的核心原理:编码器-解码器架构
现代语义分割模型(包括 Halcon 内置的 DL_SEMANTIC_SEGMENTATION 网络)几乎都基于编码器-解码器(Encoder-Decoder)架构。理解这一架构是后续调参的基础。
2.4.1 编码器(Encoder):下采样提取语义特征
编码器通常是一个预训练的分类网络(如 ResNet、MobileNet),通过卷积和池化逐步降低特征图分辨率,同时增加通道数。例如,输入 512×512×3 的图像,经过 5 次下采样后,特征图变为 16×16×2048。这个过程提取了从“边缘纹理”到“物体部件”再到“整体语义”的层次化特征。
2.4.2 解码器(Decoder):上采样恢复空间分辨率
解码器通过转置卷积、上采样或反池化操作,将低分辨率的特征图逐步恢复至输入分辨率。关键设计在于跳跃连接(Skip Connection)——将编码器中高分辨率的浅层特征与解码器中对应层级的特征拼接,以恢复因下采样丢失的细节信息(如边缘、小物体)。Halcon 的默认分割网络基于 U-Net 变体,正是利用了这种结构。
2.4.3 输出层:逐像素 Softmax
解码器最后一层输出一个 \( H \times W \times C \) 的得分图(Score Map),每个像素在 C 个类别上各有一个得分。通过 Softmax 函数将得分转换为概率分布,取概率最大的类别作为该像素的最终标签。Halcon 的 get_dl_object 可以同时获取概率图和标签图,便于后续的置信度分析。
// 获取分割概率图(用于后续阈值筛选)
get_dl_object(DLResult, 'segmentation_confidence', ConfidenceMap)
// ConfidenceMap 是一个 H×W×C 的多通道图像
2.5 方法流程:从数据到部署的六步法
在 Halcon 中实施语义分割项目,遵循以下标准流程。该流程将在后续章节中逐一展开,此处先建立全局视图:
- 数据采集与标注:使用
MVTec Deep Learning Tool或 Halcon 的label_dl_dataset进行像素级标注。标注质量直接决定模型上限。 - 数据预处理:包括图像缩放(通常统一到 512×512 或 256×256)、归一化(ImageNormalization)、数据增强(旋转、平移、弹性形变)。Halcon 的
create_dl_preprocess_param可自动计算均值/方差。 - 模型选择与初始化:Halcon 提供
create_dl_model创建分割网络,支持从预训练权重初始化(set_dl_model_param设置init_with_pretrained)。 - 训练与验证:使用
train_dl_model进行训练,监控损失曲线和 IoU(Intersection over Union)指标。Halcon 的evaluate_dl_model可输出混淆矩阵和逐类 IoU。 - 模型优化与压缩:通过剪枝、量化(
quantize_dl_model)减少模型体积和推理时间,适应工业 PC 的 CPU/GPU 环境。 - 部署与集成:将训练好的模型导出为
.hdl文件,在产线程序中调用apply_dl_model进行推理,并将分割结果转换为 Halcon 的HObject区域,供后续 Blob 分析、测量等传统算子使用。
2.6 典型误区与复盘:避开语义分割的“坑”
在多年项目实践中,以下误区出现频率最高,值得在课程初期就建立警惕:
check_dl_dataset 检查标注一致性。
set_dl_model_param 设置 class_weights,或使用 focal loss(需自定义损失函数)。crop_dl_dataset 可自动完成。2.6.1 复盘:一个真实的 PCB 缺陷分割案例
某 PCB 板检测项目,初始使用阈值分割算法,漏检率高达 15%。改用 Halcon 语义分割后,标注了 200 张图像(每张约 100 个缺陷),训练 50 个 epoch,最终在测试集上达到 92.3% 的 mIoU,漏检率降至 1.2%。但复盘发现:
- 模型对“划痕”类缺陷的 IoU 仅为 78%,远低于“焊点缺失”的 96%。原因是划痕在图像中对比度低,且标注时边界模糊。
- 通过增加 50 张专门包含低对比度划痕的图像,并采用 CLAHE 增强预处理,划痕 IoU 提升至 88%。
- 推理时间从最初的 45ms/帧(GPU)优化至 18ms/帧(TensorRT 加速),满足产线 30ms 节拍要求。
这个案例说明:语义分割的精度不仅取决于模型结构,更取决于数据质量、预处理策略和针对性的调优。在后续章节中,我们将逐一深入这些环节。
2.7 本章小结
语义分割是像素级分类任务,输出与输入同分辨率的标签图。它与目标检测(输出边界框)和实例分割(输出个体掩码)有本质区别,选择哪种任务取决于是否需要区分个体。在工业场景中,语义分割尤其适合缺陷检测、区域提取等任务。其核心原理是编码器-解码器架构,配合跳跃连接恢复细节。实施流程包括数据标注、预处理、训练、评估、优化和部署六步。常见误区包括标注不一致、类别不平衡、分辨率处理不当和评估指标混淆。