4. 多线程基础概念
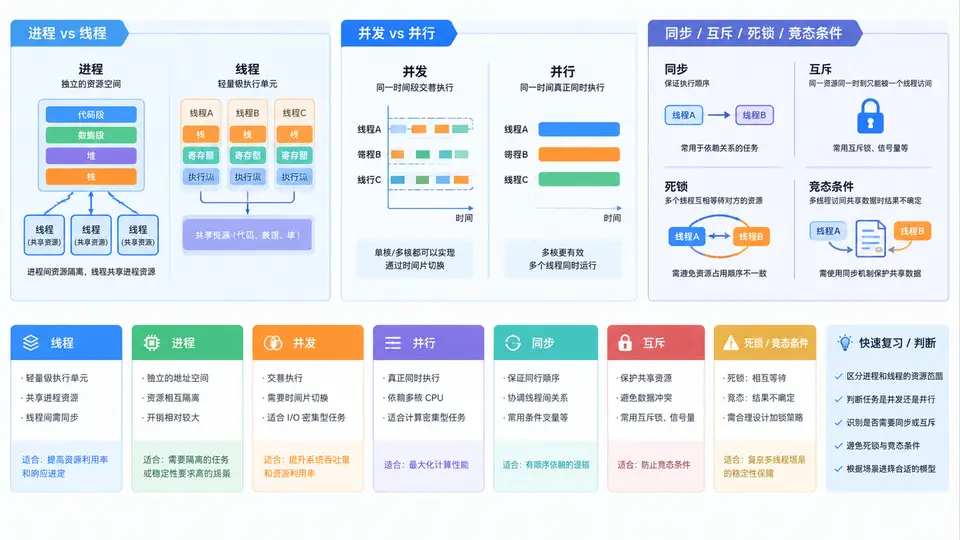
在进入 Halcon 多线程性能调优之前,必须先建立一套精确的术语体系。很多调优失败案例的根源,并非代码写错,而是工程师对“并发”与“并行”、“同步”与“互斥”的理解存在偏差,导致设计阶段就埋下隐患。本章将逐一拆解这些核心术语,并说明它们在 Halcon 视觉处理场景中的具体含义。
一、核心原理:从进程到线程的粒度演进
进程(Process)是操作系统分配资源(内存、文件句柄、CPU 时间片)的基本单位。每个进程拥有独立的地址空间,进程间通信(IPC)需要借助管道、共享内存、消息队列等机制,开销较大。在 Halcon 中,启动一个独立的 hdevelop 脚本运行实例,或者调用 system('start ...') 启动另一个可执行文件,都属于进程级操作。
线程(Thread)是进程内的执行流,同一进程的所有线程共享该进程的地址空间、全局变量和文件描述符。线程切换的开销远小于进程切换,因此视觉处理中追求的是“多线程”而非“多进程”。Halcon 的 par_start、par_join 操作符,以及 C++/C# 接口中的 HThread 类,都是线程级并发工具。
两者关系可概括为:进程是资源容器,线程是调度单元。一个进程至少包含一个主线程,多线程程序则是“一个进程 + 多个执行流”。
并发(Concurrency)与并行(Parallelism)的本质区别
并发指多个任务在同一时间段内交替执行,宏观上看似同时发生,微观上任意时刻只有一个任务在运行(单核 CPU 场景)。并行指多个任务在同一时刻真正同时执行,需要多核 CPU 或多 GPU 硬件支撑。
用 Halcon 举例:
- 并发:单核 CPU 上交替执行两个图像预处理任务,每个任务分时占用 CPU。
- 并行:四核 CPU 上同时运行四个 ROI 提取任务,每个核独立处理一个区域。
调优时必须先明确硬件拓扑:如果目标机器只有双核,却设计 8 个并行线程,只会增加上下文切换开销,性能反而下降。Halcon 的 get_system('processor_num') 可查询逻辑核心数,get_system('thread_num') 可查看当前线程池大小。
par_start 适合无依赖的独立图像块处理,而共享变量(如全局计数器)则需要配合 wait 或锁机制。
二、同步与互斥:保证正确性的两把锁
同步(Synchronization)是协调多个线程的执行顺序,确保某个操作必须在另一个操作完成后才能开始。典型场景:线程 A 负责采集图像,线程 B 负责处理图像,B 必须等待 A 发出“图像就绪”信号后才能启动处理。
互斥(Mutual Exclusion)是保证同一时刻只有一个线程访问共享资源(如全局变量、文件句柄、Halcon 的 HObject 对象)。互斥是同步的一种特殊形式,但同步更强调“顺序”,互斥更强调“排他”。
Halcon 中常用的同步/互斥原语包括:
| 术语 | Halcon 对应机制 | 典型用途 |
|---|---|---|
| 互斥锁 | create_mutex / acquire_mutex / release_mutex |
保护全局变量、共享 HObject 句柄 |
| 事件 | create_event / set_event / wait_for_event |
线程间“信号通知”,如采集完成通知处理线程 |
| 信号量 | 通过 create_semaphore 实现 |
控制同时访问某资源的线程数量(如限制同时读相机的线程数) |
| 临界区 | Halcon 的 par_begin / par_end 块内代码 |
限定一段代码只能被一个线程执行 |
以下是一个典型的互斥锁保护共享计数器的 Halcon 代码片段:
create_mutex (MutexHandle)
GlobalCounter := 0

* 线程函数(伪代码)
par_start (Thread1)
par_start (Thread2)

* 每个线程内执行:
acquire_mutex (MutexHandle)
GlobalCounter := GlobalCounter + 1
release_mutex (MutexHandle)

par_join (Thread1)
par_join (Thread2)
如果不加锁,两个线程同时执行 GlobalCounter := GlobalCounter + 1 时,可能发生“读-改-写”交错,导致最终计数小于 2。这就是典型的竞态条件。
三、死锁与竞态条件:多线程的两大陷阱
死锁(Deadlock)
死锁是指两个或多个线程互相等待对方释放资源,导致所有线程永久阻塞。产生死锁的四个必要条件(Coffman 条件)缺一不可:
- 互斥:资源一次只能被一个线程占用。
- 持有并等待:线程持有至少一个资源,同时等待获取其他线程持有的资源。
- 不可剥夺:资源只能由持有者主动释放。
- 循环等待:存在线程间的环形等待链。
Halcon 场景示例:线程 1 持有锁 A,等待锁 B;线程 2 持有锁 B,等待锁 A。此时两个线程都无法继续执行,程序挂起。
HObject 对象并非完全线程安全。如果两个线程同时操作同一个 HObject 变量(例如一个线程执行 reduce_domain,另一个线程执行 threshold),即使加了互斥锁,也可能因为 Halcon 内部对象引用计数机制导致未定义行为。建议为每个线程创建独立的 HObject 副本,或使用 copy_obj 显式复制。
竞态条件(Race Condition)
竞态条件是指程序的行为依赖于线程的调度顺序,即“谁先谁后”会影响最终结果。它不一定导致崩溃,但会产生错误输出。例如:
read_image (Image, 'camera_01.png')
* 线程 A 和线程 B 同时执行以下代码
threshold (Image, Region, 128, 255)
area_center (Region, Area, Row, Column)
如果线程 A 和 B 共享同一个 Image 变量,且没有同步机制,线程 A 可能刚执行完 threshold,线程 B 就修改了 Image 的内容,导致 A 后续的 area_center 计算基于错误数据。
竞态条件的检测通常需要借助工具:Halcon 的 set_system('thread_pool_behavior', 'true') 可开启线程池调试模式,输出线程调度日志;更专业的做法是使用 Intel Inspector 或 Valgrind 的 Helgrind 工具进行动态分析。
四、案例与场景:Halcon 多线程的典型应用模式
以下是一个工业视觉检测中常见的“采集-处理-输出”三线程流水线设计,完整展示了同步、互斥和避免死锁的实践方法。
场景描述
产线相机以 30fps 采集图像,需要同时进行缺陷检测和字符识别(OCR)。单线程处理耗时 60ms,无法满足 33ms 的节拍要求。设计三个线程:
- 采集线程:负责从相机抓取图像,写入共享缓冲区。
- 检测线程:从缓冲区读取图像,执行缺陷检测。
- 识别线程:从缓冲区读取同一图像,执行 OCR。
实现要点
create_mutex (BufMutex)
create_event (ImageReadyEvent)
create_event (BufFreeEvent)

* 缓冲区状态:0=空,1=满
BufferState := 0

* 采集线程
while (true)
    grab_image (Image, CameraHandle)
    acquire_mutex (BufMutex)
    * 等待缓冲区空闲
    while (BufferState != 0)
        wait_for_event (BufFreeEvent, 10)
    endwhile
    copy_obj (Image, SharedImage)
    BufferState := 1
    set_event (ImageReadyEvent)
    release_mutex (BufMutex)
endwhile

* 检测线程
while (true)
    acquire_mutex (BufMutex)
    if (BufferState == 1)
        copy_obj (SharedImage, ProcImage)
        BufferState := 0
        set_event (BufFreeEvent)
        release_mutex (BufMutex)
        * 执行检测
        threshold (ProcImage, Region, 100, 200)
        * ... 其他处理
    else
        release_mutex (BufMutex)
        wait_for_event (ImageReadyEvent, 10)
    endif
endwhile该设计通过互斥锁保护缓冲区状态,通过事件实现线程间通知,避免了忙等待(busy-wait)对 CPU 的浪费。同时,每个线程只持有锁极短时间(仅复制对象),降低了死锁风险。
五、误区与复盘:多线程调优的常见错误
误区 1:线程越多性能越好
Halcon 的 par_start 创建线程有固定开销(约 5-10μs)。当任务粒度很小时(例如处理 100×100 像素的 ROI),线程创建和同步开销可能超过计算本身。复盘建议:任务粒度应大于 1ms,否则应合并任务或使用 Halcon 内置的 tuple 批量处理。
误区 2:忽略 Halcon 的全局解释器锁(GIL)
Halcon 的 HDevelop 脚本模式存在类似 Python GIL 的全局锁,多个 par_start 线程在 HDevelop 中并不能真正并行执行算子。只有在 C++/C# 等编译语言中,通过 HOperatorSet 的独立 HWindow 或 HImage 实例,才能获得真正的多核并行。复盘建议:性能敏感场景使用 C++ 接口,而非 HDevelop 脚本。
误区 3:死锁后只加超时
有些工程师用 acquire_mutex (MutexHandle, 100) 加超时参数来“解决”死锁,但这只是掩盖问题。超时后线程继续执行,可能访问未就绪的数据,产生更隐蔽的竞态条件。正确做法是:通过锁顺序规范化(所有线程按相同顺序获取锁)或使用 try_lock 模式来从设计上消除死锁。
误区 4:忽略线程安全的数据复制
Halcon 的 HObject 是引用计数对象,直接赋值 SharedImage := Image 只是增加引用计数,并未复制像素数据。如果原图被其他线程修改,共享对象内容会变化。必须使用 copy_obj 进行深拷贝,或使用 clone 方法。复盘建议:所有跨线程传递的 HObject 必须显式复制。
六、术语对照与工程速查清单
| 术语 | 定义 | Halcon 对应 | 调优关注点 |
|---|---|---|---|
| 进程 | 资源分配单位,独立地址空间 | system('start') 外部进程 |
进程间通信开销大,视觉处理不推荐 |
| 线程 | 进程内执行流,共享内存 | par_start / HThread |
线程粒度需大于 1ms |
| 并发 | 时间片交替执行 | 单核多线程 | 上下文切换开销 |
| 并行 | 多核同时执行 | 多核 + 多线程 | 核数匹配,避免超订 |
| 同步 | 控制执行顺序 | wait_for_event |
避免忙等待 |
| 互斥 | 排他访问共享资源 | acquire_mutex |
锁粒度越小越好 |
| 死锁 | 循环等待资源 | 多锁嵌套 | 锁顺序规范化 |
| 竞态条件 | 结果依赖调度顺序 | 共享 HObject 未加锁 | 使用 copy_obj 隔离数据 |
HObject 引用计数的特殊性,因此数据复制策略和锁粒度控制是 Halcon 多线程性能调优的两大核心杠杆。只有在正确理解这些基础概念后,后续章节的线程池配置、算子级并行优化和 GPU 加速才有坚实的理论支撑。