3. AES-128的T表实现与内存占用权衡
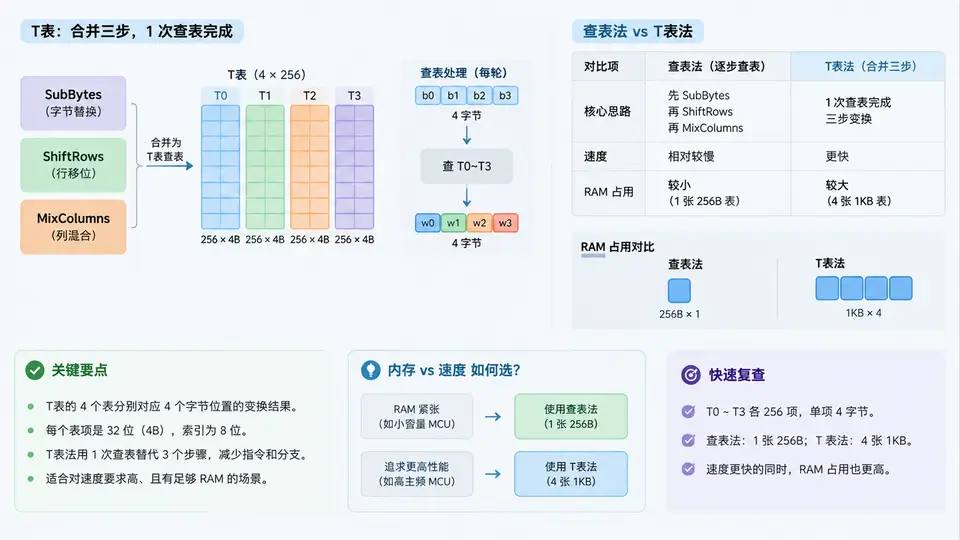
T表法的核心思想
AES-128的轮函数由SubBytes、ShiftRows、MixColumns、AddRoundKey四步组成。查表法需要分别执行S盒替换、行移位和列混合,而T表法把前三步合并为一次32位查表操作:将状态矩阵的每一列作为索引,从4张256项的32位表中取出4个值,异或后直接得到该列经过SubBytes+ShiftRows+MixColumns的结果。
设状态矩阵按列存储为 s[0..3](每列4字节),T表法的单列变换可写为:
// Te0[x] = [S[x]*2, S[x], S[x], S[x]*3] 的32位打包
// Te1[x] = [S[x]*3, S[x]*2, S[x], S[x]]
// Te2[x] = [S[x], S[x]*3, S[x]*2, S[x]]
// Te3[x] = [S[x], S[x], S[x]*3, S[x]*2]
// 其中乘法为GF(2^8)上的xtime运算

// 单列变换(加密方向)
t0 = Te0[s[0]>>24] ^ Te1[(s[1]>>16)&0xFF] ^
     Te2[(s[2]>>8)&0xFF]  ^ Te3[s[3]&0xFF] ^ rk[0];
t1 = Te0[s[1]>>24] ^ Te1[(s[2]>>16)&0xFF] ^
     Te2[(s[3]>>8)&0xFF]  ^ Te3[s[0]&0xFF] ^ rk[1];
t2 = Te0[s[2]>>24] ^ Te1[(s[3]>>16)&0xFF] ^
     Te2[(s[0]>>8)&0xFF]  ^ Te3[s[1]&0xFF] ^ rk[2];
t3 = Te0[s[3]>>24] ^ Te1[(s[0]>>16)&0xFF] ^
Te2[(s[1]>>8)&0xFF] ^ Te3[s[2]&0xFF] ^ rk[3];注意索引的错位:s[1]取第2字节、s[2]取第3字节、s[3]取第4字节,这正是ShiftRows在列方向上的体现。最后一轮不做MixColumns,因此需要单独使用S盒表Te4(或直接查S盒)并配合轮密钥异或。
在MCU上的实现要点
T表法的关键实现细节:
- 表生成:Te0~Te3可在编译期由S盒和GF(2^8)乘法生成,也可在运行时初始化。若Flash紧张,可只存Te0和S盒,运行时推导其余表,但会增加启动时间。
- 字节序处理:T表按32位字存储,索引时需注意大小端。Cortex-M默认小端,
s[0]>>24取的是最高字节,与表定义一致。 - 最后一轮:第10轮不做MixColumns,需用
Te4(S盒的32位扩展)或直接查S盒,再异或轮密钥。 - 解密方向:解密需用逆T表
Td0~Td3,或采用等价解密结构复用加密表,但会改变轮密钥顺序。
若MCU的Flash充足(≥8KB)且追求速度,T表法是首选;若Flash极度受限(如仅2KB),查表法或位运算实现更合适。实际选型时建议用
arm-none-eabi-size对比两种实现的.text和.data段大小。验证与测量方法
用NIST AES-128标准测试向量验证正确性:
明文: 00112233445566778899aabbccddeeff
密钥: 000102030405060708090a0b0c0d0e0f
密文: 69c4e0d86a7b0430d8cdb78070b4c55a速度测量:在GPIO引脚翻转前后各置一次,用示波器测高电平持续时间,除以加密次数得到单次耗时。RAM占用通过.map文件查看.bss和.data段变化。