2. AES-128在MCU上的查表法实现与优化
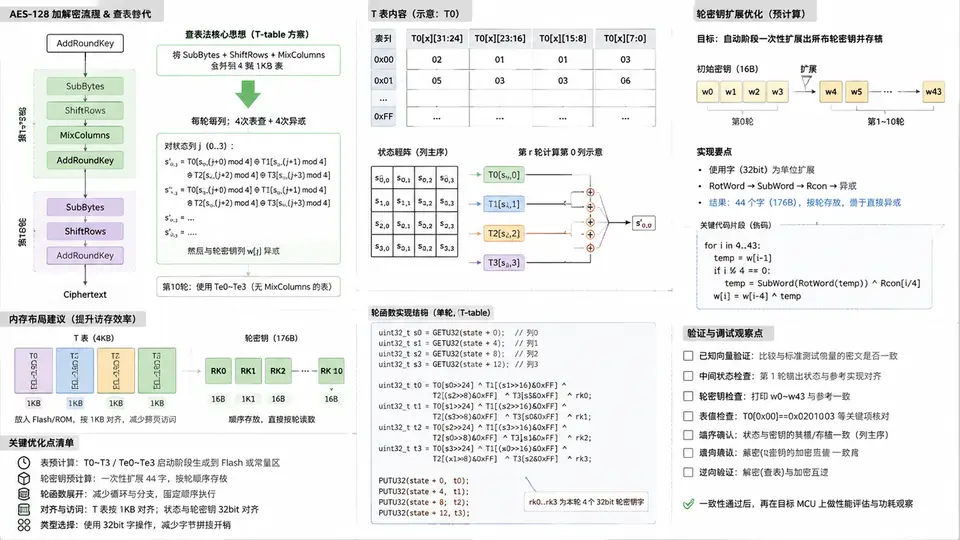
为什么在无硬件加速的MCU上选择查表法
无AES硬件加速的MCU(如Cortex-M0/M3、MSP430、AVR)执行位运算的代价很高。AES-128的SubBytes若用纯逻辑实现,每个字节需要求GF(2⁸)上的乘法逆元,指令周期开销极大。查表法把SubBytes和逆SubBytes固化为256字节的S盒与逆S盒,用一次ROM读取替代复杂运算,是这类平台上最直接的加速手段。
本节目标:在无硬件加速的MCU上完成AES-128加解密,并通过S盒预计算与轮函数展开降低指令周期。核心权衡是:ROM占用换指令周期,RAM占用换中间状态复用。
AES-128查表法的数据通路
下图给出查表法AES-128加解密的核心数据通路。加密方向:明文经AddRoundKey后进入9轮完整轮(SubBytes→ShiftRows→MixColumns→AddRoundKey),第10轮省略MixColumns。解密方向使用逆S盒、逆ShiftRows、逆MixColumns,轮密钥逆序使用。S盒与逆S盒以256字节常量表形式驻留Flash,运行时只读。
查表法实现要点
查表法的核心是把SubBytes变成一次数组索引。S盒是GF(2⁸)上乘法逆元加仿射变换的结果,逆S盒是其逆映射,两者都是固定常量,可在编译期生成并放入Flash。
- S盒与逆S盒:各256字节,共512字节Flash。用
const uint8_t声明,避免被复制到RAM。 - 状态矩阵:AES状态为4×4字节,按列优先存储。查表时对每个字节独立索引,天然适合逐字节处理。
- 轮密钥:密钥扩展产生11组16字节轮密钥,共176字节。可全部驻留RAM,也可按需计算以节省RAM。
- 轮函数展开:把
for(round=1; round<10; round++)展开为10段顺序代码,消除循环开销。
关键代码:S盒预计算与轮函数展开
下面给出查表法AES-128加密的核心实现。S盒以常量表形式给出前若干项,完整表为标准AES S盒;轮函数采用展开写法,减少循环与分支。
#include <stdint.h>
#include <string.h>

/* S盒:256字节常量表,编译期放入Flash */
static const uint8_t sbox[256] = {
    0x63,0x7c,0x77,0x7b,0xf2,0x6b,0x6f,0xc5,0x30,0x01,0x67,0x2b,0xfe,0xd7,0xab,0x76,
    0xca,0x82,0xc9,0x7d,0xfa,0x59,0x47,0xf0,0xad,0xd4,0xa2,0xaf,0x9c,0xa4,0x72,0xc0,
    /* ... 其余224字节为标准AES S盒 ... */
};

/* 逆S盒:256字节常量表 */
static const uint8_t inv_sbox[256] = {
    0x52,0x09,0x6a,0xd5,0x30,0x36,0xa5,0x38,0xbf,0x40,0xa3,0x9e,0x81,0xf3,0xd7,0xfb,
    0x7c,0xe3,0x39,0x82,0x9b,0x2f,0xff,0x87,0x34,0x8e,0x43,0x44,0xc4,0xde,0xe9,0xcb,
    /* ... 其余224字节为标准AES逆S盒 ... */
};

/* 轮常量 */
static const uint8_t rcon[11] = {
    0x00,0x01,0x02,0x04,0x08,0x10,0x20,0x40,0x80,0x1b,0x36
};

/* 密钥扩展:128b密钥 -> 11组16B轮密钥 */
static void key_expansion(const uint8_t key[16], uint8_t rk[176])
{
    uint8_t i, j;
    uint8_t t[4];
    memcpy(rk, key, 16);
    for (i = 4; i < 44; i++) {
        memcpy(t, &rk[(i-1)*4], 4);
        if (i % 4 == 0) {
            /* RotWord + SubWord + Rcon */
            uint8_t tmp = t[0];
            t[0] = sbox[t[1]] ^ rcon[i/4];
            t[1] = sbox[t[2]];
            t[2] = sbox[t[3]];
            t[3] = sbox[tmp];
        }
        for (j = 0; j < 4; j++)
            rk[i*4+j] = rk[(i-4)*4+j] ^ t[j];
    }
}

/* GF(2^8) 乘2 */
static uint8_t xtime(uint8_t x)
{
    return (uint8_t)((x << 1) ^ ((x & 0x80) ? 0x1b : 0x00));
}

/* MixColumns:对状态4列分别做GF(2^8)列混合 */
static void mix_columns(uint8_t s[16])
{
    uint8_t i, a, b, c, d;
    for (i = 0; i < 4; i++) {
        a = s[i*4+0]; b = s[i*4+1]; c = s[i*4+2]; d = s[i*4+3];
        uint8_t e = a ^ b ^ c ^ d;
        s[i*4+0] ^= e ^ xtime(a ^ b);
        s[i*4+1] ^= e ^ xtime(b ^ c);
        s[i*4+2] ^= e ^ xtime(c ^ d);
        s[i*4+3] ^= e ^ xtime(d ^ a);
    }
}

/* 加密:轮函数展开,消除循环与分支 */
void aes128_encrypt(const uint8_t in[16], uint8_t out[16], const uint8_t rk[176])
{
    uint8_t s[16];
    uint8_t i, r;

    /* 初始 AddRoundKey */
    for (i = 0; i < 16; i++) s[i] = in[i] ^ rk[i];

    /* 第1~9轮:SubBytes -> ShiftRows -> MixColumns -> AddRoundKey */
    for (r = 1; r < 10; r++) {
        /* SubBytes:查表 */
        for (i = 0; i < 16; i++) s[i] = sbox[s[i]];

        /* ShiftRows:行循环左移 0/1/2/3 */
        uint8_t t;
        t = s[1]; s[1] = s[5]; s[5] = s[9]; s[9] = s[13]; s[13] = t;
        t = s[2]; s[2] = s[10]; s[10] = t;
        t = s[6]; s[6] = s[14]; s[14] = t;
        t = s[3]; s[3] = s[15]; s[15] = s[11]; s[11] = s[7]; s[7] = t;

        mix_columns(s);

        for (i = 0; i < 16; i++) s[i] ^= rk[r*16+i];
    }

    /* 第10轮:省略 MixColumns */
    for (i = 0; i < 16; i++) s[i] = sbox[s[i]];

    uint8_t t;
    t = s[1]; s[1] = s[5]; s[5] = s[9]; s[9] = s[13]; s[13] = t;
    t = s[2]; s[2] = s[10]; s[10] = t;
    t = s[6]; s[6] = s[14]; s[14] = t;
    t = s[3]; s[3] = s[15]; s[15] = s[11]; s[11] = s[7]; s[7] = t;

    for (i = 0; i < 16; i++) out[i] = s[i] ^ rk[160+i];
}
展开与不展开的取舍:上面的
for (r = 1; r < 10; r++)仍保留了轮循环,便于阅读。若追求极致指令周期,可将其完全展开为9段重复代码,消除循环变量r的递增、比较和跳转。代价是代码体积增大约9倍。在Flash充裕、追求速度的场景下值得展开;Flash紧张时保留循环更稳妥。
验证方法与预期结果
用标准测试向量验证实现正确性。AES-128的FIPS-197标准向量如下:
| 项目 | 值 |
|---|---|
| 密钥 | 000102030405060708090a0b0c0d0e0f |
| 明文 | 00112233445566778899aabbccddeeff |
| 预期密文 | 69c4e0d86a7b0430d8cdb78070b4c55a |
验证步骤:
- 调用
key_expansion生成轮密钥,检查rk[0..15]是否等于原始密钥。 - 调用
aes128_encrypt,将输出与预期密文逐字节比较。 - 解密方向用逆S盒、逆ShiftRows、逆MixColumns,轮密钥逆序使用,验证能还原明文。
- 在目标MCU上测量加密耗时,对比未展开版本,确认指令周期下降。
常见错误:ShiftRows的行移位方向容易写反。加密是行循环左移(第0行不移、第1行左移1、第2行左移2、第3行左移3),解密是行循环右移。若加密结果与标准向量不符,优先检查ShiftRows的索引映射。另外,状态矩阵按列优先存储,
s[0..3]是第0列,s[4..7]是第1列,索引写错会导致列混合作用在错误的列上。
资源与性能对照
| 项目 | 查表法(循环) | 查表法(展开) |
|---|---|---|
| S盒 + 逆S盒 Flash | 512 B | 512 B |
| 轮密钥 RAM | 176 B | 176 B |
| 状态与临时变量 | 约 32 B | 约 32 B |
| 代码体积 | 基准 | 约 9 倍 |
| 指令周期 | 基准 | 显著下降 |
在Cortex-M0上,查表法加密一个16字节分组通常在数千指令周期量级;展开后循环开销被消除,具体数值需在目标板实测。若RAM极度紧张,可只保留S盒、按需计算逆S盒,或用密钥扩展的按需计算替代176字节轮密钥缓存。