2. 基于敏感数据识别规则的个人信息字段扫描
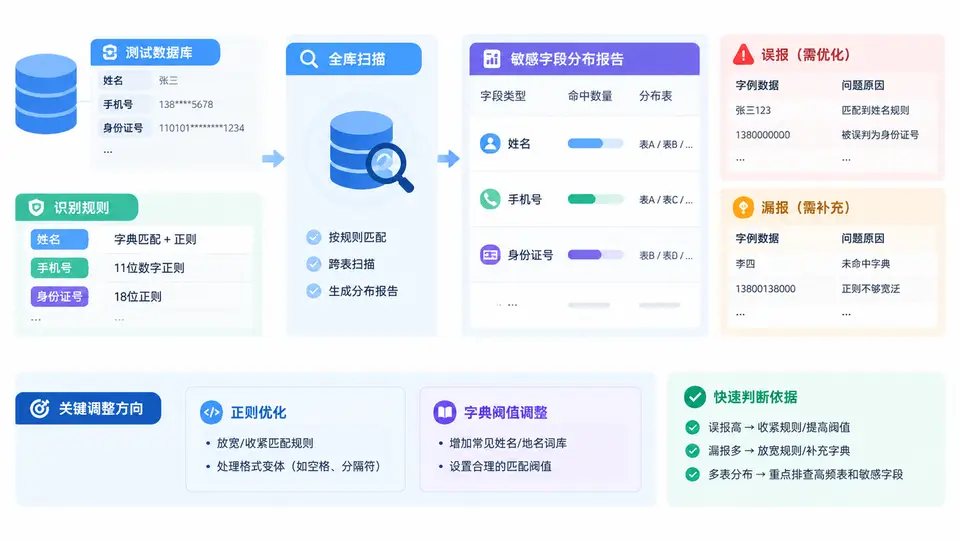
扫描任务的对象与判定链路
本案例在测试库 demo_hr 中完成一次字段级敏感数据扫描。核心对象是三类个人信息字段:姓名、手机号、身份证号。扫描器对每个字段先做列名匹配(字典命中),再做值域正则匹配(内容命中),两者按“或”关系合并为候选敏感字段,最后经阈值过滤输出分布报告。误报主要来自列名相似但内容非敏感(如 full_name 存的是产品名),漏报主要来自正则过严或字典未覆盖别名(如 mobile_no、id_card)。
识别规则配置与扫描执行
以下配置在扫描器规则文件中完成。字典用于列名匹配,正则用于值域匹配,阈值控制判定灵敏度。示例参数为教学假设值,实际需根据数据分布调整。
# sensitive_rules.yaml
rules:
  - name: person_name
    type: 姓名
    column_dict: [name, full_name, emp_name, real_name, user_name]
    value_regex: "^[\u4e00-\u9fa5]{2,4}$"
    threshold: 0.6

  - name: mobile_phone
    type: 手机号
    column_dict: [mobile, phone, mobile_no, tel, contact_phone]
    value_regex: "^1[3-9]\\d{9}$"
    threshold: 0.7

  - name: id_card
    type: 身份证号
    column_dict: [id_card, id_number, identity_no, cert_no]
    value_regex: "^\\d{17}[\\dXx]$"
    threshold: 0.8
扫描执行命令(以 Python 脚本为例,遍历 demo_hr 库所有表的所有列):
import re, yaml, sqlite3

def load_rules(path="sensitive_rules.yaml"):
    with open(path, encoding="utf-8") as f:
        return yaml.safe_load(f)["rules"]

def scan_column(values, rule):
    """返回 (是否命中, 命中率, 命中方式)"""
    total = len(values)
    if total == 0:
        return False, 0.0, "empty"
    regex = re.compile(rule["value_regex"])
    hits = sum(1 for v in values if v and regex.match(str(v)))
    rate = hits / total
    return rate >= rule["threshold"], round(rate, 3), "regex"

def scan_database(db_path, rules):
    conn = sqlite3.connect(db_path)
    cur = conn.cursor()
    cur.execute("SELECT name FROM sqlite_master WHERE type='table'")
    tables = [r[0] for r in cur.fetchall()]
    report = []
    for table in tables:
        cur.execute(f"PRAGMA table_info({table})")
        cols = [c[1] for c in cur.fetchall()]
        for col in cols:
            cur.execute(f"SELECT {col} FROM {table} LIMIT 500")
            values = [r[0] for r in cur.fetchall()]
            for rule in rules:
                col_hit = col.lower() in [d.lower() for d in rule["column_dict"]]
                val_hit, rate, method = scan_column(values, rule)
                if col_hit or val_hit:
                    report.append({
                        "table": table, "column": col,
                        "type": rule["type"],
                        "hit_rate": rate,
                        "method": "column+value" if (col_hit and val_hit) else ("column" if col_hit else "value")
                    })
    conn.close()
    return report

if __name__ == "__main__":
    rules = load_rules()
    results = scan_database("demo_hr.db", rules)
    for r in results:
        print(f"{r['table']}.{r['column']} | {r['type']} | 命中率={r['hit_rate']} | 方式={r['method']}")
误报与漏报的观察与调整
首次扫描后,重点检查两类异常:
- 误报:
full_name列被姓名规则命中,但实际存的是产品名称。原因是列名字典包含full_name,且值域正则^[\u4e00-\u9fa5]{2,4}$对中文产品名也匹配。调整方式:将full_name从姓名字典移除,或增加业务白名单过滤。 - 漏报:
mobile_no列未被手机号规则命中。原因是列名字典缺少mobile_no,且该列部分值含空格或+86前缀,正则未覆盖。调整方式:字典补充mobile_no,正则改为^(\+86)?1[3-9]\d{9}$并先做去空格清洗。
调整后重新执行扫描,对比两次报告的字段数量与命中率变化。建议将误报字段加入
exclude_columns 白名单,将漏报字段的别名补充到 column_dict,并记录每次调整的规则版本,便于审计回溯。敏感字段分布报告示例
| 表名 | 字段名 | 敏感类型 | 命中率 | 命中方式 | 判定 |
|---|---|---|---|---|---|
| employees | emp_name | 姓名 | 0.95 | column+value | 正确命中 |
| employees | mobile | 手机号 | 0.98 | column+value | 正确命中 |
| employees | id_number | 身份证号 | 0.92 | column+value | 正确命中 |
| customers | full_name | 姓名 | 0.72 | column | 误报(产品名) |
| customers | mobile_no | 手机号 | 0.00 | 未命中 | 漏报(字典缺失) |
| customers | id_card | 身份证号 | 0.45 | value | 漏报(正则过严) |
阈值调整需权衡:降低阈值可减少漏报但增加误报,提高阈值则相反。建议先以 0.6~0.8 为初始区间,根据业务字段的实际数据分布做针对性微调,并保留调整前后的报告对比作为审计证据。