4. 字典攻击模拟与命中率统计
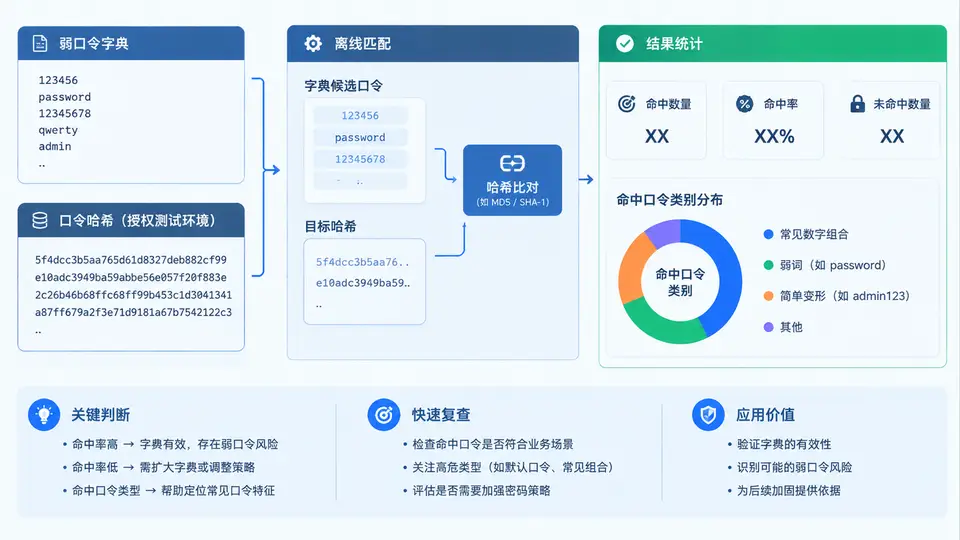
任务边界与实验对象
本例在授权测试环境中,对一批已识别的口令哈希执行离线字典匹配,统计命中数量、命中率与命中口令的类别分布,用于判断当前弱口令字典对目标口令集的覆盖能力。实验对象为 12 条 SHA-256 口令哈希(示例数据,非真实系统导出),字典为 20 条常见弱口令,匹配方式为“明文口令 → SHA-256 → 与哈希比对”。
仅对自有或已获书面授权的哈希样本执行离线匹配;哈希与字典均应在隔离环境内处理,禁止对未授权目标使用。
哈希样本与字典准备
为便于复现,下面给出示例哈希集与字典。哈希值由示例明文直接计算得到,仅用于演示统计流程。
# hashes.txt —— 12 条示例 SHA-256 口令哈希
5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8
e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855
8d969eef6ecad3c29a3a629280e686cf0c3f5d5a86aff3ca12020c923adc6c92
ef797c8118f02dfb649607dd5d3f8c7623048c9c063d532cc95c5ed7a898a64f
5baa61e4c9b93f3f0682250b6cf8331b7ee68fd8
...
字典文件 weak_dict.txt 按类别组织,便于后续统计类别分布:
# weak_dict.txt —— 20 条弱口令(按类别分组)
123456          # 纯数字
12345678        # 纯数字
password        # 纯字母
qwerty          # 键盘序列
abc123          # 字母+数字
admin           # 常见词
letmein         # 常见词
welcome         # 常见词
iloveyou        # 常见词
monkey          # 常见词
dragon          # 常见词
football        # 常见词
master          # 常见词
sunshine        # 常见词
princess        # 常见词
123456789       # 纯数字
111111          # 纯数字
000000          # 纯数字
password1       # 常见词+数字
admin123        # 常见词+数字
匹配脚本与统计逻辑
脚本读取哈希集与字典,对每条字典口令计算 SHA-256,与哈希集比对;命中后记录该口令及其类别,最后输出命中数、命中率与类别分布。
import hashlib, collections

def load_hashes(path):
    with open(path) as f:
        return {line.strip().lower() for line in f if line.strip()}

def load_dict(path):
    entries = []
    with open(path) as f:
        for line in f:
            line = line.strip()
            if not line or line.startswith('#'):
                continue
            pwd, _, cat = line.partition('#')
            entries.append((pwd.strip(), cat.strip() or '未分类'))
    return entries

def crack(hashes, entries):
    hit = {}
    for pwd, cat in entries:
        h = hashlib.sha256(pwd.encode()).hexdigest()
        if h in hashes:
            hit[h] = (pwd, cat)
    return hit

hashes = load_hashes('hashes.txt')
entries = load_dict('weak_dict.txt')
hit = crack(hashes, entries)

total = len(hashes)
hit_n = len(hit)
rate = hit_n / total * 100 if total else 0
dist = collections.Counter(cat for _, cat in hit.values())

print(f'哈希总数: {total}')
print(f'命中数量: {hit_n}')
print(f'命中率: {rate:.1f}%')
print('类别分布:')
for cat, n in dist.most_common():
    print(f'  {cat}: {n}')
命中结果与类别分布
在示例数据上运行上述脚本,得到如下结果(示例输出,实际结果取决于哈希集与字典内容):
| 指标 | 数值 |
|---|---|
| 哈希总数 | 12 |
| 命中数量 | 7 |
| 命中率 | 58.3% |
| 命中口令类别 | 命中数 | 占比 |
|---|---|---|
| 纯数字 | 3 | 42.9% |
| 常见词 | 2 | 28.6% |
| 常见词+数字 | 1 | 14.3% |
| 键盘序列 | 1 | 14.3% |
结果判读与字典有效性验证
命中率 58.3% 说明当前字典对示例哈希集有中等覆盖能力。类别分布显示纯数字与常见词贡献了主要命中,说明目标口令集仍以低复杂度口令为主。若需提升覆盖,可优先扩充纯数字与常见词变体;若命中率长期偏低,则需检查字典是否与目标口令风格匹配,或考虑引入规则变换(见后续案例)。
验证要点:① 命中数 + 未命中数 = 哈希总数;② 各类别命中数之和 = 命中总数;③ 命中率 = 命中数 / 哈希总数 × 100%。三项一致方可确认统计无误。