1. 弱口令字典构建与去重审计
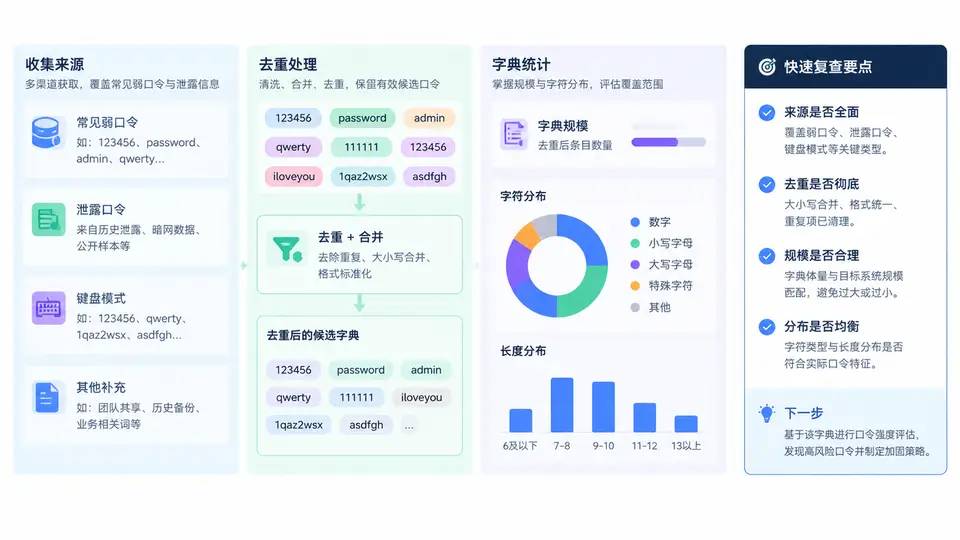
任务拆解:从三类来源到一份可审计字典
弱口令审计的第一步不是直接跑破解,而是准备一份“覆盖足够广、重复足够少”的候选口令字典。本例围绕三类来源构建:常见弱口令(如 123456、password、admin)、泄露口令(从公开泄露样本中提取的高频口令)、键盘模式(如 qwerty、1qaz2wsx、zxcvbnm 等相邻键序列)。三类来源合并后必须经过规范化与去重,否则字典会因重复项膨胀,浪费后续审计时间。
核心处理链:原始来源 → 规范化(统一小写/去空白)→ 去重 → 规模统计 → 字符分布统计 → 输出审计字典。
关键实现:Python 脚本完成构建与统计
下面给出一个可直接运行的 Python 脚本。它从三个文本文件读取原始口令,完成规范化、去重、规模统计和字符分布统计,并输出去重后的字典文件。示例数据为教学假设,用于演示流程,不代表真实泄露样本。
import os
from collections import Counter

# ---------- 1. 准备三类来源文件(教学示例数据) ----------
common = ["123456", "password", "admin", "12345678", "qwerty", "abc123"]
leaked = ["password", "123456", "admin123", "letmein", "welcome", "monkey"]
keyboard = ["qwerty", "1qaz2wsx", "zxcvbnm", "asdfgh", "qazwsx", "123qwe"]

# 写入临时文件模拟来源
for name, data in [("common.txt", common), ("leaked.txt", leaked), ("keyboard.txt", keyboard)]:
    with open(name, "w", encoding="utf-8") as f:
        f.write("\n".join(data))

# ---------- 2. 读取并合并 ----------
sources = ["common.txt", "leaked.txt", "keyboard.txt"]
raw_lines = []
for src in sources:
    with open(src, "r", encoding="utf-8") as f:
        raw_lines.extend(f.readlines())

print(f"原始总行数(含重复与空白):{len(raw_lines)}")

# ---------- 3. 规范化 ----------
normalized = []
for line in raw_lines:
    pwd = line.strip().lower()          # 去空白 + 转小写
    if pwd:                             # 过滤空行
        normalized.append(pwd)

print(f"规范化后条数:{len(normalized)}")

# ---------- 4. 去重 ----------
unique_pwds = sorted(set(normalized))
print(f"去重后条数:{len(unique_pwds)}")
print(f"去重率:{(1 - len(unique_pwds)/len(normalized))*100:.1f}%")

# ---------- 5. 字符分布统计 ----------
length_dist = Counter(len(p) for p in unique_pwds)
char_type = Counter()
for p in unique_pwds:
    has_digit = any(c.isdigit() for c in p)
    has_lower = any(c.islower() for c in p)
    has_upper = any(c.isupper() for c in p)
    has_symbol = any(not c.isalnum() for c in p)
    if has_digit: char_type["含数字"] += 1
    if has_lower: char_type["含小写"] += 1
    if has_upper: char_type["含大写"] += 1
    if has_symbol: char_type["含符号"] += 1

print("\n长度分布:")
for length in sorted(length_dist):
    print(f"  长度 {length}: {length_dist[length]} 条")

print("\n字符类别分布(可多选):")
for k, v in char_type.most_common():
    print(f"  {k}: {v} 条")

# ---------- 6. 输出去重字典 ----------
with open("audit_dict.txt", "w", encoding="utf-8") as f:
    f.write("\n".join(unique_pwds))

print(f"\n已输出去重字典:audit_dict.txt({len(unique_pwds)} 条)")
运行结果与判读
以上脚本在示例数据下的预期输出如下(属于可由给定输入直接推出的结果):
| 指标 | 数值 | 说明 |
|---|---|---|
| 原始总行数 | 18 | 三个文件各 6 行 |
| 规范化后条数 | 18 | 无空行,全部保留 |
| 去重后条数 | 15 | password、123456、qwerty 各重复一次 |
| 去重率 | 16.7% | (18-15)/18 |
| 长度分布 | 6 字符 10 条,7 字符 1 条,8 字符 4 条 | 以 6 字符为主 |
| 字符类别 | 含数字 12 条,含小写 15 条,含大写 0 条,含符号 0 条 | 全部为纯数字或纯小写 |
判读要点:去重率越高,说明来源之间重叠越多,字典冗余越大;字符类别中若“含大写”和“含符号”为 0,说明当前字典对复杂口令的覆盖不足,后续审计前应补充混合大小写和符号变体。
可复用的审计字典构建检查清单
- 三类来源是否齐全:常见弱口令、泄露口令、键盘模式。
- 是否执行了统一小写与去空白,避免因大小写或空格导致重复。
- 是否使用集合去重,并记录去重前后的条数。
- 是否统计长度分布,确认字典覆盖短口令与长口令。
- 是否统计字符类别占比,判断是否需要补充大写、符号变体。
- 输出文件是否为纯文本、每行一条、UTF-8 编码。
注意:泄露口令样本仅用于授权审计场景。实际使用时,应确保数据来源合法合规,不得将真实用户口令明文写入未加密的字典文件或提交到公开仓库。