3. 实现多头注意力机制
任务说明
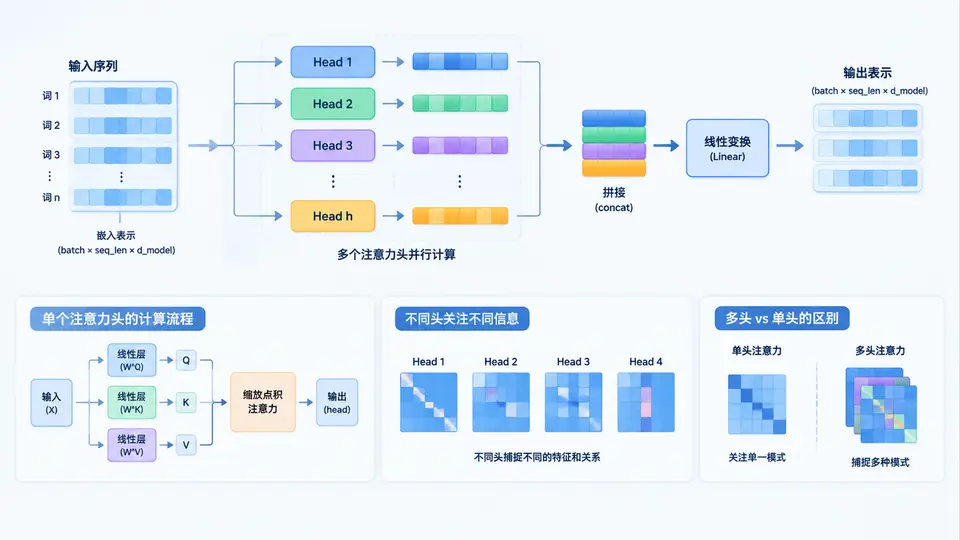
实现Transformer中的多头注意力机制(Multi-Head Attention),要求:输入序列经过线性投影拆分为多个注意力头,每个头独立计算缩放点积注意力,最后拼接所有头输出并通过输出投影矩阵融合。代码需支持自定义头数与维度配置,并提供前向传播的完整实现。
核心实现
import numpy as np

class MultiHeadAttention:
    def __init__(self, d_model, num_heads):
        assert d_model % num_heads == 0, "d_model必须能被num_heads整除"
        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads

        # 初始化权重矩阵(简化版,未包含bias)
        self.W_Q = np.random.randn(d_model, d_model) * 0.1
        self.W_K = np.random.randn(d_model, d_model) * 0.1
        self.W_V = np.random.randn(d_model, d_model) * 0.1
        self.W_O = np.random.randn(d_model, d_model) * 0.1

    def scaled_dot_product_attention(self, Q, K, V, mask=None):
        """Q, K, V形状: (batch_size, num_heads, seq_len, d_k)"""
        scores = np.matmul(Q, K.transpose(0, 1, 3, 2)) / np.sqrt(self.d_k)
        if mask is not None:
            scores = np.where(mask == 0, -1e9, scores)
        weights = np.exp(scores - np.max(scores, axis=-1, keepdims=True))
        weights /= np.sum(weights, axis=-1, keepdims=True)
        return np.matmul(weights, V), weights

    def split_heads(self, x):
        """x形状: (batch_size, seq_len, d_model) -> (batch_size, num_heads, seq_len, d_k)"""
        batch_size, seq_len, _ = x.shape
        x = x.reshape(batch_size, seq_len, self.num_heads, self.d_k)
        return x.transpose(0, 2, 1, 3)

    def combine_heads(self, x):
        """x形状: (batch_size, num_heads, seq_len, d_k) -> (batch_size, seq_len, d_model)"""
        batch_size, _, seq_len, _ = x.shape
        x = x.transpose(0, 2, 1, 3)
        return x.reshape(batch_size, seq_len, self.d_model)

    def forward(self, query, key, value, mask=None):
        """query/key/value形状: (batch_size, seq_len, d_model)"""
        # 线性投影
        Q = np.matmul(query, self.W_Q)
        K = np.matmul(key, self.W_K)
        V = np.matmul(value, self.W_V)

        # 拆分多头
        Q = self.split_heads(Q)
        K = self.split_heads(K)
        V = self.split_heads(V)

        # 缩放点积注意力
        attn_output, attn_weights = self.scaled_dot_product_attention(Q, K, V, mask)

        # 拼接多头并输出投影
        attn_output = self.combine_heads(attn_output)
        output = np.matmul(attn_output, self.W_O)
        return output, attn_weights
验证用例
# 配置参数
d_model = 8
num_heads = 2
batch_size = 1
seq_len = 4

# 创建随机输入
np.random.seed(42)
query = np.random.randn(batch_size, seq_len, d_model)
key = np.random.randn(batch_size, seq_len, d_model)
value = np.random.randn(batch_size, seq_len, d_model)

# 初始化多头注意力
mha = MultiHeadAttention(d_model, num_heads)

# 前向传播
output, attn_weights = mha.forward(query, key, value)

# 验证输出形状
print("输出形状:", output.shape)  # 预期: (1, 4, 8)
print("注意力权重形状:", attn_weights.shape)  # 预期: (1, 2, 4, 4)

# 验证每个注意力头权重行和为1
head_sum = np.sum(attn_weights, axis=-1)
print("注意力权重行和是否接近1:", np.allclose(head_sum, 1.0))  # 预期: True
运行与验证
将上述代码保存为multi_head_attention.py,在Python 3环境中运行(需安装NumPy)。执行后观察输出:输出张量形状应为(1, 4, 8),与输入序列长度和模型维度一致;注意力权重形状为(1, 2, 4, 4),其中第二维对应2个注意力头。判定标准:输出形状正确且每个注意力头的权重行和均为1(softmax归一化结果),即实现正确。