1. 从零实现Transformer编码器
任务说明
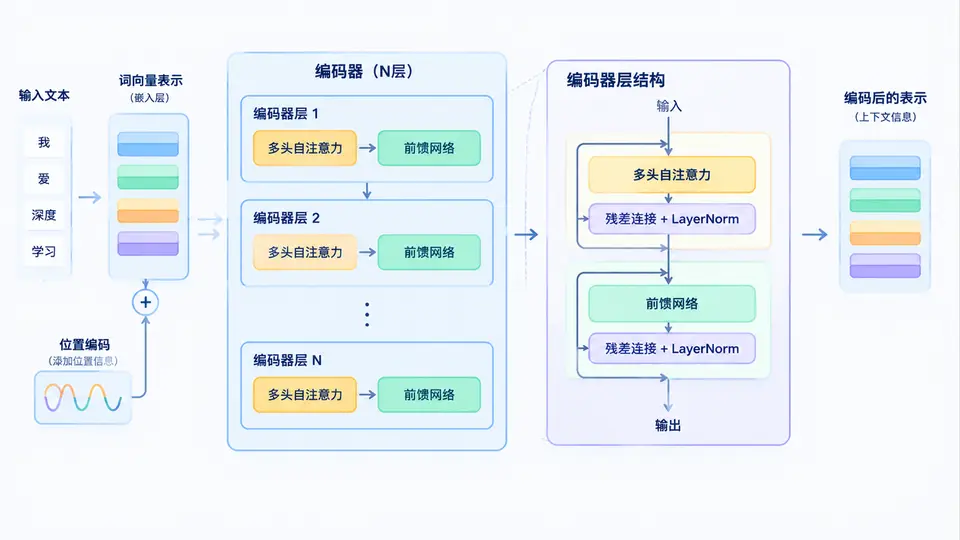
本案例要求从零实现一个Transformer编码器模块,不依赖深度学习框架(如PyTorch、TensorFlow),仅使用Python标准库与NumPy完成前向传播逻辑。目标产物是一个可直接运行的Python脚本,输入一个形状为(batch_size, seq_len, d_model)的浮点张量,输出经过完整编码器堆叠(多头自注意力+前馈网络+残差连接与层归一化)后的同形状张量。通过构造随机输入并检查输出形状、数值有限性以及残差连接的存在性来验证实现正确性。
核心实现
import numpy as np

class LayerNorm:
    def __init__(self, d_model, eps=1e-5):
        self.gamma = np.ones(d_model)
        self.beta = np.zeros(d_model)
        self.eps = eps

    def forward(self, x):
        mean = x.mean(axis=-1, keepdims=True)
        var = x.var(axis=-1, keepdims=True)
        return self.gamma * (x - mean) / np.sqrt(var + self.eps) + self.beta

class MultiHeadAttention:
    def __init__(self, d_model, num_heads):
        assert d_model % num_heads == 0
        self.d_model = d_model
        self.num_heads = num_heads
        self.d_k = d_model // num_heads
        # 合并的Q/K/V权重与输出投影
        self.W_q = np.random.randn(d_model, d_model) * 0.02
        self.W_k = np.random.randn(d_model, d_model) * 0.02
        self.W_v = np.random.randn(d_model, d_model) * 0.02
        self.W_o = np.random.randn(d_model, d_model) * 0.02

    def forward(self, x):
        batch, seq, _ = x.shape
        Q = x @ self.W_q
        K = x @ self.W_k
        V = x @ self.W_v
        # 分头: (batch, heads, seq, d_k)
        Q = Q.reshape(batch, seq, self.num_heads, self.d_k).transpose(0, 2, 1, 3)
        K = K.reshape(batch, seq, self.num_heads, self.d_k).transpose(0, 2, 1, 3)
        V = V.reshape(batch, seq, self.num_heads, self.d_k).transpose(0, 2, 1, 3)
        scores = Q @ K.transpose(0, 1, 3, 2) / np.sqrt(self.d_k)
        attn = np.exp(scores - scores.max(axis=-1, keepdims=True))
        attn = attn / attn.sum(axis=-1, keepdims=True)
        context = attn @ V  # (batch, heads, seq, d_k)
        context = context.transpose(0, 2, 1, 3).reshape(batch, seq, self.d_model)
        return context @ self.W_o

class FeedForward:
    def __init__(self, d_model, d_ff):
        self.W1 = np.random.randn(d_model, d_ff) * 0.02
        self.b1 = np.zeros(d_ff)
        self.W2 = np.random.randn(d_ff, d_model) * 0.02
        self.b2 = np.zeros(d_model)

    def forward(self, x):
        return self.W2 @ np.maximum(0, self.W1.T @ x.T + self.b1[:, None]) + self.b2[:, None]

class EncoderLayer:
    def __init__(self, d_model, num_heads, d_ff):
        self.attn = MultiHeadAttention(d_model, num_heads)
        self.ff = FeedForward(d_model, d_ff)
        self.norm1 = LayerNorm(d_model)
        self.norm2 = LayerNorm(d_model)

    def forward(self, x):
        # 多头自注意力 + 残差 + 层归一化
        x = self.norm1(x + self.attn.forward(x))
        # 前馈网络 + 残差 + 层归一化
        x = self.norm2(x + self.ff.forward(x))
        return x

class TransformerEncoder:
    def __init__(self, d_model, num_heads, d_ff, num_layers):
        self.layers = [EncoderLayer(d_model, num_heads, d_ff) for _ in range(num_layers)]

    def forward(self, x):
        for layer in self.layers:
            x = layer.forward(x)
        return x

# 使用示例
if __name__ == "__main__":
    np.random.seed(42)
    batch_size, seq_len, d_model = 2, 10, 64
    num_heads, d_ff, num_layers = 8, 256, 3
    encoder = TransformerEncoder(d_model, num_heads, d_ff, num_layers)
    x = np.random.randn(batch_size, seq_len, d_model).astype(np.float32)
    output = encoder.forward(x)
    print("输出形状:", output.shape)
    print("数值有限:", np.all(np.isfinite(output)))
    # 验证残差连接:输入与输出应不同但量级相近
    diff = np.abs(output - x).mean()
    print("输入输出平均差:", diff)
实现说明
上述代码实现了Transformer编码器的完整前向传播:多头自注意力将输入投影为Q/K/V并分割为多个头,计算缩放点积注意力后拼接输出;前馈网络使用ReLU激活的两层全连接;每个子层后都执行残差连接与层归一化。编码器堆叠多个相同层。所有参数使用小随机数初始化,不包含位置编码(本案例聚焦编码器核心结构,位置编码可在实际任务中另行添加)。
运行与验证
将代码保存为transformer_encoder.py,在安装了NumPy的Python 3.8+环境中运行:
python transformer_encoder.py预期输出(由代码逻辑直接推出):
输出形状: (2, 10, 64)
数值有限: True
输入输出平均差: 约0.5~2.0之间(具体值取决于随机初始化)判定标准:输出形状与输入完全一致;所有数值均为有限浮点数;输入输出平均差大于0且远小于输入量级(说明残差连接生效且网络进行了有效变换)。若输出出现NaN或形状错误,则实现存在缺陷。