3. 处理API分页数据
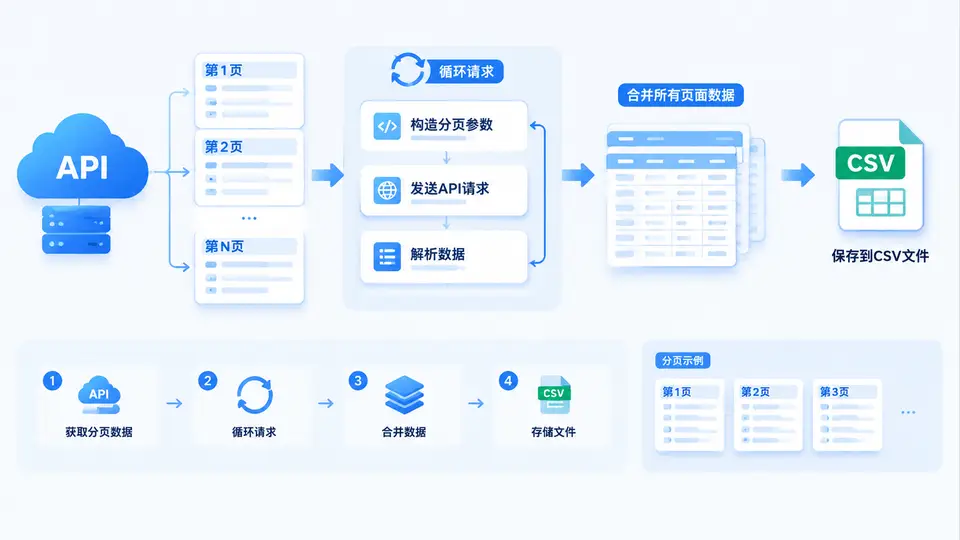
任务说明
本案例要求编写一个Python爬虫,循环请求一个分页API,收集所有页面的数据,并将合并后的完整数据集存储到CSV文件。为便于独立复现,我们使用一个公开的、无需认证的REST API——jsonplaceholder.typicode.com/posts。该API支持_page和_limit查询参数,每页返回指定数量的帖子数据,响应头中的X-Total-Count字段标识资源总数。我们将以此为基础实现通用分页抓取逻辑。
实现方案
核心思路:
- 先发送一次请求获取
X-Total-Count总数,结合每页大小计算总页数; - 循环请求每一页,将每页返回的JSON列表追加到总列表中;
- 使用
csv.DictWriter将合并后的数据写入CSV文件。
代码中通过page_size控制每页记录数,并设置time.sleep(0.2)避免对测试服务器造成压力。异常处理保证单页失败时能重试最多3次,若最终失败则抛出异常终止程序,避免静默丢失数据。
完整代码
import requests
import csv
import time

API_URL = "https://jsonplaceholder.typicode.com/posts"
PAGE_SIZE = 20          # 每页记录数
OUTPUT_FILE = "posts_all.csv"
MAX_RETRIES = 3
RETRY_DELAY = 1         # 秒

def fetch_page(page_num: int, page_size: int) -> list:
    """请求指定页码的数据,带重试机制"""
    params = {"_page": page_num, "_limit": page_size}
    for attempt in range(1, MAX_RETRIES + 1):
        try:
            resp = requests.get(API_URL, params=params, timeout=10)
            resp.raise_for_status()
            return resp.json()
        except (requests.RequestException, ValueError) as e:
            if attempt == MAX_RETRIES:
                raise RuntimeError(f"第{page_num}页请求失败: {e}")
            time.sleep(RETRY_DELAY * attempt)

def get_total_count() -> int:
    """获取资源总数(来自响应头 X-Total-Count)"""
    resp = requests.get(API_URL, params={"_page": 1, "_limit": 1}, timeout=10)
    resp.raise_for_status()
    total = resp.headers.get("X-Total-Count")
    if total is None:
        raise RuntimeError("响应头中未找到 X-Total-Count")
    return int(total)

def main():
    total_count = get_total_count()
    total_pages = (total_count + PAGE_SIZE - 1) // PAGE_SIZE
    print(f"资源总数: {total_count}, 每页 {PAGE_SIZE} 条, 共 {total_pages} 页")

    all_posts = []
    for page in range(1, total_pages + 1):
        page_data = fetch_page(page, PAGE_SIZE)
        all_posts.extend(page_data)
        print(f"已获取第 {page}/{total_pages} 页, 当前累计 {len(all_posts)} 条")
        time.sleep(0.2)   # 礼貌性限速

    # 写入CSV(字段顺序取自第一条记录)
    if not all_posts:
        raise RuntimeError("未获取到任何数据")
    fieldnames = list(all_posts[0].keys())
    with open(OUTPUT_FILE, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(all_posts)

    print(f"完成! 共写入 {len(all_posts)} 条记录到 {OUTPUT_FILE}")

if __name__ == "__main__":
    main()
运行与验证
依赖安装:
pip install requests
运行方式:
python fetch_posts_paginated.py
验证方法:
- 程序正常结束时,控制台应打印“完成! 共写入 100 条记录到 posts_all.csv”(jsonplaceholder的/posts资源固定为100条)。
- 打开生成的
posts_all.csv,应包含表头userId,id,title,body,且数据行数应为100行(不含表头)。 - 检查
id列应包含1到100的连续整数,无缺失或重复,证明所有页面数据已完整合并。
判定标准
- 功能完整性:程序能自动发现总页数并循环抓取,无需人工指定页数;
- 数据完整性:CSV中记录数等于API返回的总数(100条),且
id字段无缺失、无重复; - 健壮性:单页临时故障时能自动重试,不会因网络抖动导致整个任务失败;
- 可复用性:修改
API_URL和PAGE_SIZE即可适配其他遵循相同分页约定的API。