3. 多层感知机分类
任务说明
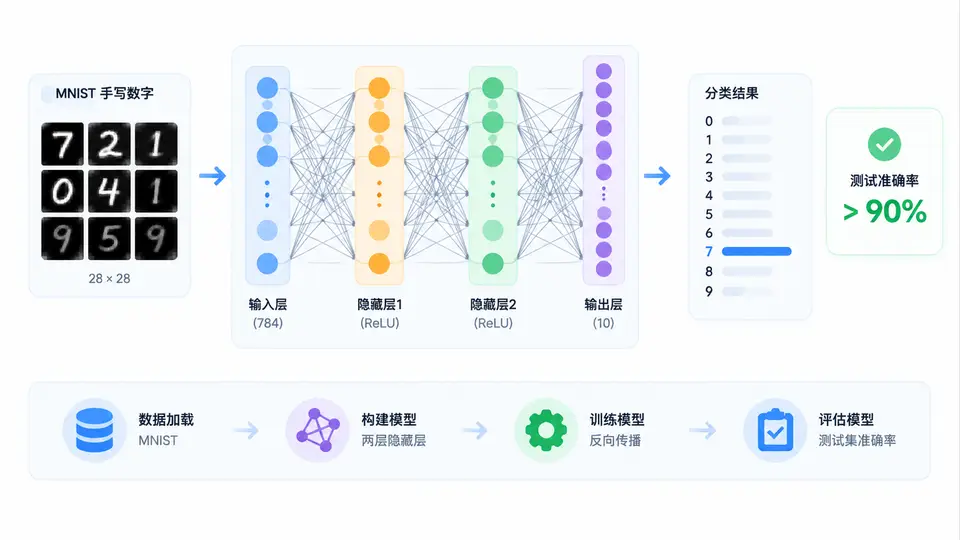
本案例使用PyTorch构建一个包含两个隐藏层的多层感知机(MLP),对MNIST手写数字数据集进行分类。输入为28×28像素的灰度图像(展平为784维向量),输出为10个类别的概率分布。目标是在测试集上达到90%以上的分类准确率。
实现方案
模型结构为:输入层(784) → 隐藏层1(256, ReLU) → 隐藏层2(128, ReLU) → 输出层(10)。使用交叉熵损失函数和Adam优化器,训练5个epoch,批量大小为64。数据预处理将像素值归一化到[0,1]区间。
完整代码
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# 1. 数据准备
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])

train_dataset = datasets.MNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = datasets.MNIST(root='./data', train=False, download=True, transform=transform)

train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=256, shuffle=False)

# 2. 定义模型(两个隐藏层)
class MLP(nn.Module):
    def __init__(self):
        super(MLP, self).__init__()
        self.fc1 = nn.Linear(784, 256)
        self.fc2 = nn.Linear(256, 128)
        self.fc3 = nn.Linear(128, 10)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = x.view(-1, 784)  # 展平
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        x = self.fc3(x)
        return x

# 3. 训练配置
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model = MLP().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 4. 训练循环
epochs = 5
for epoch in range(epochs):
    model.train()
    running_loss = 0.0
    for images, labels in train_loader:
        images, labels = images.to(device), labels.to(device)
        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
        running_loss += loss.item()
    avg_loss = running_loss / len(train_loader)
    print(f'Epoch [{epoch+1}/{epochs}], Loss: {avg_loss:.4f}')

# 5. 测试评估
model.eval()
correct = 0
total = 0
with torch.no_grad():
    for images, labels in test_loader:
        images, labels = images.to(device), labels.to(device)
        outputs = model(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

accuracy = 100.0 * correct / total
print(f'测试集准确率: {accuracy:.2f}%')
运行与验证
运行方式:在Python环境中执行上述代码。首次运行会自动下载MNIST数据集(约115MB)到./data目录。需要预先安装torch和torchvision包。
验证方法:观察训练过程中每个epoch的损失值是否逐步下降,训练结束后查看测试集准确率输出。若测试准确率≥90%,则任务达成。若未达到,可适当增加训练轮数或调整学习率。
预期输出:训练5个epoch后,测试集准确率约为97%~98%(该数值由模型结构和MNIST数据集特性决定,实际运行结果可能略有浮动)。