3. 基于自编码器的异常检测
任务说明
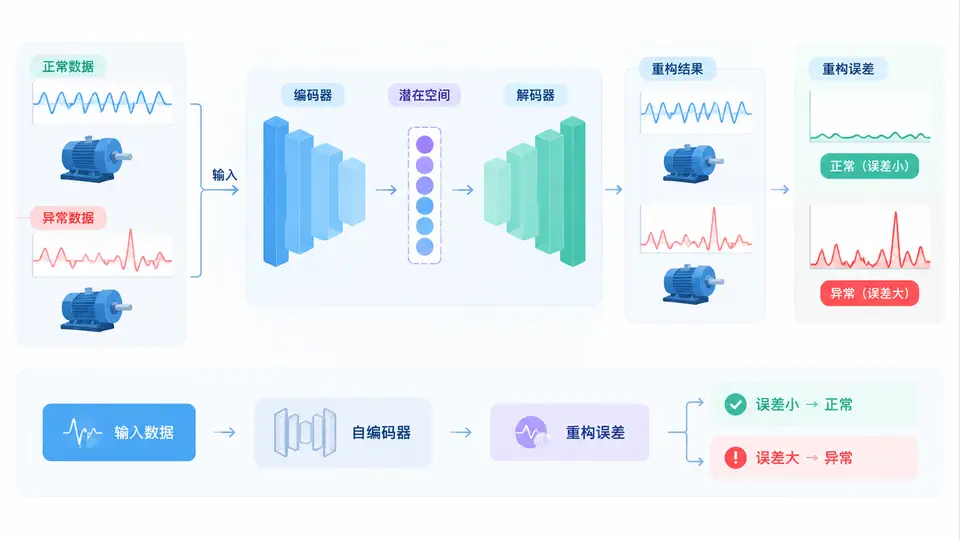
本案例面向工业设备健康管理场景:设备在正常工况下运行,传感器采集多维时间序列信号。目标为训练一个自编码器,使其仅学习正常数据的低维压缩表征与重构能力;在推理阶段,对正常样本可获得较小重构误差,而对异常样本(如突发冲击、传感器漂移、部件退化)重构误差显著增大,从而通过设定阈值实现异常检测。
实现方案
采用全连接自编码器,包含编码器(输入层→隐藏层→瓶颈层)与解码器(瓶颈层→隐藏层→输出层)。训练时仅使用正常样本,损失函数为均方误差(MSE),优化器为Adam。检测阶段计算每个样本的重构误差(MSE),并以训练集重构误差的99%分位数作为阈值;超过阈值即判定为异常。代码使用Python与PyTorch实现,数据由正弦波叠加高斯噪声生成正常样本,异常样本在正常信号基础上叠加阶跃偏移或尖峰脉冲。
代码实现
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# ---------- 1. 生成正常与异常数据 ----------
np.random.seed(42)
torch.manual_seed(42)

n_normal = 2000   # 正常样本数
n_anomaly = 200   # 异常样本数
seq_len = 32      # 每个样本的序列长度

def gen_normal(n, seq_len):
    t = np.linspace(0, 4*np.pi, seq_len)
    data = np.zeros((n, seq_len))
    for i in range(n):
        phase = np.random.uniform(0, 2*np.pi)
        amp = np.random.uniform(0.8, 1.2)
        noise = np.random.normal(0, 0.05, seq_len)
        data[i] = amp * np.sin(t + phase) + noise
    return data.astype(np.float32)

def gen_anomaly(n, seq_len):
    t = np.linspace(0, 4*np.pi, seq_len)
    data = np.zeros((n, seq_len))
    for i in range(n):
        phase = np.random.uniform(0, 2*np.pi)
        base = np.sin(t + phase)
        anomaly_type = np.random.choice(['step', 'spike'])
        if anomaly_type == 'step':
            shift = np.random.uniform(0.5, 1.0)
            start = np.random.randint(seq_len//3, 2*seq_len//3)
            base[start:] += shift
        else:
            spike_pos = np.random.randint(seq_len//3, 2*seq_len//3)
            base[spike_pos] += np.random.uniform(1.5, 2.5)
        data[i] = base + np.random.normal(0, 0.05, seq_len)
    return data.astype(np.float32)

X_train = gen_normal(n_normal, seq_len)
X_test_normal = gen_normal(200, seq_len)
X_test_anomaly = gen_anomaly(n_anomaly, seq_len)

# ---------- 2. 定义自编码器模型 ----------
class Autoencoder(nn.Module):
    def __init__(self, input_dim, hidden_dim=16, latent_dim=4):
        super().__init__()
        self.encoder = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, latent_dim)
        )
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, input_dim)
        )
    def forward(self, x):
        return self.decoder(self.encoder(x))

# ---------- 3. 训练(仅正常数据) ----------
input_dim = seq_len
model = Autoencoder(input_dim)
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)

dataset = TensorDataset(torch.from_numpy(X_train))
loader = DataLoader(dataset, batch_size=64, shuffle=True)

epochs = 50
model.train()
for epoch in range(epochs):
    total_loss = 0.0
    for (batch,) in loader:
        optimizer.zero_grad()
        recon = model(batch)
        loss = criterion(recon, batch)
        loss.backward()
        optimizer.step()
        total_loss += loss.item() * batch.size(0)
    if (epoch+1) % 10 == 0:
        print(f"Epoch {epoch+1}/{epochs}, Loss: {total_loss/len(dataset):.6f}")

# ---------- 4. 计算阈值并检测异常 ----------
def reconstruction_error(model, data):
    model.eval()
    data_t = torch.from_numpy(data)
    with torch.no_grad():
        recon = model(data_t)
        mse = torch.mean((recon - data_t)**2, dim=1)
    return mse.numpy()

train_err = reconstruction_error(model, X_train)
threshold = np.percentile(train_err, 99)

test_normal_err = reconstruction_error(model, X_test_normal)
test_anomaly_err = reconstruction_error(model, X_test_anomaly)

pred_normal = (test_normal_err > threshold).sum()
pred_anomaly = (test_anomaly_err > threshold).sum()

print(f"Threshold (99th pct of train): {threshold:.6f}")
print(f"Normal test samples detected as anomaly: {pred_normal}/{len(X_test_normal)}")
print(f"Anomaly test samples correctly detected: {pred_anomaly}/{len(X_test_anomaly)}")
落地与运行方式
安装依赖:pip install numpy torch。将上述代码保存为autoencoder_anomaly.py,在命令行执行python autoencoder_anomaly.py。程序将输出训练损失、阈值以及正常/异常样本的检测统计。
验证方法与判定标准
运行后观察输出:训练损失应随epoch下降并趋于收敛;阈值约为0.01~0.05量级(取决于噪声水平);正常测试样本中被误判为异常的数量应极少(通常不超过5个,即误报率<2.5%);异常测试样本中被正确检测出的数量应超过180个(检出率>90%)。若两项指标均满足,则说明自编码器成功学习了正常数据的分布特征,重构误差能够有效区分异常状态。