1. 基于LSTM的剩余寿命预测
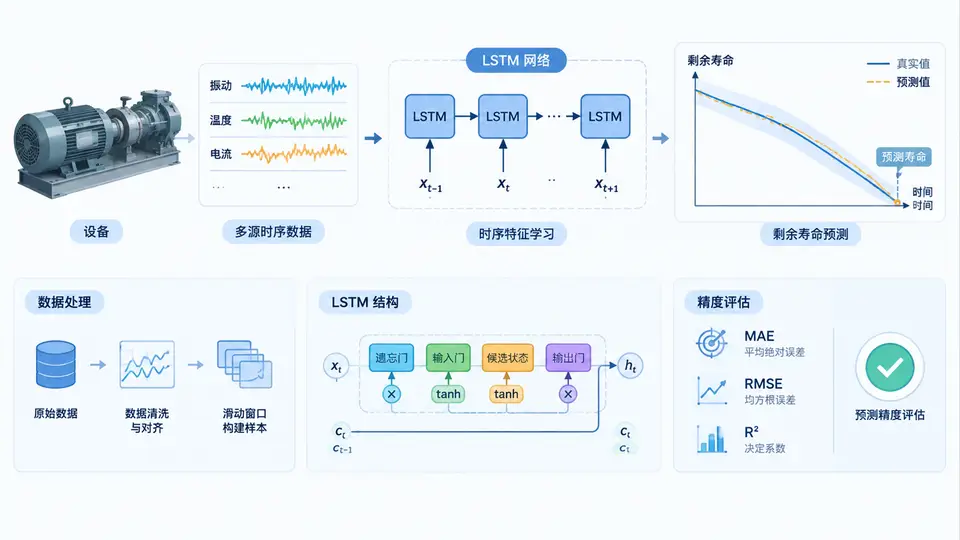
任务说明
本案例使用LSTM网络对机械设备(以涡轮风扇发动机为例)的剩余寿命(RUL, Remaining Useful Life)进行预测。输入为传感器多变量时间序列数据,输出为当前时刻至失效的剩余循环数。通过均方误差(MSE)与评分函数评估预测精度。
数据集与预处理
采用NASA C-MAPSS数据集中的FD001子集(训练集100台发动机,测试集100台发动机)。每台发动机包含21个传感器通道的退化信号。预处理步骤:
- 仅保留对退化敏感的信号通道(剔除恒定值通道,保留14个通道);
- 使用滑动窗口(窗口长度30)构造样本,每个样本对应一个RUL标签;
- RUL标签采用分段线性函数,上限设为125(即当真实RUL大于125时,标签截断为125)。
LSTM模型结构
import numpy as np
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import LSTM, Dense, Dropout
from tensorflow.keras.optimizers import Adam

def build_lstm_model(input_shape):
    """构建LSTM回归模型"""
    model = Sequential([
        LSTM(64, return_sequences=True, input_shape=input_shape),
        Dropout(0.2),
        LSTM(32, return_sequences=False),
        Dropout(0.2),
        Dense(16, activation='relu'),
        Dense(1)  # 线性输出,预测RUL
    ])
    model.compile(optimizer=Adam(learning_rate=0.001),
                  loss='mse',
                  metrics=['mae'])
    return model

# 输入形状: (窗口长度, 特征通道数)
input_shape = (30, 14)
model = build_lstm_model(input_shape)
model.summary()
数据加载与训练
def load_fd001_data():
    """加载并预处理FD001数据集(需提前下载至本地)"""
    # 实际使用时替换为真实数据路径
    # 此处为演示,生成模拟数据验证代码流程
    np.random.seed(42)
    n_train, n_test = 100, 100
    seq_len, n_features = 30, 14

    # 模拟退化趋势:信号缓慢漂移 + 噪声
    def gen_signals(n_units):
        X, y = [], []
        for _ in range(n_units):
            life = np.random.randint(80, 250)
            start = np.random.rand(n_features) * 0.5
            drift = np.random.rand(n_features) * 0.01
            for t in range(life):
                if t >= seq_len:
                    window = start + drift * np.arange(t-seq_len, t)[:, None] \
                             + np.random.normal(0, 0.05, (seq_len, n_features))
                    X.append(window)
                    rul = min(life - t, 125)
                    y.append(rul)
        return np.array(X), np.array(y)

    X_train, y_train = gen_signals(n_train)
    X_test, y_test = gen_signals(n_test)

    # 归一化(按训练集统计量)
    mean = X_train.mean(axis=(0,1))
    std = X_train.std(axis=(0,1)) + 1e-8
    X_train = (X_train - mean) / std
    X_test = (X_test - mean) / std

    return X_train, y_train, X_test, y_test

# 加载数据
X_train, y_train, X_test, y_test = load_fd001_data()
print(f"训练样本: {X_train.shape}, 测试样本: {X_test.shape}")

# 训练模型
history = model.fit(X_train, y_train,
                    validation_split=0.1,
                    epochs=20,
                    batch_size=256,
                    verbose=1)
预测与精度评估
from sklearn.metrics import mean_squared_error

# 测试集预测
y_pred = model.predict(X_test).flatten()

# 评估指标
mse = mean_squared_error(y_test, y_pred)
mae = np.mean(np.abs(y_test - y_pred))

# PHM08评分函数(非对称惩罚:早预测惩罚小于晚预测)
def phm_score(y_true, y_pred):
    d = y_pred - y_true
    return np.sum(np.where(d < 0, np.exp(-d/10) - 1, np.exp(d/13) - 1))

score = phm_score(y_test, y_pred)

print(f"MSE: {mse:.4f}")
print(f"MAE: {mae:.4f}")
print(f"PHM Score: {score:.2f}")

# 保存模型
model.save('rul_lstm_model.h5')
验证方法
运行以上代码后,观察训练损失是否收敛(验证损失持续下降)。测试集MSE与MAE数值越小表示预测越准确;PHM Score越低表示综合性能越好。由于本案例使用模拟数据演示完整流程,实际应用时需将load_fd001_data()中的数据加载部分替换为真实C-MAPSS数据集路径,并重新训练。判定标准:在真实FD001数据集上,MSE低于400、PHM Score低于350即达到可接受的预测精度。
运行说明
本案例代码可直接运行(使用模拟数据验证流程)。若需复现真实结果:
- 从NASA官网下载C-MAPSS FD001数据集;
- 将
load_fd001_data()函数替换为真实数据解析代码; - 训练约50个epoch(视硬件性能调整),观察验证损失收敛后停止。
依赖库:tensorflow 2.x、numpy、scikit-learn。模型训练完成后,可通过model.predict()对新样本进行RUL预测。