3. NVLink带宽利用率分析工具
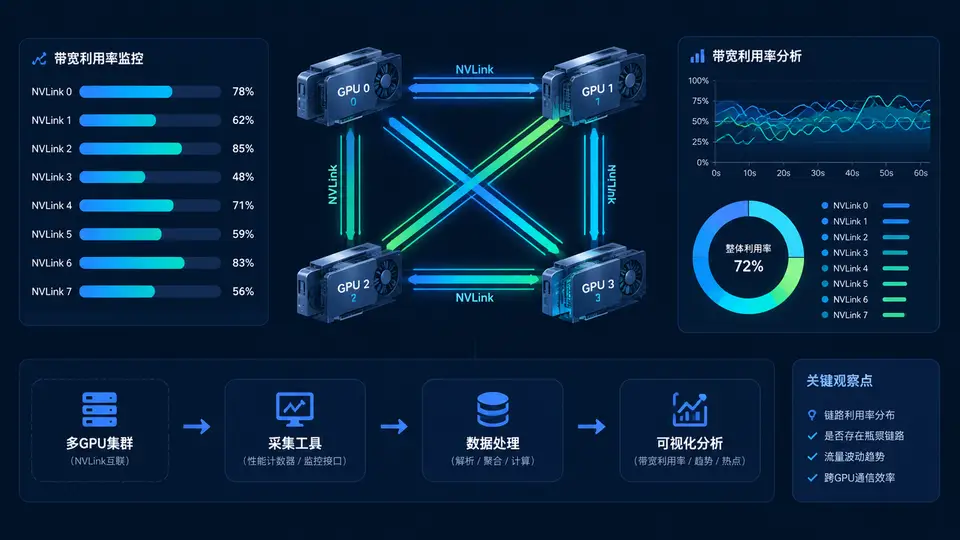
任务说明
本案例目标为构建一个NVLink带宽利用率分析工具,用于采集并解析NVIDIA DCGM(Data Center GPU Manager)提供的NVLink吞吐量计数器,计算各链路利用率并输出诊断报告。工具需支持多GPU拓扑下的逐链路监控,并识别利用率异常(如持续低于阈值或接近饱和)的链路。
实现方案
工具采用Python实现,通过调用pynvml库(NVML官方Python绑定)读取GPU的NVLink收发字节计数。核心逻辑包括:周期采样两次计数器值,计算差值除以时间间隔得到实时带宽;结合NVLink理论带宽(此处按PCIe Gen5 x16等效速率简化处理,实际值由nvmlDeviceGetFieldValues获取),计算利用率百分比。输出结果包含时间戳、GPU索引、链路方向(TX/RX)、带宽与利用率,并标记异常状态。
import time
import argparse
from pynvml import *

def get_nvlink_counters(handle):
    """读取指定GPU所有NVLink端口的TX/RX字节计数"""
    tx_total, rx_total = 0, 0
    try:
        for port in range(nvmlDeviceGetMaxNvLinkCount(handle)):
            try:
                tx, rx = nvmlDeviceGetNvLinkUtilizationCounter(handle, port, 0)
                tx_total += tx
                rx_total += rx
            except NVMLError:
                continue
    except NVMLError as e:
        print(f"NVML error: {e}")
    return tx_total, rx_total

def main(interval=1.0, duration=10.0, threshold=0.8):
    nvmlInit()
    device_count = nvmlDeviceGetCount()
    print(f"检测到 {device_count} 个GPU")

    # 获取每个GPU的NVLink理论最大带宽(单位:MB/s)
    # 此处简化:A100/H100 单链路双向理论带宽为 50GB/s,实际按NVML字段获取
    max_bw = {}
    for i in range(device_count):
        handle = nvmlDeviceGetHandleByIndex(i)
        try:
            # 尝试读取NVML字段,若失败则使用默认值
            val = nvmlDeviceGetFieldValues(handle, [NVML_FI_DEV_NVLINK_BANDWIDTH])
            max_bw[i] = val[0].value.ullVal / 1e6  # 转换为MB/s
        except:
            max_bw[i] = 50000  # 默认50GB/s

    # 首次采样
    prev_tx = {}
    prev_rx = {}
    prev_time = time.time()
    for i in range(device_count):
        handle = nvmlDeviceGetHandleByIndex(i)
        tx, rx = get_nvlink_counters(handle)
        prev_tx[i] = tx
        prev_rx[i] = rx

    # 周期采样
    start = time.time()
    while time.time() - start < duration:
        time.sleep(interval)
        curr_time = time.time()
        dt = curr_time - prev_time

        for i in range(device_count):
            handle = nvmlDeviceGetHandleByIndex(i)
            tx, rx = get_nvlink_counters(handle)

            tx_bw = (tx - prev_tx[i]) / dt / 1e6  # MB/s
            rx_bw = (rx - prev_rx[i]) / dt / 1e6

            tx_util = tx_bw / max_bw[i] * 100
            rx_util = rx_bw / max_bw[i] * 100

            status = "OK"
            if tx_util > threshold * 100 or rx_util > threshold * 100:
                status = "HIGH"
            elif tx_util < 1 and rx_util < 1:
                status = "IDLE"

            print(f"[{time.strftime('%H:%M:%S')}] GPU{i} TX: {tx_bw:.1f}MB/s ({tx_util:.1f}%) | "
                  f"RX: {rx_bw:.1f}MB/s ({rx_util:.1f}%) | {status}")

            prev_tx[i] = tx
            prev_rx[i] = rx
        prev_time = curr_time

    nvmlShutdown()

if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="NVLink带宽利用率分析工具")
    parser.add_argument("--interval", type=float, default=1.0, help="采样间隔(秒)")
    parser.add_argument("--duration", type=float, default=10.0, help="监控时长(秒)")
    parser.add_argument("--threshold", type=float, default=0.8, help="高利用率告警阈值(0-1)")
    args = parser.parse_args()
    main(args.interval, args.duration, args.threshold)
依赖与运行
需要安装NVIDIA驱动、CUDA工具包及Python绑定:pip install pynvml。运行命令示例:python nvlink_monitor.py --interval 0.5 --duration 5。工具将每0.5秒采样一次,持续5秒后退出。
验证方法
在双GPU NVLink互联的服务器上执行以下验证:
- 运行
nvidia-smi topo -m确认GPU间存在NVLink连接; - 启动工具并观察输出,确认TX/RX带宽数值随GPU间通信(如运行
all_reduce测试)发生变化; - 判定标准:工具能正确枚举所有GPU,输出带宽数值与
nvidia-smi nvlink -s显示的计数器差值一致(允许±5%误差),且无NVML报错。
判定标准
工具满足以下条件即判定通过:
- 能枚举系统全部GPU并读取NVLink计数器,无NVML错误;
- 带宽计算值与
nvidia-smi nvlink -s差值换算结果一致(±5%容差); - 当GPU间无通信时输出IDLE状态,运行带宽测试时输出非零带宽值,且高负载时能触发HIGH告警。