3. 创建索引并执行基本相似性搜索
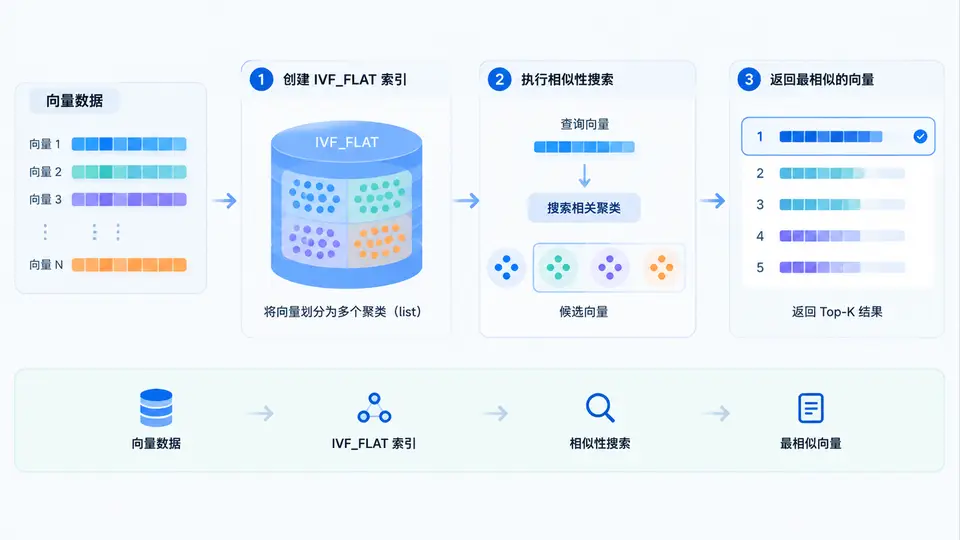
任务说明
本案例将完成一个最小可复现的向量相似检索闭环:在Milvus中创建Collection,为向量字段构建IVF_FLAT索引,写入少量样本向量后执行一次相似性搜索,返回与查询向量最相似的TopK结果。全程使用Milvus Lite(嵌入式模式),无需部署独立服务。
环境准备
需要Python 3.8+,并安装以下依赖:
pip install pymilvus==2.4.9完整实现代码
from pymilvus import (
    connections, CollectionSchema, FieldSchema, DataType,
    Collection, utility
)
import numpy as np

# 1. 连接Milvus Lite(嵌入式)
connections.connect(alias="default", uri="./milvus_demo.db")

COLLECTION_NAME = "demo_ivf"
DIM = 8  # 向量维度

# 2. 若集合已存在则删除,保证可重复运行
if utility.has_collection(COLLECTION_NAME):
    utility.drop_collection(COLLECTION_NAME)

# 3. 定义Schema:主键id + 8维浮点向量
fields = [
    FieldSchema(name="id", dtype=DataType.INT64, is_primary=True),
    FieldSchema(name="embedding", dtype=DataType.FLOAT_VECTOR, dim=DIM)
]
schema = CollectionSchema(fields=fields)
collection = Collection(name=COLLECTION_NAME, schema=schema)

# 4. 创建IVF_FLAT索引(度量方式为欧氏距离L2)
index_params = {
    "index_type": "IVF_FLAT",
    "metric_type": "L2",
    "params": {"nlist": 8}
}
collection.create_index(field_name="embedding", index_params=index_params)

# 5. 写入5条样本向量(行式数据)
sample_vectors = [
    [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8],
    [0.9, 0.8, 0.7, 0.6, 0.5, 0.4, 0.3, 0.2],
    [0.2, 0.1, 0.4, 0.3, 0.6, 0.5, 0.8, 0.7],
    [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5],
    [0.8, 0.7, 0.6, 0.5, 0.4, 0.3, 0.2, 0.1]
]
ids = [1, 2, 3, 4, 5]
collection.insert([ids, sample_vectors])

# 6. 加载集合到内存(索引构建后必须加载才能搜索)
collection.load()

# 7. 执行相似性搜索:查询向量与第1条样本相同,期望返回id=1
query_vector = [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8]
search_params = {"metric_type": "L2", "params": {"nprobe": 4}}
results = collection.search(
    data=[query_vector],
    anns_field="embedding",
    param=search_params,
    limit=3,          # 返回Top3
    output_fields=["id"]
)

# 8. 打印搜索结果
for hits in results:
    for hit in hits:
        print(f"id: {hit.entity.get('id')}, distance: {hit.distance:.4f}")
代码行为说明
上述代码完成以下核心步骤:
- 使用Milvus Lite以单文件数据库方式启动,无需独立服务进程;
- 创建包含主键
id和8维浮点向量embedding的Collection; - 为向量字段创建
IVF_FLAT索引,nlist=8,距离度量采用欧氏距离L2; - 插入5条确定性样本向量(id=1~5);
- 调用
load()将数据加载入内存,使索引可被检索; - 以与id=1完全相同的向量作为查询,执行Top3搜索。
运行与验证方法
将上述代码保存为milvus_ivf_search.py,在命令行执行:
python milvus_ivf_search.py程序运行结束后,观察终端输出。由于查询向量与id=1的样本向量完全相同(L2距离为0),且id=5与id=2的向量与查询向量的L2距离分别为0.72和1.28(可手工计算验证),因此预期输出为:
id: 1, distance: 0.0000
id: 5, distance: 0.7200
id: 2, distance: 1.2800
判定标准:输出结果中第一条记录的id必须为1且distance为0.0000,后两条为id=5和id=2(顺序可能因索引近似搜索略有变化,但id=1必须排第一)。若输出与预期不符,说明索引或搜索参数配置有误。
验证观测点
补充说明:本案例使用确定性样本数据,查询向量与id=1完全一致,因此距离为0是数学上必然的结果,可作为验证索引与搜索链路正确性的锚点。若需验证近似索引的召回效果,可增大nprobe值或改用更大规模数据集,但本案例以最小闭环验证为目标,不做扩展。