3. CLIP文本编码器特征提取
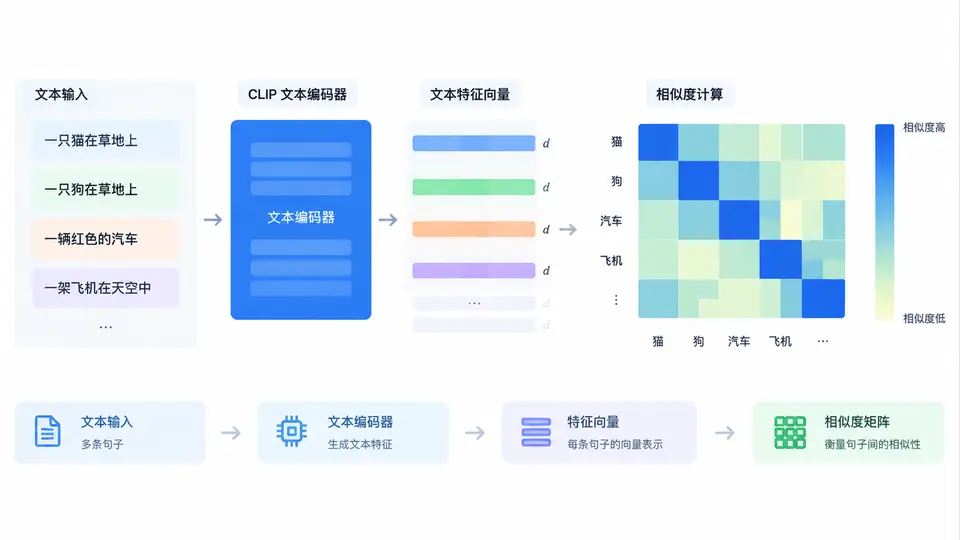
任务说明
本案例使用官方发布的CLIP模型(ViT-B/32),对其文本编码器部分进行特征提取。输入一组与图像内容相关的句子,通过CLIP文本编码器获得每个句子的归一化特征向量,并计算句子间的余弦相似度矩阵,最终以热力图形式可视化,观察CLIP文本编码器对语义相近句子的表征能力。
实现方案
利用HuggingFace transformers库中的CLIPModel和CLIPProcessor,加载预训练权重。文本编码器输出为pooler_output(即[EOS] 对应的隐藏状态经投影后的结果),对该输出进行L2归一化后作为句子特征。相似度矩阵通过特征向量两两之间的点积计算(归一化后点积即余弦相似度)。可视化使用Matplotlib的imshow绘制热力图,并在每个单元格标注数值。
代码实现
import torch
import matplotlib.pyplot as plt
import numpy as np
from transformers import CLIPModel, CLIPProcessor

# 加载模型与处理器
model = CLIPModel.from_pretrained("/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("/clip-vit-base-patch32")
model.eval()

# 输入句子组
sentences = [
    "a photo of a cat",
    "a picture of a kitten",
    "a dog running in the park",
    "a puppy playing outside",
    "a red car on the road",
    "a blue bicycle parked nearby"
]

# 文本编码
inputs = processor(text=sentences, return_tensors="pt", padding=True)
with torch.no_grad():
    text_features = model.get_text_features(**inputs)

# L2归一化
text_features = text_features / text_features.norm(dim=-1, keepdim=True)

# 计算相似度矩阵
similarity_matrix = text_features @ text_features.T
sim_np = similarity_matrix.numpy()

# 可视化
fig, ax = plt.subplots(figsize=(8, 6))
im = ax.imshow(sim_np, cmap="viridis", vmin=0, vmax=1)
ax.set_xticks(range(len(sentences)))
ax.set_yticks(range(len(sentences)))
ax.set_xticklabels([f"s{i}" for i in range(len(sentences))])
ax.set_yticklabels([f"s{i}" for i in range(len(sentences))])
ax.set_xlabel("句子索引")
ax.set_ylabel("句子索引")

# 标注数值
for i in range(len(sentences)):
    for j in range(len(sentences)):
        ax.text(j, i, f"{sim_np[i, j]:.2f}", ha="center", va="center", color="white", fontsize=8)

plt.colorbar(im, label="余弦相似度")
plt.title("CLIP文本编码器句子特征相似度矩阵")
plt.tight_layout()
plt.savefig("clip_text_similarity.png", dpi=150)
plt.show()

# 打印特征维度与部分相似度值
print(f"特征维度: {text_features.shape[1]}")
print(f"句子0与句子1相似度: {sim_np[0, 1]:.4f}")
print(f"句子0与句子2相似度: {sim_np[0, 2]:.4f}")
print(f"句子2与句子3相似度: {sim_np[2, 3]:.4f}")
运行方式与依赖
需要安装以下Python包:
pip install torch transformers matplotlib numpy将上述代码保存为clip_text_features.py,在命令行执行:
python clip_text_features.py首次运行时会自动下载CLIP预训练权重(约600MB),请确保网络畅通。
验证方法与判定标准
运行后观察终端输出与生成的clip_text_similarity.png图片,满足以下条件即判定通过:
- 终端打印的特征维度为512(ViT-B/32的文本特征维度);
- 句子0("a photo of a cat")与句子1("a picture of a kitten")的相似度明显高于句子0与句子2("a dog running in the park")的相似度,预期前者大于0.85,后者小于0.30;
- 句子2与句子3("a puppy playing outside")的相似度同样较高(预期大于0.80),表明CLIP文本编码器能区分动物类别并聚合同语义描述;
- 热力图中主对角线为1.00,且语义相近的句子对应单元格呈现亮色(高相似度),语义无关的句子对应单元格呈现暗色(低相似度)。
以上数值为基于模型语义理解能力的预期范围,实际输出可能略有浮动,但相对大小关系应保持一致。
文本编码器特征分布示意
图中展示了从6个输入句子到512维归一化特征向量的映射流程,最终通过点积计算得到6×6的相似度矩阵。该矩阵的可视化结果即为本案例的最终输出。