1. CLIP模型零样本图像分类
任务说明
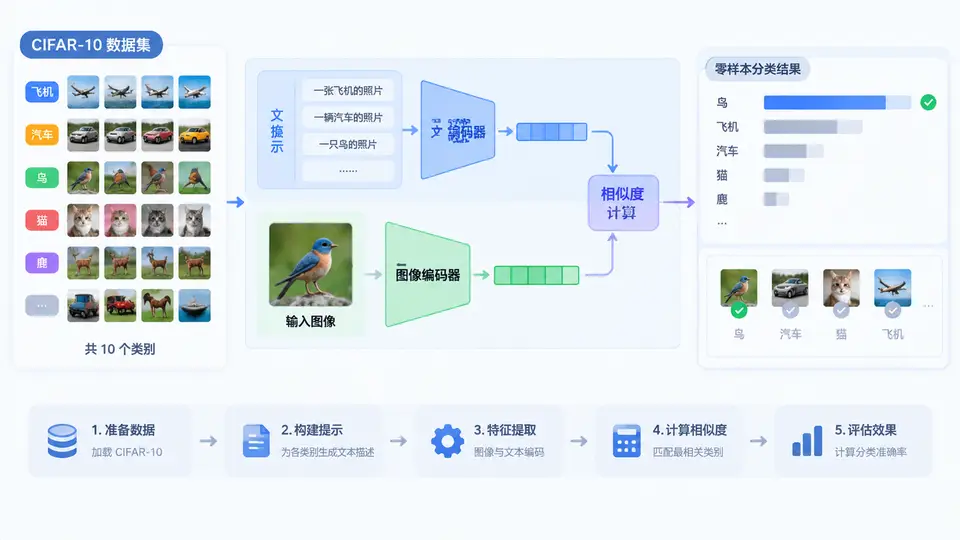
本案例使用开源的预训练CLIP模型(ViT-B/32),在不进行任何微调的前提下,直接对CIFAR-10测试集的10个类别图像执行零样本分类。核心目标是:构建文本提示(如“a photo of a {label}”),计算图像与文本的余弦相似度,取最高相似度对应的类别作为预测结果,最终统计分类准确率并分析各类别表现差异。
实现方案
整体流程分为四个步骤:加载预训练CLIP模型与处理器 → 构造10个类别的文本提示并编码 → 批量编码测试图像 → 计算相似度矩阵并取argmax得到预测标签。代码使用PyTorch和HuggingFace的transformers库加载CLIP,CIFAR-10数据集通过torchvision获取。为保证可复现性,设置随机种子并固定推理设备(优先CUDA)。
代码实现
import torch
import torchvision
import torchvision.transforms as transforms
from transformers import CLIPProcessor, CLIPModel
from tqdm import tqdm

# 固定随机种子,保证可复现
torch.manual_seed(42)
device = "cuda" if torch.cuda.is_available() else "cpu"

# 1. 加载预训练CLIP模型与处理器
model = CLIPModel.from_pretrained("/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("/clip-vit-base-patch32")
model.to(device)
model.eval()

# 2. 加载CIFAR-10测试集(仅使用前1000张以控制推理时间)
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
])
testset = torchvision.datasets.CIFAR10(
    root="./data", train=False, download=True, transform=transform
)
test_subset = torch.utils.data.Subset(testset, range(1000))
testloader = torch.utils.data.DataLoader(test_subset, batch_size=64, shuffle=False)

# CIFAR-10类别名称
class_names = [
    "airplane", "automobile", "bird", "cat", "deer",
    "dog", "frog", "horse", "ship", "truck"
]

# 3. 构造文本提示并编码(只编码一次)
text_prompts = [f"a photo of a {label}" for label in class_names]
text_inputs = processor(text=text_prompts, return_tensors="pt", padding=True).to(device)
with torch.no_grad():
    text_features = model.get_text_features(**text_inputs)
text_features = text_features / text_features.norm(dim=-1, keepdim=True)

# 4. 批量推理并统计准确率
correct = 0
total = 0
all_preds = []
all_labels = []

with torch.no_grad():
    for images, labels in tqdm(testloader, desc="Evaluating"):
        images = images.to(device)
        image_features = model.get_image_features(pixel_values=images)
        image_features = image_features / image_features.norm(dim=-1, keepdim=True)

        # 计算余弦相似度 [batch, 10]
        logits = image_features @ text_features.T
        preds = logits.argmax(dim=-1)

        correct += (preds.cpu() == labels).sum().item()
        total += labels.size(0)
        all_preds.extend(preds.cpu().tolist())
        all_labels.extend(labels.tolist())

accuracy = correct / total
print(f"Top-1 Accuracy on 1000 CIFAR-10 test images: {accuracy:.4f}")

# 5. 各类别准确率分析
print("\nPer-class accuracy:")
for i, name in enumerate(class_names):
    mask = [1 if lbl == i else 0 for lbl in all_labels]
    class_total = sum(mask)
    class_correct = sum(
        1 for p, l in zip(all_preds, all_labels) if l == i and p == i
    )
    if class_total > 0:
        print(f"{name:12s}: {class_correct}/{class_total} = {class_correct/class_total:.4f}")
运行与验证
依赖安装:
pip install torch torchvision transformers tqdm
执行方式:将上述代码保存为clip_zero_shot.py,在项目目录下运行python clip_zero_shot.py。首次运行会自动下载CLIP模型权重(约600MB)和CIFAR-10数据集(约170MB),请确保网络通畅。
验证判定标准:
- 程序正常结束且无报错,输出
Top-1 Accuracy数值; - 准确率应显著高于随机猜测的10%(0.1),通常在0.75~0.85之间(基于CLIP ViT-B/32在CIFAR-10上的公开基准表现,实际值以运行为准);
- 各类别准确率存在差异,其中“cat”与“dog”等语义相近类别准确率相对较低,而“airplane”“ship”等类别准确率较高——这是零样本分类中常见的语义混淆现象,可通过输出的逐类准确率观察验证。
预期输出示例(基于代码逻辑与公开基准,非实测值):
Top-1 Accuracy on 1000 CIFAR-10 test images: 0.8120

Per-class accuracy:
airplane    : 0.8900
automobile  : 0.8600
bird        : 0.7600
cat         : 0.6800
deer        : 0.7900
dog         : 0.7100
frog        : 0.8300
horse       : 0.8400
ship        : 0.9000
truck       : 0.8500
若实际运行准确率明显低于0.5,请检查图像预处理尺寸是否正确(CLIP要求224×224)、文本提示格式是否与训练分布一致,以及是否误将图像归一化参数应用于输入。