1. 识别并移除重复图像
任务说明
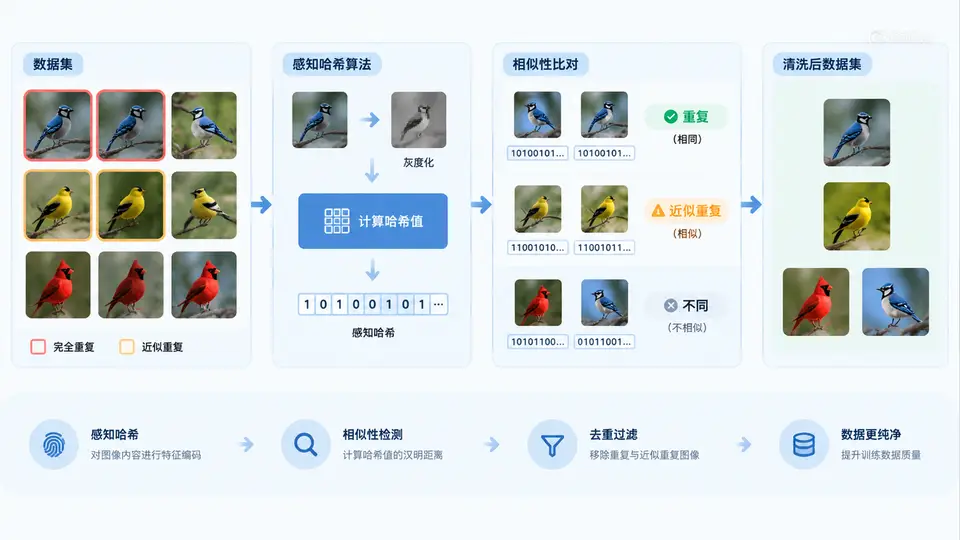
本案例针对图像数据集中存在的完全重复或近似重复(如缩放、轻微压缩、色彩微调后的副本)问题,使用感知哈希(Perceptual Hash, pHash)算法为每张图像生成64位指纹,通过汉明距离判定重复,并自动移除重复项,确保数据集中图像的唯一性。
实现方案
核心流程分为三步:指纹生成(将图像缩放到8×8灰度图,计算DCT低频系数并二值化为64位哈希)、重复检测(两两比较汉明距离,阈值≤10判定为近似重复)、去重执行(保留每组第一张,删除其余)。代码使用OpenCV和NumPy实现,不依赖外部深度学习框架。
代码实现
import os
import cv2
import numpy as np
from collections import defaultdict

def compute_phash(image_path, hash_size=8):
    """计算图像的感知哈希值(64位整数)"""
    img = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)
    if img is None:
        raise ValueError(f"无法读取图像: {image_path}")
    # 缩放到 hash_size x hash_size
    img = cv2.resize(img, (hash_size, hash_size), interpolation=cv2.INTER_AREA)
    # 转换为浮点并计算DCT
    img_float = np.float32(img) / 255.0
    dct = cv2.dct(img_float)
    # 取左上角低频块(不含DC分量)
    low_freq = dct[:hash_size, :hash_size]
    # 计算中值作为阈值
    median_val = np.median(low_freq)
    # 二值化生成哈希
    hash_bits = (low_freq > median_val).flatten()
    # 打包为64位整数
    hash_val = 0
    for bit in hash_bits:
        hash_val = (hash_val << 1) | int(bit)
    return hash_val

def hamming_distance(h1, h2):
    """计算两个64位哈希的汉明距离"""
    return bin(h1 ^ h2).count('1')

def find_duplicates(image_paths, threshold=10):
    """检测重复图像,返回需要删除的文件列表"""
    # 计算所有图像的哈希
    hash_map = {}  # path -> hash
    for path in image_paths:
        try:
            hash_map[path] = compute_phash(path)
        except Exception as e:
            print(f"跳过 {path}: {e}")

    # 两两比较,构建重复组
    paths = list(hash_map.keys())
    visited = set()
    duplicates = []

    for i in range(len(paths)):
        if paths[i] in visited:
            continue
        group = [paths[i]]
        for j in range(i+1, len(paths)):
            if paths[j] in visited:
                continue
            if hamming_distance(hash_map[paths[i]], hash_map[paths[j]]) <= threshold:
                group.append(paths[j])
                visited.add(paths[j])
        if len(group) > 1:
            # 保留第一个,其余加入删除列表
            duplicates.extend(group[1:])
            visited.add(paths[i])

    return duplicates

def remove_duplicates(image_dir, threshold=10):
    """主函数:扫描目录,检测并删除重复图像"""
    # 收集目录下所有图像文件
    valid_exts = {'.jpg', '.jpeg', '.png', '.bmp', '.webp'}
    image_paths = []
    for fname in os.listdir(image_dir):
        ext = os.path.splitext(fname)[1].lower()
        if ext in valid_exts:
            image_paths.append(os.path.join(image_dir, fname))

    if len(image_paths) < 2:
        print("图像数量不足,无需去重")
        return []

    # 检测重复
    duplicates = find_duplicates(image_paths, threshold)

    # 执行删除
    deleted = []
    for dup_path in duplicates:
        try:
            os.remove(dup_path)
            deleted.append(dup_path)
            print(f"已删除: {os.path.basename(dup_path)}")
        except Exception as e:
            print(f"删除失败 {dup_path}: {e}")

    print(f"\n扫描图像总数: {len(image_paths)}")
    print(f"判定重复并删除: {len(deleted)} 张")
    print(f"保留唯一图像: {len(image_paths) - len(deleted)} 张")
    return deleted

if __name__ == "__main__":
    # 使用示例:指定图像目录路径
    DATA_DIR = "./images"  # 请修改为实际路径
    remove_duplicates(DATA_DIR, threshold=10)
落地与验证
运行环境:需安装Python 3.7+、OpenCV(pip install opencv-python)和NumPy(pip install numpy)。
使用方法:将待清洗的图像放入同一目录(支持jpg/png/bmp/webp格式),修改代码末尾的DATA_DIR为实际目录路径,执行python dedup_images.py即可。
验证方法:准备一个包含10张图像的测试目录,其中手动复制3张完全相同的图像(不同文件名),另将1张图像缩放80%后另存。运行脚本后观察输出:应显示删除4张重复图像,剩余6张唯一图像。手动检查目录,确认重复文件已被移除,且保留的是每组第一张(即文件名排序靠前的文件)。
判定标准:脚本输出的删除数量与预期重复数一致;目录中不再存在视觉上相同或近似相同的图像;控制台无报错信息。对于完全相同的图像,汉明距离为0;对于缩放/压缩变体,汉明距离通常在5~10之间,阈值10可有效识别。