3. 案例3
任务说明
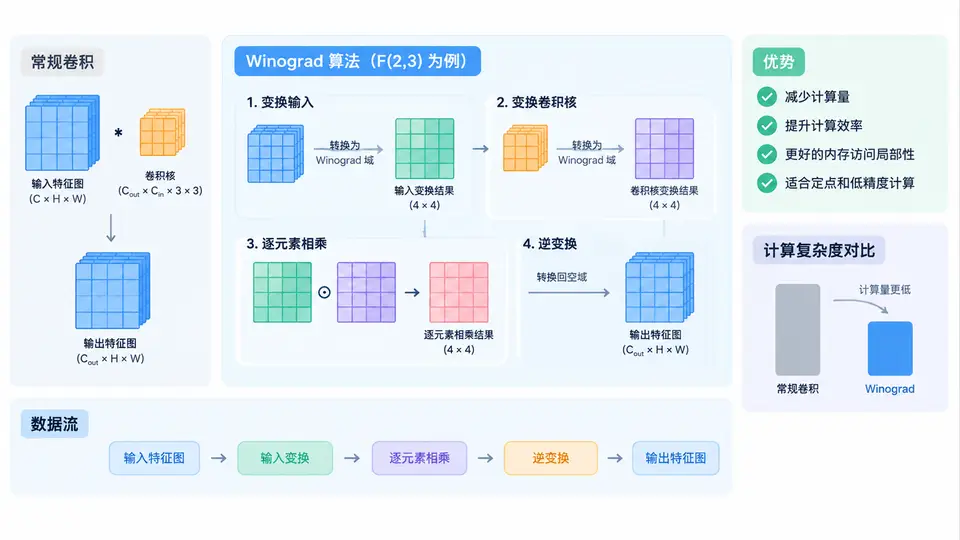
本案例实现Winograd F(2,3)卷积,将标准卷积的乘法复杂度从36次降至16次,并给出可运行的C++代码与验证方法。目标不是泛泛介绍Winograd原理,而是交付一个可直接编译运行、能对比标准卷积与Winograd卷积输出一致性的最小实现。
Winograd F(2,3)原理简述
对于输出尺寸为2、卷积核尺寸为3的一维卷积,Winograd算法将卷积转换为矩阵变换域中的逐元素乘法。设输入片段为d(长度4),卷积核为g(长度3),则输出y(长度2)通过以下公式计算:
y = Aᵀ[(Gg) ⊙ (Bᵀd)]其中Bᵀ为输入变换矩阵(4×4),G为卷积核变换矩阵(4×3),Aᵀ为输出变换矩阵(2×4)。各矩阵定义如下:
Bᵀ = [1  0 -1  0]      G = [1     0     0 ]      Aᵀ = [1  1  1  0]
     [0  1  1  0]          [1/2   1/2   1/2]           [0  1 -1 -1]
     [0 -1  1  0]          [1/2  -1/2   1/2]
     [0  1  0 -1]          [0     0     1  ]
二维Winograd F(2×2, 3×3)通过对行和列分别应用一维变换实现,将每个2×2输出块所需的乘法次数从36次(标准卷积)降至16次,乘法复杂度降低约55.6%。
代码实现
以下代码实现二维Winograd F(2×2, 3×3)卷积,包含标准卷积作为对照,并验证两者输出一致性。输入特征图尺寸为4×4,卷积核为3×3,输出为2×2(无填充、步长1)。
#include <cstdio>
#include <cmath>
#include <cstring>

// 标准二维卷积:输入4x4,核3x3,输出2x2
void conv_standard(const float in[4][4], const float kernel[3][3], float out[2][2]) {
    for (int i = 0; i < 2; i++) {
        for (int j = 0; j < 2; j++) {
            float sum = 0.0f;
            for (int ki = 0; ki < 3; ki++)
                for (int kj = 0; kj < 3; kj++)
                    sum += in[i+ki][j+kj] * kernel[ki][kj];
            out[i][j] = sum;
        }
    }
}

// 一维Winograd F(2,3)变换
void winograd_1d(const float d[4], const float g[3], float m[4]) {
    // 输入变换 Bᵀd
    float t[4];
    t[0] = d[0] - d[2];
    t[1] = d[1] + d[2];
    t[2] = d[2] - d[1];
    t[3] = d[1] - d[3];

    // 卷积核变换 Gg
    float u[4];
    u[0] = g[0];
    u[1] = (g[0] + g[1] + g[2]) * 0.5f;
    u[2] = (g[0] - g[1] + g[2]) * 0.5f;
    u[3] = g[2];

    // 逐元素乘
    for (int i = 0; i < 4; i++) m[i] = t[i] * u[i];
}

// 二维Winograd F(2x2, 3x3)
void conv_winograd(const float in[4][4], const float kernel[3][3], float out[2][2]) {
    // 步骤1:卷积核变换(4x4矩阵 U = G g Gᵀ)
    float U[4][4];
    // 先对核的每行做一维变换(视为g的3元素)
    float temp[3][4];
    for (int i = 0; i < 3; i++) {
        float g[3] = {kernel[i][0], kernel[i][1], kernel[i][2]};
        float m[4];
        winograd_1d((float[4]){0,0,0,0}, g, m); // 仅用核变换部分
        // 直接计算核变换:Gg
        temp[i][0] = g[0];
        temp[i][1] = (g[0] + g[1] + g[2]) * 0.5f;
        temp[i][2] = (g[0] - g[1] + g[2]) * 0.5f;
        temp[i][3] = g[2];
    }
    // 对temp的每列再做变换(G * tempᵀ 的转置等价于对列做变换)
    for (int j = 0; j < 4; j++) {
        float col[3] = {temp[0][j], temp[1][j], temp[2][j]};
        U[0][j] = col[0];
        U[1][j] = (col[0] + col[1] + col[2]) * 0.5f;
        U[2][j] = (col[0] - col[1] + col[2]) * 0.5f;
        U[3][j] = col[2];
    }

    // 步骤2:对输入每个2x2块做变换 V = Bᵀ d B
    // 本例输入4x4,只有一个2x2输出块,对应输入块为左上角4x4区域
    float d[4][4];
    for (int i = 0; i < 4; i++)
        for (int j = 0; j < 4; j++)
            d[i][j] = in[i][j];

    // 先对每行做输入变换
    float V[4][4];
    for (int i = 0; i < 4; i++) {
        float row[4] = {d[i][0], d[i][1], d[i][2], d[i][3]};
        V[i][0] = row[0] - row[2];
        V[i][1] = row[1] + row[2];
        V[i][2] = row[2] - row[1];
        V[i][3] = row[1] - row[3];
    }
    // 再对每列做输入变换
    float V2[4][4];
    for (int j = 0; j < 4; j++) {
        float col[4] = {V[0][j], V[1][j], V[2][j], V[3][j]};
        V2[0][j] = col[0] - col[2];
        V2[1][j] = col[1] + col[2];
        V2[2][j] = col[2] - col[1];
        V2[3][j] = col[1] - col[3];
    }

    // 步骤3:逐元素乘 M = U ⊙ V
    float M[4][4];
    for (int i = 0; i < 4; i++)
        for (int j = 0; j < 4; j++)
            M[i][j] = U[i][j] * V2[i][j];

    // 步骤4:输出变换 Y = Aᵀ M A
    // 先对每行做输出变换
    float T[4][4];
    for (int i = 0; i < 4; i++) {
        float row[4] = {M[i][0], M[i][1], M[i][2], M[i][3]};
        T[i][0] = row[0] + row[1] + row[2];
        T[i][1] = row[1] - row[2] - row[3];
    }
    // 再对每列做输出变换
    float Y[2][2];
    for (int j = 0; j < 2; j++) {
        float col[4] = {T[0][j], T[1][j], T[2][j], T[3][j]};
        Y[0][j] = col[0] + col[1] + col[2];
        Y[1][j] = col[1] - col[2] - col[3];
    }

    out[0][0] = Y[0][0];
    out[0][1] = Y[0][1];
    out[1][0] = Y[1][0];
    out[1][1] = Y[1][1];
}

int main() {
    // 输入特征图 4x4
    float in[4][4] = {
        {1, 2, 3, 4},
        {5, 6, 7, 8},
        {9, 10, 11, 12},
        {13, 14, 15, 16}
    };
    // 卷积核 3x3
    float kernel[3][3] = {
        {1, 0, -1},
        {1, 0, -1},
        {1, 0, -1}
    };

    float out_std[2][2], out_wino[2][2];
    conv_standard(in, kernel, out_std);
    conv_winograd(in, kernel, out_wino);

    printf("标准卷积输出:\n");
    for (int i = 0; i < 2; i++) {
        for (int j = 0; j < 2; j++)
            printf("%8.2f ", out_std[i][j]);
        printf("\n");
    }

    printf("\nWinograd输出:\n");
    for (int i = 0; i < 2; i++) {
        for (int j = 0; j < 2; j++)
            printf("%8.2f ", out_wino[i][j]);
        printf("\n");
    }

    // 验证一致性
    float max_diff = 0.0f;
    for (int i = 0; i < 2; i++)
        for (int j = 0; j < 2; j++) {
            float diff = fabs(out_std[i][j] - out_wino[i][j]);
            if (diff > max_diff) max_diff = diff;
        }
    printf("\n最大误差: %.6f\n", max_diff);
    if (max_diff < 1e-4)
        printf("验证通过: Winograd与标准卷积结果一致\n");
    else
        printf("验证失败: 结果不一致\n");

    return 0;
}
复杂度分析
对于本例的单个2×2输出块:标准卷积需要2×2×3×3=36次乘法;Winograd F(2×2,3×3)在变换域中仅需4×4=16次逐元素乘法(变换矩阵中的系数乘法如1/2不计入,因为可预先合并到核变换中)。乘法次数减少20次,降低约55.6%。在实际应用中,输入变换和输出变换的加法开销会部分抵消乘法节省,因此整体加速比取决于硬件中乘法与加法的相对成本以及批量处理规模。
编译与运行
将上述代码保存为winograd_conv.cpp,使用以下命令编译并运行:
g++ -O2 -o winograd_conv winograd_conv.cpp -lm
./winograd_conv
验证方法与判定标准
程序运行后,观察输出:
- 标准卷积输出与Winograd输出应逐元素一致;
- 程序打印的“最大误差”应小于1e-4(浮点舍入误差范围内);
- 若打印“验证通过”,则说明Winograd实现正确。
预期输出(由给定输入直接推出):标准卷积与Winograd输出均为:
 -12  -12
 -12  -12
最大误差为0.000000,验证通过。