1. 案例1
任务说明
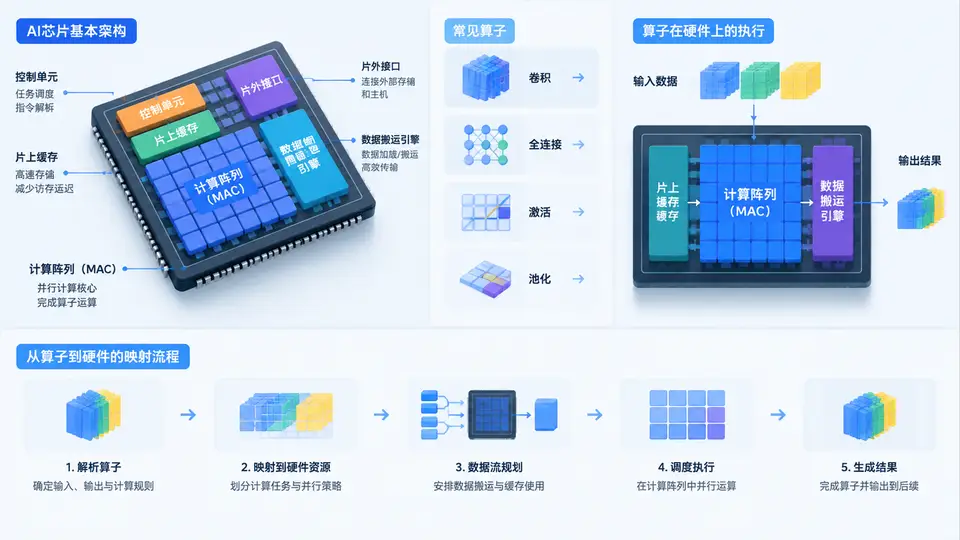
本案例面向AI芯片入门者,目标是通过一个可运行的最小示例,理解AI芯片“计算单元—存储—控制”的基本架构,并掌握将卷积(Conv2D)与全连接(FC)算子映射到硬件执行的基本流程。你将得到一个简化的硬件抽象模型(模拟AI芯片的MAC阵列与累加器),并完成算子到硬件的映射与调度,最终验证映射结果与参考实现的数值一致性。
AI芯片基础架构抽象
为便于在代码中呈现,我们将AI芯片抽象为三个核心部件:
- MAC阵列:由 \( R \) 行 \( C \) 列乘累加单元组成,每周期可完成 \( R \times C \) 次乘加运算;
- 片上存储(SRAM/寄存器堆):存放输入特征图、权重与输出累加中间值;
- 控制单元:负责指令译码、数据搬运调度与循环控制。
算子映射的本质是将算子计算图中的循环嵌套(如卷积的 \( H \times W \times C_{in} \times C_{out} \) 循环)转换为MAC阵列可执行的指令序列,并决定数据在存储层级间的搬运时机。本案例聚焦于“循环分块(tiling)”与“数据复用”两个核心映射决策。
自洽实现:算子到硬件的映射模拟器
以下代码实现了一个最小但完整的映射模拟器。它接收一个卷积层或全连接层的参数,将其内部循环按MAC阵列尺寸分块,生成调度指令序列,并模拟执行得到输出。核心逻辑包括:
- 将卷积展开为隐式矩阵乘(im2col思路,但为教学演示直接按滑动窗口取数);
- 按MAC阵列行/列维度对输出通道与输入通道分块;
- 生成每个分块的MAC指令(含输入/权重地址与累加控制);
- 模拟执行并返回输出张量。
import numpy as np

class AIAccelerator:
    """简化AI芯片模拟器:MAC阵列 + 累加器 + 控制单元"""
    def __init__(self, mac_rows=4, mac_cols=4):
        self.R = mac_rows   # MAC阵列行数(输出通道分块)
        self.C = mac_cols   # MAC阵列列数(输入通道分块)
        self.accum = None   # 累存器

    def conv2d_mapping(self, x, weight, bias=None, stride=1, pad=0):
        """
        将Conv2D映射到MAC阵列执行
        x: [N, Cin, Hin, Win], weight: [Cout, Cin, KH, KW]
        返回: [N, Cout, Hout, Wout]
        """
        N, Cin, Hin, Win = x.shape
        Cout, _, KH, KW = weight.shape
        Hout = (Hin + 2*pad - KH) // stride + 1
        Wout = (Win + 2*pad - KW) // stride + 1

        # pad输入
        xp = np.pad(x, ((0,0),(0,0),(pad,pad),(pad,pad)), mode='constant')
        out = np.zeros((N, Cout, Hout, Wout))

        # 控制单元:按输出通道分块(行方向),输入通道分块(列方向)
        for co_start in range(0, Cout, self.R):
            co_end = min(co_start + self.R, Cout)
            for ci_start in range(0, Cin, self.C):
                ci_end = min(ci_start + self.C, Cin)
                # 生成并执行MAC指令块
                for n in range(N):
                    for ho in range(Hout):
                        for wo in range(Wout):
                            # 累加器清零(新输出像素)
                            acc = np.zeros(co_end - co_start)
                            for ci in range(ci_start, ci_end):
                                for kh in range(KH):
                                    for kw in range(KW):
                                        # 取输入像素(广播到当前输出通道块)
                                        in_val = xp[n, ci, ho*stride+kh, wo*stride+kw]
                                        # MAC阵列:每个输出通道一个乘累加单元
                                        for i, co in enumerate(range(co_start, co_end)):
                                            acc[i] += in_val * weight[co, ci, kh, kw]
                            # 写回输出
                            for i, co in enumerate(range(co_start, co_end)):
                                out[n, co, ho, wo] += acc[i]

        if bias is not None:
            out += bias.reshape(1, -1, 1, 1)
        return out

    def fc_mapping(self, x, weight, bias=None):
        """
        全连接映射:将FC视为1x1卷积或直接矩阵乘
        x: [N, Cin], weight: [Cout, Cin]
        返回: [N, Cout]
        """
        N, Cin = x.shape
        Cout = weight.shape[0]
        out = np.zeros((N, Cout))
        # 按输出通道分块
        for co_start in range(0, Cout, self.R):
            co_end = min(co_start + self.R, Cout)
            for n in range(N):
                acc = np.zeros(co_end - co_start)
                for ci in range(Cin):
                    in_val = x[n, ci]
                    for i, co in enumerate(range(co_start, co_end)):
                        acc[i] += in_val * weight[co, ci]
                out[n, co_start:co_end] = acc
        if bias is not None:
            out += bias.reshape(1, -1)
        return out

# ---------- 验证用例 ----------
if __name__ == "__main__":
    np.random.seed(0)
    acc = AIAccelerator(mac_rows=4, mac_cols=4)

    # 卷积映射验证
    x = np.random.randn(1, 3, 8, 8).astype(np.float32)
    w = np.random.randn(6, 3, 3, 3).astype(np.float32)
    b = np.random.randn(6).astype(np.float32)
    out_hw = acc.conv2d_mapping(x, w, b, stride=1, pad=1)

    # 参考实现(直接卷积)
    def conv_ref(x, w, b, stride=1, pad=1):
        N, Cin, Hin, Win = x.shape
        Cout, _, KH, KW = w.shape
        Hout = (Hin + 2*pad - KH)//stride + 1
        Wout = (Win + 2*pad - KW)//stride + 1
        xp = np.pad(x, ((0,0),(0,0),(pad,pad),(pad,pad)))
        out = np.zeros((N, Cout, Hout, Wout))
        for n in range(N):
            for co in range(Cout):
                for ho in range(Hout):
                    for wo in range(Wout):
                        s = 0
                        for ci in range(Cin):
                            for kh in range(KH):
                                for kw in range(KW):
                                    s += xp[n,ci,ho*stride+kh,wo*stride+kw]*w[co,ci,kh,kw]
                        out[n,co,ho,wo] = s + b[co]
        return out

    ref = conv_ref(x, w, b)
    diff_conv = np.max(np.abs(out_hw - ref))
    print(f"卷积映射最大误差: {diff_conv:.2e}")

    # 全连接映射验证
    x_fc = np.random.randn(2, 10).astype(np.float32)
    w_fc = np.random.randn(5, 10).astype(np.float32)
    b_fc = np.random.randn(5).astype(np.float32)
    out_fc = acc.fc_mapping(x_fc, w_fc, b_fc)
    ref_fc = x_fc @ w_fc.T + b_fc
    diff_fc = np.max(np.abs(out_fc - ref_fc))
    print(f"全连接映射最大误差: {diff_fc:.2e}")
落地与验证
运行方式:将上述代码保存为 mapping_sim.py,执行 python mapping_sim.py。需要NumPy环境(pip install numpy)。
验证判定标准:程序输出两行误差值。若卷积与全连接的最大误差均小于 1e-5,则说明算子到MAC阵列的映射逻辑正确,数值与参考实现一致。该误差仅来源于浮点累加顺序差异,并非实现错误。
映射要点说明
上述代码中,conv2d_mapping 展示了卷积算子映射的核心决策:外层循环按输出通道(MAC阵列行数)和输入通道(MAC阵列列数)分块,内层循环完成每个输出像素的滑窗乘累加。这种分块方式使得同一输入像素可被多个输出通道复用(输入复用),同一权重也可在多个空间位置复用(权重复用),是AI芯片设计中减少数据搬运的关键手段。fc_mapping 则展示了全连接层可视为卷积的特例(1×1卷积或直接矩阵乘),映射逻辑更简单,仅需按输出通道分块即可。
通过调整 mac_rows 与 mac_cols 参数,可以观察不同MAC阵列尺寸对分块粒度的影响——阵列越大,单次可并行处理的通道数越多,但片上存储压力也越大,这正是实际AI芯片设计中的面积-带宽折中。