3. 处理缺失值
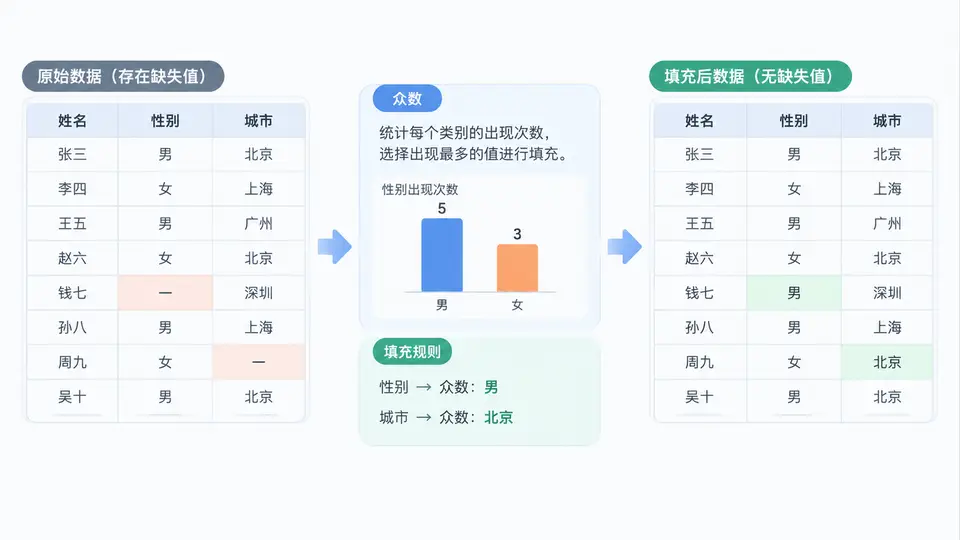
任务说明
本案例针对高频数据清洗中的典型场景——分类特征存在缺失值,要求使用众数填充策略完成缺失值处理。给定一份包含用户行为日志的示例数据集,其中“访问渠道”字段存在空值,需要计算该字段的众数(出现频率最高的取值),并用众数替换所有缺失值,最终输出清洗后的完整数据集。
数据样例
以下为原始数据(前8行),字段包括:user_id(用户ID)、visit_channel(访问渠道,含缺失值)、visit_count(访问次数)。
user_id,visit_channel,visit_count
1001,App,5
1002,Web,3
1003,,2
1004,App,7
1005,小程序,4
1006,Web,6
1007,,1
1008,App,3
实现代码
import pandas as pd
from io import StringIO

# 原始数据(含缺失值,用空字符串表示)
data = """user_id,visit_channel,visit_count
1001,App,5
1002,Web,3
1003,,2
1004,App,7
1005,小程序,4
1006,Web,6
1007,,1
1008,App,3"""

df = pd.read_csv(StringIO(data), dtype={'user_id': str})

# 查看缺失情况
print("缺失值数量:", df['visit_channel'].isna().sum())

# 计算众数(出现频率最高的取值)
mode_value = df['visit_channel'].mode()[0]
print("众数:", mode_value)

# 众数填充
df['visit_channel'] = df['visit_channel'].fillna(mode_value)

# 输出结果
print("\n填充后数据:")
print(df.to_string(index=False))

# 验证:确认无缺失值
assert df['visit_channel'].isna().sum() == 0
print("\n验证通过:缺失值已全部填充")
执行逻辑说明
代码首先通过pd.read_csv读取内嵌的CSV字符串数据,其中visit_channel列的空值会被pandas自动识别为NaN。随后调用mode()[0]获取该列众数——在示例数据中,“App”出现3次、“Web”出现2次、“小程序”出现1次,因此众数为“App”。最后使用fillna(mode_value)将所有缺失值替换为“App”,并通过断言确保填充后无残留缺失值。
落地与验证
运行方式:将上述代码保存为mode_fill.py,在已安装pandas的Python环境中执行python mode_fill.py。
预期输出:控制台依次打印缺失值数量(2)、众数(App)、填充后的完整数据表(user_id为1003和1007的两行visit_channel变为App),最后输出“验证通过:缺失值已全部填充”。
判定标准:若最终数据中visit_channel列不存在任何空值,且所有填充值均等于该列众数,则案例实现正确。