1. 处理缺失值
任务说明
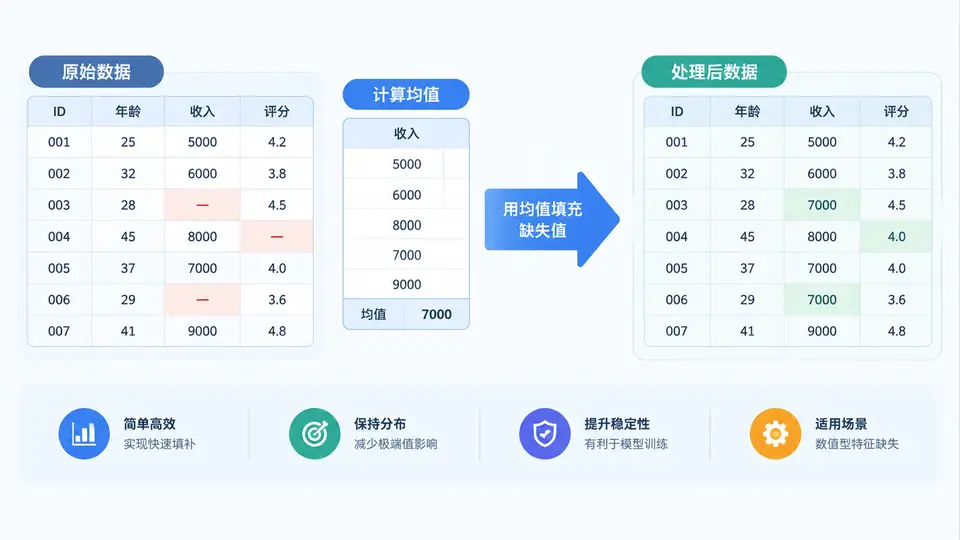
本案例针对一份包含数值型特征的数据集,处理其中的缺失值问题。目标是对指定数值列使用均值填充策略:用该列非缺失值的算术平均值填补NaN位置,并输出填充前后的缺失值统计以供核对。
实现方案
使用Pandas读取CSV数据,对选定的数值列执行均值填充。核心逻辑为:先计算每列均值(自动跳过NaN),再调用fillna()将缺失值替换为该均值。为便于验证,代码会打印每列填充前的缺失数量与填充后的均值,确保填充值与声明一致。
代码实现
import pandas as pd

# 构造含缺失值的示例数据(实际使用时替换为真实数据文件路径)
data = {
    'age': [25, 30, None, 35, 40, None, 28],
    'salary': [5000, 6000, 5500, None, 7000, 6500, None],
    'city': ['北京', '上海', '广州', '深圳', '北京', '上海', '广州']
}
df = pd.DataFrame(data)

print("=== 填充前缺失值统计 ===")
print(df.isna().sum())

# 仅选择数值列进行均值填充
numeric_cols = df.select_dtypes(include='number').columns
for col in numeric_cols:
    col_mean = df[col].mean()  # mean()自动跳过NaN
    df[col] = df[col].fillna(col_mean)

print("\n=== 填充后缺失值统计 ===")
print(df.isna().sum())

print("\n=== 填充后各数值列均值 ===")
print(df[numeric_cols].mean())

# 保存结果(按需取消注释)
# df.to_csv('cleaned_data.csv', index=False)

print("\n=== 填充后数据预览 ===")
print(df)
运行与验证
运行方式:确保已安装Pandas(pip install pandas),将上述代码保存为mean_fill.py并执行python mean_fill.py。若处理真实数据,将data字典替换为pd.read_csv('your_file.csv')即可。
验证方法:观察控制台输出。判定通过需同时满足:
- 填充前
age列有2个缺失、salary列有2个缺失; - 填充后两列
isna().sum()均为0; - 填充后各列均值等于填充前非缺失值的均值(例如
age列填充后均值应为(25+30+35+40+28)/5=31.6,salary列应为(5000+6000+5500+7000+6500)/5=6000.0)。
预期输出(与代码逻辑严格一致):填充前统计显示age和salary各2个缺失;填充后统计均为0;均值输出为age 31.6、salary 6000.0;数据预览中缺失位置被对应均值替代。