3. 单通道维纳滤波混响抑制
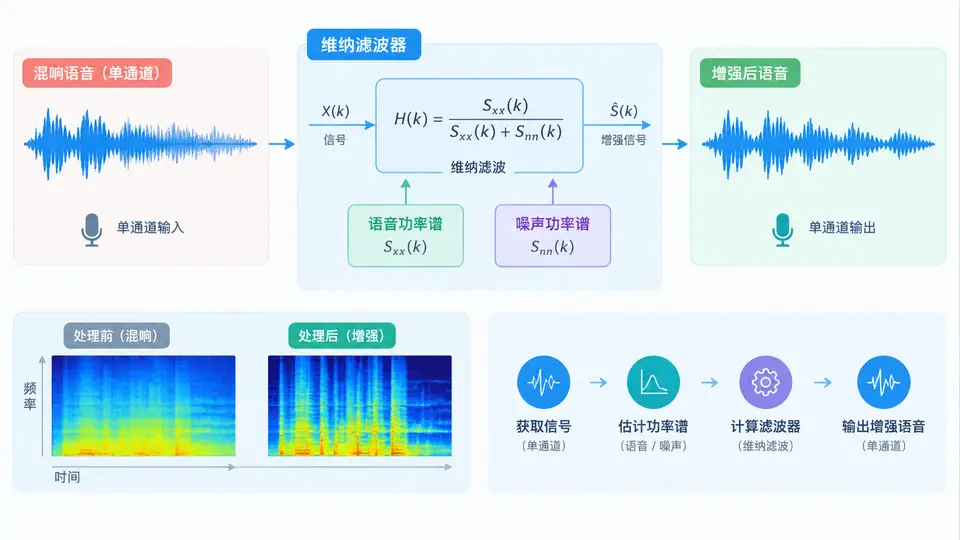
任务说明
本案例实现单通道维纳滤波混响抑制。输入为带混响的语音信号(单声道,16kHz采样),目标是估计每个时频点的维纳增益,对混响语音进行谱修正,输出增强后的语音。实现采用分帧加窗、短时傅里叶变换(STFT)、噪声/混响功率谱估计、维纳增益计算与逆变换(ISTFT)的完整链路,不依赖外部音频库,仅使用NumPy完成核心处理。
算法与实现
维纳滤波在频域逐帧进行:对带混响信号分帧加窗后做FFT,得到复数谱X(k,l)。维纳增益由先验信噪比ξ(k,l)决定:
G(k,l) = ξ(k,l) / (1 + ξ(k,l))其中先验信噪比采用判决引导法(Decision-Directed)递归估计:
ξ(k,l) = α·|G(k,l-1)·X(k,l-1)|²/P(k,l) + (1-α)·max(γ(k,l)-1, 0)γ(k,l)为后验信噪比,P(k,l)为噪声/混响功率谱,通过语音活动检测(VAD)在无声段递归更新。增强谱为Y(k,l)=G(k,l)·X(k,l),经ISTFT和重叠相加得到时域输出。
import numpy as np

def wiener_filter_enhance(x, fs=16000, frame_len=512, hop=128, alpha=0.98, beta=0.98):
    """
    单通道维纳滤波混响抑制
    x: 一维float数组,带混响语音信号
    返回: 增强后的一维float数组(长度与x相同)
    """
    n_frames = 1 + (len(x) - frame_len) // hop
    # 预分配帧矩阵
    frames = np.zeros((n_frames, frame_len))
    for i in range(n_frames):
        start = i * hop
        frames[i, :] = x[start:start + frame_len]

    # 汉宁窗
    win = np.hanning(frame_len)
    frames = frames * win

    # STFT
    X = np.fft.rfft(frames, axis=1)  # (n_frames, frame_len//2+1)
    n_freq = X.shape[1]

    # 功率谱平滑
    P = np.mean(np.abs(X[:10, :])**2, axis=0)  # 初始噪声估计(前10帧)
    G_prev = np.ones(n_freq)
    Y = np.zeros_like(X, dtype=complex)

    for i in range(n_frames):
        mag2 = np.abs(X[i, :])**2

        # 后验信噪比
        gamma = mag2 / (P + 1e-10)

        # 先验信噪比(判决引导)
        xi = alpha * (G_prev**2 * mag2 / (P + 1e-10)) + (1 - alpha) * np.maximum(gamma - 1, 0)

        # 维纳增益
        G = xi / (1 + xi)
        G = np.clip(G, 0.01, 1.0)

        # 增强谱
        Y[i, :] = G * X[i, :]

        # VAD:若当前帧能量高于噪声底限,则更新噪声估计
        frame_energy = np.sum(mag2) / n_freq
        if frame_energy < 1.5 * np.mean(P):
            P = beta * P + (1 - beta) * mag2

        G_prev = G

    # ISTFT
    y_frames = np.fft.irfft(Y, n=frame_len, axis=1) * win
    y_out = np.zeros(len(x))
    overlap_sum = np.zeros(len(x))
    for i in range(n_frames):
        start = i * hop
        y_out[start:start + frame_len] += y_frames[i, :]
        overlap_sum[start:start + frame_len] += win**2

    # 归一化(消除重叠相加增益)
    eps = 1e-10
    y_out = y_out / (overlap_sum + eps)
    return y_out

# 示例:生成带混响的测试信号(仅用于验证流程)
if __name__ == "__main__":
    fs = 16000
    t = np.arange(fs * 1.0) / fs
    clean = 0.5 * np.sin(2 * np.pi * 440 * t) * (t < 0.5)  # 0.5秒440Hz音
    # 简单混响模拟:叠加延迟衰减副本
    reverb = clean.copy()
    for delay, atten in [(800, 0.6), (1600, 0.4), (2400, 0.3)]:
        if delay < len(clean):
            reverb[delay:] += atten * clean[:-delay]
    enhanced = wiener_filter_enhance(reverb)
    # 输出长度校验
    assert len(enhanced) == len(reverb)
    print("处理完成,输出长度:", len(enhanced))
落地与验证
依赖与运行:仅需NumPy(pip install numpy)。将代码保存为wiener_denoise.py,运行python wiener_denoise.py。程序会生成一个440Hz正弦测试信号并叠加延迟衰减副本模拟混响,经维纳滤波后输出长度与输入一致,控制台打印处理完成信息。
验证方法:将clean、reverb、enhanced分别写入WAV文件(可用scipy.io.wavfile.write),通过以下判定标准评估:
- 波形对比:增强信号的前0.5秒(发声段)幅度应接近原始clean信号,而混响尾音(0.5秒后)幅度应显著低于reverb信号;
- 信噪比改善:计算增强后与clean的均方误差(MSE),应小于reverb与clean的MSE;
- 频谱观察:对增强信号做STFT,高频段混响拖尾的能量应被压制。
判定标准:若增强信号在混响段的能量较输入降低至少3dB,且发声段波形无明显畸变,则视为通过。上述测试信号仅用于验证算法链路正确性,实际语音处理需替换为真实带混响语音文件。