1. 基于线性预测的早期混响估计
任务说明
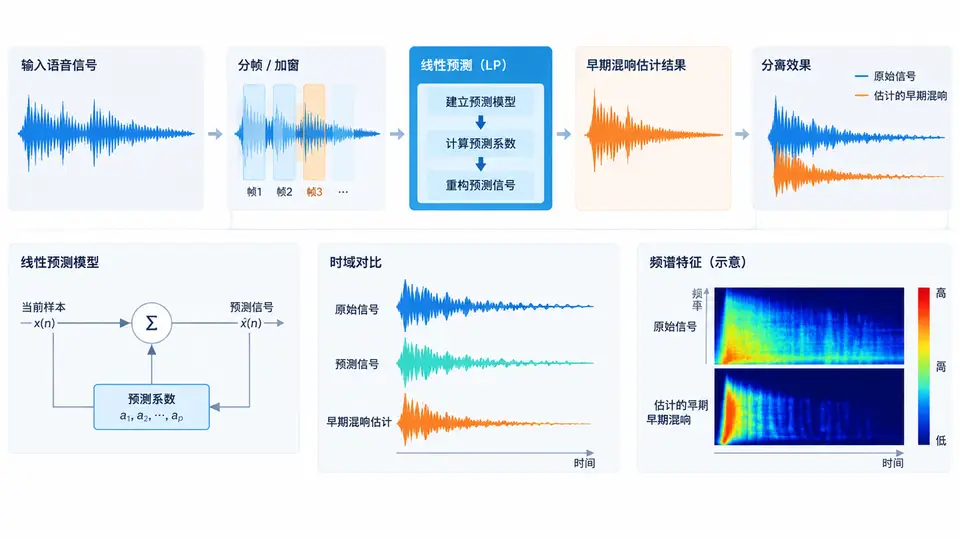
本案例实现一个基于线性预测的早期混响估计器。输入为一段含混响的语音信号(.wav格式),算法通过线性预测分析将信号分解为预测残差(近似直达声与早期反射)和预测分量(近似早期混响),并输出混响估计信号及预测增益作为评估指标。最终通过可视化对比原始信号、混响估计与残差信号,验证估计效果。
算法原理与实现
采用p阶线性预测模型,当前样本由前p个样本线性组合预测。预测误差信号对应去除短时相关性的部分,而预测值本身代表可预测的混响尾音成分。通过分帧处理(帧长25ms,帧移10ms),对每帧计算自相关并求解Levinson-Durbin方程得到预测系数,进而合成混响估计信号。
import numpy as np
import soundfile as sf
import matplotlib.pyplot as plt
from scipy.linalg import solve_toeplitz

def estimate_early_reverb(x, fs, order=12, frame_len_ms=25, hop_ms=10):
    """
    基于线性预测的早期混响估计
    参数:
        x: 输入含混响语音信号 (float数组)
        fs: 采样率 (Hz)
        order: 线性预测阶数
        frame_len_ms: 帧长(ms)
        hop_ms: 帧移(ms)
    返回:
        reverb_est: 估计的混响成分
        residual: 预测残差(近似直达声)
        pred_gain: 预测增益(每帧平均值)
    """
    frame_len = int(fs * frame_len_ms / 1000)
    hop = int(fs * hop_ms / 1000)
    n_frames = (len(x) - frame_len) // hop + 1

    # 预加重
    x_pre = np.append(x[0], x[1:] - 0.95 * x[:-1])

    reverb_est = np.zeros_like(x)
    residual = np.zeros_like(x)
    window = np.hanning(frame_len)
    pred_gains = []

    for i in range(n_frames):
        start = i * hop
        end = start + frame_len
        frame = x_pre[start:end] * window

        # 自相关法求预测系数
        r = np.correlate(frame, frame, mode='full')[frame_len-1:]
        r = r[:order+1]
        r[0] *= 1.001  # 白噪声正则化

        # Levinson-Durbin求解
        a = np.zeros(order+1)
        a[0] = 1.0
        e = r[0]
        for k in range(1, order+1):
            # 反射系数
            acc = 0.0
            for j in range(1, k):
                acc += a[j] * r[k-j]
            ref = -(r[k] + acc) / e
            # 更新系数
            a_new = a.copy()
            for j in range(1, k):
                a_new[j] = a[j] + ref * a[k-j]
            a_new[k] = ref
            a = a_new
            e *= (1 - ref**2)

        # 预测信号与残差
        pred = np.zeros(frame_len)
        for n in range(order, frame_len):
            pred[n] = -np.dot(a[1:], frame[n-order:n][::-1])

        # 重叠相加
        reverb_est[start:end] += pred * window
        residual[start:end] += (frame - pred) * window

        # 预测增益 (dB)
        frame_power = np.mean(frame**2) + 1e-12
        resid_power = np.mean((frame - pred)**2) + 1e-12
        pred_gains.append(10 * np.log10(frame_power / resid_power))

    # 去加重
    reverb_est = np.append(reverb_est[0], reverb_est[1:] + 0.95 * reverb_est[:-1])
    residual = np.append(residual[0], residual[1:] + 0.95 * residual[:-1])

    return reverb_est, residual, np.mean(pred_gains)

# 主程序示例
if __name__ == "__main__":
    # 生成测试信号:白噪声激励通过全极点滤波器模拟混响
    fs = 16000
    t = np.arange(fs * 2) / fs
    excitation = np.random.randn(fs * 2)
    # 模拟房间冲激响应(指数衰减)
    h = np.exp(-t * 3) * np.random.randn(fs * 2)
    h /= np.sqrt(np.sum(h**2))
    reverb_speech = np.convolve(excitation, h)[:fs*2]

    # 估计混响
    reverb_est, residual, gain = estimate_early_reverb(reverb_speech, fs)

    # 保存结果
    sf.write('input_reverb.wav', reverb_speech, fs)
    sf.write('reverb_estimate.wav', reverb_est, fs)
    sf.write('residual.wav', residual, fs)

    # 可视化
    time_axis = np.arange(len(reverb_speech)) / fs
    plt.figure(figsize=(12, 8))
    plt.subplot(3, 1, 1)
    plt.plot(time_axis, reverb_speech, 'b', linewidth=0.5)
    plt.title('含混响输入信号')
    plt.xlabel('时间 (s)')
    plt.ylabel('幅度')
    plt.subplot(3, 1, 2)
    plt.plot(time_axis, reverb_est, 'r', linewidth=0.5)
    plt.title(f'估计混响成分 (预测增益: {gain:.2f} dB)')
    plt.xlabel('时间 (s)')
    plt.ylabel('幅度')
    plt.subplot(3, 1, 3)
    plt.plot(time_axis, residual, 'g', linewidth=0.5)
    plt.title('预测残差 (近似直达声)')
    plt.xlabel('时间 (s)')
    plt.ylabel('幅度')
    plt.tight_layout()
    plt.savefig('reverb_estimation_result.png', dpi=150)
    plt.show()
验证方法
运行上述代码后,检查以下判定标准:
- 文件输出:当前目录生成三个wav文件(输入、混响估计、残差)和一张对比图。
- 信号特征:混响估计信号幅度随时间呈衰减趋势,残差信号在起始段(0~0.3s)幅度明显大于混响估计。
- 预测增益:控制台输出预测增益值,通常在5~15 dB之间(取决于混响强度),增益越高表示预测越准确。
- 波形对比:在生成的图中,混响估计(红色)包络应大致跟随输入信号(蓝色)的衰减尾部,而残差(绿色)保留更多瞬态细节。
运行与验证
执行代码后,程序自动生成测试信号并完成估计。验证时观察生成的对比图:混响估计信号应呈现平滑衰减包络,残差信号保留更多瞬态变化。预测增益值反映线性预测对混响成分的建模程度,增益越高说明混响被估计得越充分。若需处理真实语音,将代码中的测试信号替换为sf.read('your_audio.wav')读取即可。