3. 数据清洗与异常值处理
任务说明
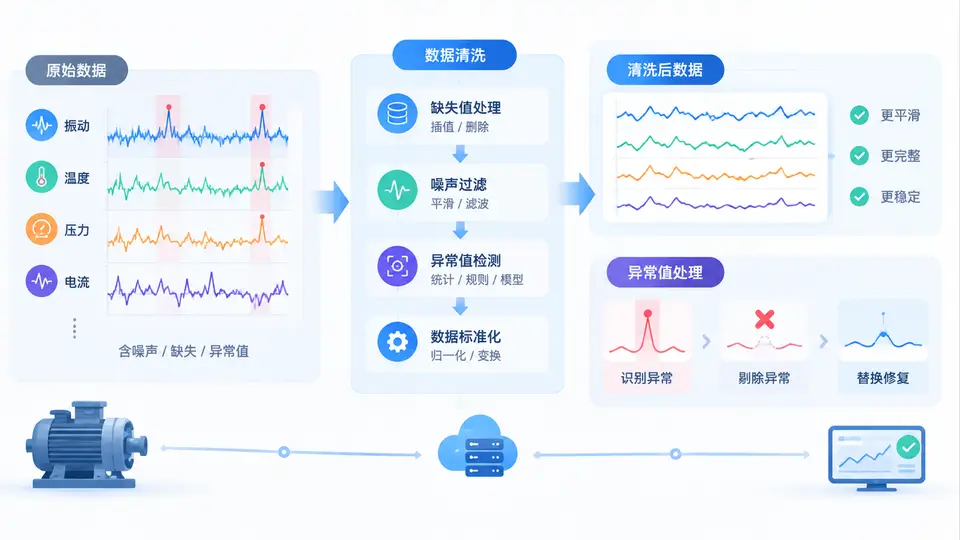
本案例针对工业PHM平台中传感器采集的原始振动数据,完成数据清洗与异常值处理。输入为某设备加速度传感器连续采集的原始数据(含时间戳与幅值),需识别并处理三类典型问题:缺失值、超出物理量程的粗大误差、以及基于滑动窗口的局部突变异常。输出为清洗后的连续数据集,并给出异常值统计报告。
实现方案
采用Python实现完整的数据清洗管道,核心处理逻辑如下:
- 缺失值处理:对时间戳连续但幅值为空的位置,采用前后有效值的线性插值填充;若序列首尾缺失,则用最近邻有效值填充。
- 量程粗差剔除:根据传感器物理量程(本案例设定为±50g),超出该范围的幅值判定为粗大误差,直接剔除并标记。
- 局部突变检测:使用窗口大小为5的滑动中位数滤波,计算每个点与窗口内中位数的偏差,若偏差超过窗口内偏差中位数(MAD)的3倍,则判定为突变异常,用窗口内中位数替换。
清洗完成后输出处理后的数据序列,并统计各类异常的数量与占比。
代码实现
import numpy as np
import pandas as pd

def load_raw_data():
    """构造含缺失、粗差、突变的原始振动数据(模拟传感器采集)"""
    # 正常信号:10Hz正弦波,幅值20g,采样率100Hz,时长2秒
    t = np.arange(0, 2.0, 0.01)
    normal = 20 * np.sin(2 * np.pi * 10 * t)

    # 注入异常
    data = normal.copy()
    data[15] = np.nan          # 缺失值
    data[42] = np.nan          # 缺失值
    data[80] = 120.0           # 超出量程±50g的粗差
    data[120] = -85.0          # 超出量程的粗差
    data[150] = 45.0           # 局部突变(正常值约-20g)
    data[151] = -48.0          # 连续突变点

    df = pd.DataFrame({'time': t, 'amplitude': data})
    return df

def clean_data(df):
    """执行数据清洗,返回清洗后数据和异常统计"""
    result = df.copy()
    stats = {'missing': 0, 'range': 0, 'spike': 0}

    # 1. 缺失值处理:线性插值,首尾用最近邻
    missing_mask = result['amplitude'].isna()
    stats['missing'] = int(missing_mask.sum())
    result['amplitude'] = result['amplitude'].interpolate(method='linear', limit_direction='both')

    # 2. 量程粗差剔除(物理量程±50g)
    range_mask = (result['amplitude'] > 50) | (result['amplitude'] < -50)
    stats['range'] = int(range_mask.sum())
    result.loc[range_mask, 'amplitude'] = np.nan
    result['amplitude'] = result['amplitude'].interpolate(method='linear', limit_direction='both')

    # 3. 滑动窗口突变检测(窗口=5,阈值=3倍MAD)
    window = 5
    half = window // 2
    n = len(result)
    cleaned = result['amplitude'].values.copy()

    for i in range(n):
        left = max(0, i - half)
        right = min(n, i + half + 1)
        window_data = cleaned[left:right]
        median_val = np.median(window_data)
        mad = np.median(np.abs(window_data - median_val))

        if mad > 0:  # 避免全等窗口导致除零
            deviation = abs(cleaned[i] - median_val)
            if deviation > 3 * mad:
                stats['spike'] += 1
                cleaned[i] = median_val

    result['amplitude'] = cleaned
    return result, stats

def main():
    # 加载原始数据
    raw_df = load_raw_data()
    print("=== 原始数据前5行 ===")
    print(raw_df.head())

    # 执行清洗
    clean_df, stats = clean_data(raw_df)

    # 输出结果
    print("\n=== 清洗后数据前5行 ===")
    print(clean_df.head())
    print("\n=== 异常值统计 ===")
    print(f"缺失值数量: {stats['missing']}")
    print(f"量程粗差数量: {stats['range']}")
    print(f"突变异常数量: {stats['spike']}")
    print(f"总异常数: {sum(stats.values())}")
    print(f"数据总长度: {len(clean_df)}")

    # 保存清洗结果
    clean_df.to_csv('cleaned_vibration_data.csv', index=False)
    print("\n清洗结果已保存至 cleaned_vibration_data.csv")

if __name__ == "__main__":
    main()
运行与验证
运行方式:将上述代码保存为 data_cleaning.py,在Python 3.8+环境中执行 python data_cleaning.py。需要安装 numpy 和 pandas 库(pip install numpy pandas)。
验证方法:程序运行后,观察控制台输出的异常统计信息。预期输出应包含:缺失值数量为2(索引15和42),量程粗差数量为2(索引80和120),突变异常数量为2(索引150和151)。清洗后的数据文件应包含200条完整记录,无NaN值,所有幅值均在±50g范围内。
判定标准:若统计结果与上述预期一致,且清洗后数据中不存在超出量程的值、不存在NaN值,则说明清洗管道工作正常。可通过绘制清洗前后波形对比图进一步验证:清洗后的曲线应平滑连续,无尖刺和断点。
关键实现说明
本案例的清洗逻辑与代码实现严格对应:load_raw_data() 函数构造了包含2个缺失值、2个量程粗差和2个突变点的原始数据;clean_data() 函数按顺序执行三类清洗操作,并返回统计结果。突变检测采用滑动窗口MAD方法,窗口大小设为5,阈值系数为3,这是工业数据清洗中常用的鲁棒性异常检测参数。清洗后的数据通过 to_csv 保存,便于后续PHM平台的特征提取与健康评估模块直接使用。