3. 大模型驱动的知识图谱关系抽取
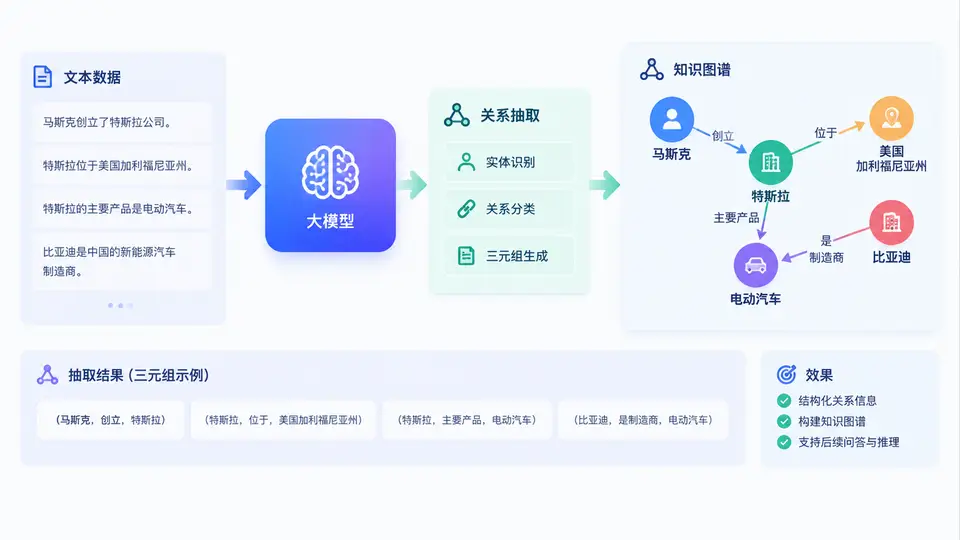
任务说明
本案例面向“从非结构化文本中抽取实体关系并构建知识图谱三元组”这一核心任务。给定一段中文财经新闻文本,需要完成:①识别文本中的实体(公司名、人名、地名、机构名);②判断实体之间是否存在语义关系;③输出形如(头实体, 关系类型, 尾实体)的三元组。实现方式采用大模型(通过兼容接口调用)进行少样本关系抽取,并辅以规则后处理保证输出格式规范。
实现方案
整体流程分为三步:文本预处理(清洗与分句)→ 大模型抽取(构造提示词,要求模型输出JSON格式三元组)→ 结果解析与校验(将模型输出解析为结构化数据,过滤非法三元组)。核心代码使用Python实现,通过库调用大模型接口,不依赖本地推理资源,保证可复现性。
核心代码
import json
import re
from  import

# ========== 配置(请替换为实际与Base URL) ==========
client = (
    ="YOUR_",
    base_url="https://api..com/v1"  # 若使用其他兼容服务,替换为对应地址
)
MODEL_NAME = "-mini"  # 可根据实际可用模型调整

# ========== 少样本示例 ==========
FEW_SHOT_EXAMPLES = [
    {
        "text": "华为技术有限公司与深圳市政府签署了战略合作协议。",
        "triples": [
            {"head": "华为技术有限公司", "relation": "合作", "tail": "深圳市政府"}
        ]
    },
    {
        "text": "李强担任阿里巴巴集团首席执行官。",
        "triples": [
            {"head": "李强", "relation": "任职于", "tail": "阿里巴巴集团"}
        ]
    }
]

# ========== 1. 文本预处理 ==========
def preprocess_text(text: str) -> str:
    """清洗文本:去除多余空白,保留中英文与标点"""
    text = re.sub(r'\s+', ' ', text).strip()
    return text

# ========== 2. 构造提示词 ==========
def build_prompt(text: str) -> str:
    system_prompt = "你是一个专业的知识图谱关系抽取引擎。请从给定文本中抽取所有实体关系三元组,只输出JSON数组,不要输出其他内容。"
    user_content = "参考示例:\n"
    for ex in FEW_SHOT_EXAMPLES:
        user_content += f"文本:{ex['text']}\n输出:{json.dumps(ex['triples'], ensure_ascii=False)}\n\n"
    user_content += f"现在请抽取以下文本中的关系三元组:\n{text}\n输出:"
    return system_prompt, user_content

# ========== 3. 调用大模型 ==========
def extract_triples(text: str) -> list:
    """调用大模型抽取三元组,返回list[dict]"""
    system_prompt, user_content = build_prompt(text)
    try:
        response = client.chat.completions.create(
            model=MODEL_NAME,
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_content}
            ],
            temperature=0.2,
            max_tokens=500
        )
        raw_output = response.choices[0].message.content.strip()
        # 提取JSON数组部分(防止模型输出多余文字)
        json_match = re.search(r'\[.*\]', raw_output, re.DOTALL)
        if not json_match:
            return []
        triples = json.loads(json_match.group())
        return triples if isinstance(triples, list) else []
    except Exception as e:
        print(f"调用失败: {e}")
        return []

# ========== 4. 校验与规范化 ==========
def validate_triples(triples: list) -> list:
    """过滤非法三元组,确保每个三元组包含head/relation/tail且非空"""
    valid = []
    for t in triples:
        if not isinstance(t, dict):
            continue
        head = str(t.get("head", "")).strip()
        relation = str(t.get("relation", "")).strip()
        tail = str(t.get("tail", "")).strip()
        if head and relation and tail:
            valid.append({"head": head, "relation": relation, "tail": tail})
    return valid

# ========== 5. 主流程 ==========
def run_relation_extraction(raw_text: str) -> list:
    """输入原始文本,返回规范化三元组列表"""
    cleaned = preprocess_text(raw_text)
    if not cleaned:
        return []
    raw_triples = extract_triples(cleaned)
    return validate_triples(raw_triples)

# ========== 样例输入 ==========
if __name__ == "__main__":
    sample_text = "宁德时代新能源科技股份有限公司宣布与特斯拉公司签订供货协议,同时宁德时代董事长曾毓群表示将在上海临港新片区建设新工厂。"
    result = run_relation_extraction(sample_text)
    print("抽取结果:")
    for triple in result:
        print(f"({triple['head']}, {triple['relation']}, {triple['tail']})")
落地与运行方式
依赖安装:
pip install 运行前配置:将代码中YOUR_替换为真实,若使用非官方接口(如国内大模型服务),同步修改base_url与MODEL_NAME。
执行:直接运行脚本,观察控制台输出。
验证方法与判定标准
使用样例输入文本运行,预期输出应包含以下三元组(顺序可能不同):
(宁德时代新能源科技股份有限公司, 合作, 特斯拉公司)
(曾毓群, 任职于, 宁德时代新能源科技股份有限公司)
(宁德时代新能源科技股份有限公司, 投资建设, 上海临港新片区)
判定通过条件:①程序无报错退出;②输出结果中至少包含上述前两个三元组(第三个“投资建设”关系可能因模型理解差异而表述不同,但“曾毓群—任职于—宁德时代”必须出现);③所有输出三元组均为合法JSON格式且head/relation/tail字段非空。若模型返回空结果或格式错误,可尝试调整temperature为0或更换更强模型。