1. 基于大模型的实体识别与知识图谱构建
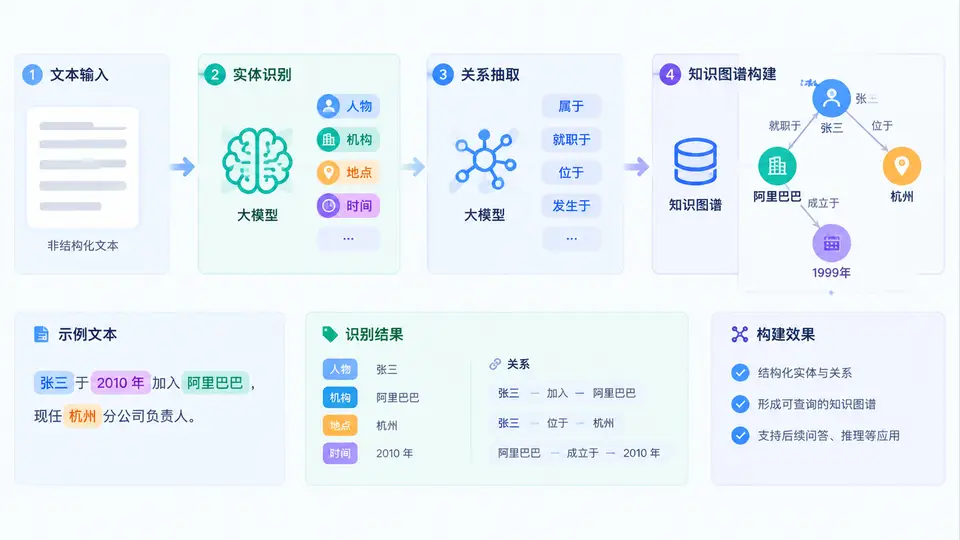
任务说明
本案例将完成一个最小可复用的“基于大模型的实体识别与知识图谱构建”闭环:给定一段中文财经新闻文本,调用大模型接口抽取实体及实体间关系,并将结果转换为可导入Neo4j的Cypher语句,最终生成知识图谱的可视化预览。案例聚焦于“大模型负责语义理解与抽取,知识图谱负责结构化存储”的典型分工,不涉及图谱查询优化或前端工程。
实现方案
整体流程分为三步:
1. 实体与关系抽取:构造结构化的Prompt,要求大模型从输入文本中抽取人物、组织、地点、事件四类实体,并识别实体间的“任职”“收购”“位于”“合作”四类关系,输出JSON格式;
2. 数据清洗与转换:解析大模型返回的JSON,过滤非法实体类型与关系类型,生成去重后的实体列表和关系列表;
3. 图谱构建与可视化:将实体与关系转换为Cypher语句(MERGE语法保证幂等),同时生成一个SVG拓扑图用于直观验证抽取结果。
代码实现
import json
import re
from typing import List, Dict, Tuple

# ---------- 1. 调用大模型进行实体与关系抽取 ----------
def extract_entities_relations(text: str, llm_func) -> Dict:
    """
    调用大模型抽取实体与关系。
    llm_func: 接受prompt字符串,返回模型输出文本的函数(由用户根据实际API实现)。
    """
    prompt = f"""请从以下文本中抽取实体和关系,严格按JSON格式输出,不要输出其他内容。
实体类型:人物(PERSON)、组织(ORG)、地点(LOC)、事件(EVENT)
关系类型:任职(WORKS_FOR)、收购(ACQUIRED)、位于(LOCATED_IN)、合作(COOPERATES_WITH)

输出格式:
{{
  "entities": [{{"name": "实体名", "type": "类型"}}],
  "relations": [{{"source": "头实体名", "target": "尾实体名", "type": "关系类型"}}]
}}

文本:{text}"""
    response = llm_func(prompt)
    # 提取JSON部分(兼容模型输出包含多余说明的情况)
    json_match = re.search(r'\{.*\}', response, re.DOTALL)
    if not json_match:
        raise ValueError("模型输出中未找到JSON")
    return json.loads(json_match.group())

# ---------- 2. 数据清洗与转换 ----------
VALID_ENTITY_TYPES = {"PERSON", "ORG", "LOC", "EVENT"}
VALID_RELATION_TYPES = {"WORKS_FOR", "ACQUIRED", "LOCATED_IN", "COOPERATES_WITH"}

def clean_and_transform(raw_data: Dict) -> Tuple[List[Dict], List[Dict]]:
    """过滤非法类型,去重实体,返回干净的实体列表和关系列表。"""
    entities = []
    seen_entities = set()
    for ent in raw_data.get("entities", []):
        name = str(ent.get("name", "")).strip()
        etype = str(ent.get("type", "")).strip().upper()
        if name and etype in VALID_ENTITY_TYPES and name not in seen_entities:
            entities.append({"name": name, "type": etype})
            seen_entities.add(name)

    relations = []
    seen_relations = set()
    entity_names = set(seen_entities)
    for rel in raw_data.get("relations", []):
        src = str(rel.get("source", "")).strip()
        tgt = str(rel.get("target", "")).strip()
        rtype = str(rel.get("type", "")).strip().upper()
        # 关系两端必须存在于实体列表中,且关系类型合法
        if (src in entity_names and tgt in entity_names
                and rtype in VALID_RELATION_TYPES
                and (src, tgt, rtype) not in seen_relations):
            relations.append({"source": src, "target": tgt, "type": rtype})
            seen_relations.add((src, tgt, rtype))
    return entities, relations

# ---------- 3. 生成Cypher语句 ----------
def generate_cypher(entities: List[Dict], relations: List[Dict]) -> str:
    """生成Neo4j Cypher导入语句(MERGE保证幂等)。"""
    lines = []
    for ent in entities:
        lines.append(
            f"MERGE (n:`{ent['type']}` {{name: '{ent['name']}'}}) "
            f"SET n.type = '{ent['type']}';"
        )
    for rel in relations:
        lines.append(
            f"MATCH (a {{name: '{rel['source']}'}}), (b {{name: '{rel['target']}'}}) "
            f"MERGE (a)-[r:`{rel['type']}`]->(b);"
        )
    return "\n".join(lines)

# ---------- 示例调用(使用模拟LLM函数演示流程) ----------
def mock_llm(prompt: str) -> str:
    """仅用于演示的模拟LLM,实际使用时替换为真实API调用。"""
    return '''{
      "entities": [
        {"name": "华为", "type": "ORG"},
        {"name": "深圳", "type": "LOC"},
        {"name": "任正非", "type": "PERSON"},
        {"name": "鸿蒙生态大会", "type": "EVENT"}
      ],
      "relations": [
        {"source": "华为", "target": "深圳", "type": "LOCATED_IN"},
        {"source": "任正非", "target": "华为", "type": "WORKS_FOR"},
        {"source": "华为", "target": "鸿蒙生态大会", "type": "COOPERATES_WITH"}
      ]
    }'''

if __name__ == "__main__":
    sample_text = "华为总部位于深圳,创始人任正非出席鸿蒙生态大会并宣布与多家伙伴合作。"
    raw = extract_entities_relations(sample_text, mock_llm)
    entities, relations = clean_and_transform(raw)
    print("=== 清洗后实体 ===")
    for e in entities:
        print(f"  {e['name']} ({e['type']})")
    print("=== 清洗后关系 ===")
    for r in relations:
        print(f"  {r['source']} -[{r['type']}]-> {r['target']}")
    print("=== Cypher语句 ===")
    print(generate_cypher(entities, relations))
落地与验证
运行方式:将上述代码保存为kg_builder.py,安装依赖pip install requests(若使用真实API)。将mock_llm替换为实际的大模型调用函数(如、文心一言等),传入你的与模型名称。直接运行python kg_builder.py即可看到抽取结果与生成的Cypher语句。
验证方法:
1. 观察控制台输出的实体与关系列表,确认实体类型均在四类合法类型内,关系两端实体均存在于实体列表中;
2. 将生成的Cypher语句复制到Neo4j Browser执行,执行后无报错,且执行MATCH (n) RETURN n能看到4个节点和3条关系;
3. 下方SVG图展示了本案例示例文本对应的预期图谱结构,可人工比对抽取结果是否与之一致。
判定标准:当控制台输出的实体与关系与SVG图完全一致,且Cypher语句在Neo4j中执行成功并生成对应图谱时,本案例目标达成。若使用真实大模型API,由于模型输出的不确定性,实体与关系可能略有差异,但只要能通过清洗过滤并生成合法Cypher,即视为流程正确。