3. 金融文本命名实体识别
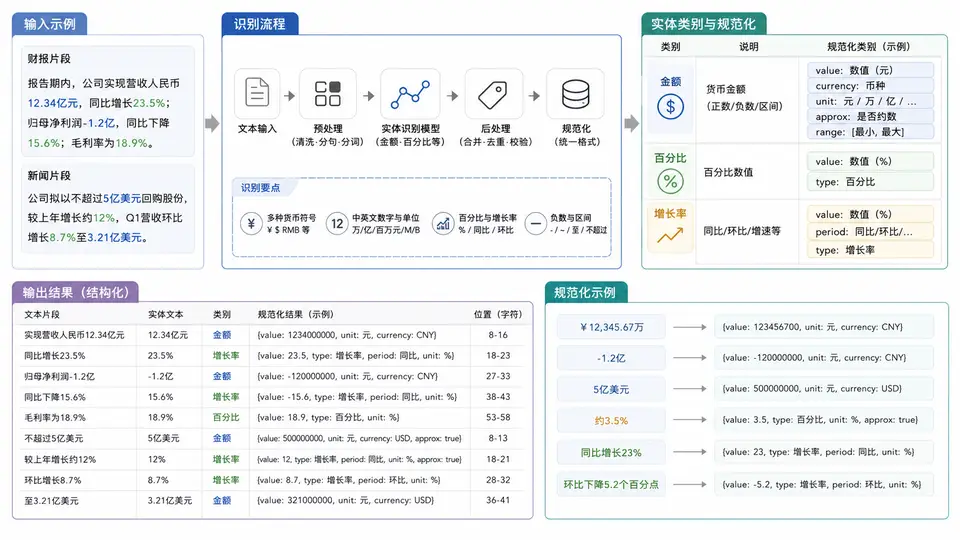
任务与边界
从财报/新闻句子中抽取三类数值实体:货币金额(如 1.2亿元、$3.5 million)、百分比(如 12.5%、百分之八)、增长率(如 同比增长15%、环比下降3.2个百分点)。抽取后统一为结构化字段:类型、原始文本、数值、单位、方向(增长/下降/无)。
实现方式:正则规则 + 中文数字转换,不依赖外部模型,纯 Python 标准库即可运行。
处理流程
完整代码
import re

CN_NUM = {'零':0,'一':1,'二':2,'两':2,'三':3,'四':4,'五':5,'六':6,'七':7,'八':8,'九':9}
CN_UNIT = {'十':10,'百':100,'千':1000,'万':10000,'亿':100000000}

def cn_to_num(s):
    """中文数字转阿拉伯数字,支持'百分之八'中的'八'、'一点二'等"""
    if not s:
        return None
    # 处理小数:一点二
    if '点' in s:
        int_part, dec_part = s.split('点', 1)
        int_val = cn_to_num(int_part) or 0
        dec_str = ''.join(str(CN_NUM.get(c, 0)) for c in dec_part)
        return float(f"{int_val}.{dec_str}")
    total, section, num = 0, 0, 0
    for ch in s:
        if ch in CN_NUM:
            num = CN_NUM[ch]
        elif ch in CN_UNIT:
            unit = CN_UNIT[ch]
            if unit >= 10000:
                section = (section + num) * unit
                total += section
                section, num = 0, 0
            else:
                section += (num if num else 1) * unit
                num = 0
    return total + section + num

# 金额:数字+单位(亿/万/元/美元等),或 $/¥ 前缀
MONEY_RE = re.compile(
    r'(?P<cur>[$¥¥])?\s*(?P<num>\d+(?:\.\d+)?)\s*(?P<unit>亿元|万元|亿|万|元|美元|million|billion)?'
)
# 百分比:数字% 或 百分之中文
PCT_RE = re.compile(r'(?P<num>\d+(?:\.\d+)?)\s*%|百分之(?P<cn>[零一二两三四五六七八九十点]+)')
# 增长率:方向词 + 百分比
GROW_RE = re.compile(r'(?P<dir>同比增长|环比增长|增长|同比增长率|环比下降|下降|减少|上升)\s*(?P<pct>\d+(?:\.\d+)?)\s*%')

UNIT_MAP = {'亿元':'亿元','万元':'万元','亿':'亿元','万':'万元','元':'元','美元':'美元',
            'million':'百万美元','billion':'十亿美元'}

def extract(text):
    results = []
    # 先抽增长率(优先级高,避免被百分比重复匹配)
    grow_spans = []
    for m in GROW_RE.finditer(text):
        grow_spans.append(m.span())
        direction = '下降' if ('下降' in m.group('dir') or '减少' in m.group('dir')) else '增长'
        results.append({
            'type': 'growth_rate', 'text': m.group(0),
            'value': float(m.group('pct')), 'unit': '%', 'direction': direction
        })
    # 金额
    for m in MONEY_RE.finditer(text):
        if not m.group('num'):
            continue
        if any(s <= m.start() < e for s, e in grow_spans):
            continue
        unit = UNIT_MAP.get(m.group('unit') or '', m.group('unit') or '')
        cur = m.group('cur') or ''
        results.append({
            'type': 'money', 'text': m.group(0).strip(),
            'value': float(m.group('num')), 'unit': cur + unit if cur else unit,
            'direction': None
        })
    # 百分比
    for m in PCT_RE.finditer(text):
        if any(s <= m.start() < e for s, e in grow_spans):
            continue
        if m.group('num'):
            val = float(m.group('num'))
        else:
            val = cn_to_num(m.group('cn'))
        results.append({
            'type': 'percentage', 'text': m.group(0),
            'value': val, 'unit': '%', 'direction': None
        })
    return results

if __name__ == '__main__':
    samples = [
        "公司2023年营收1.2亿元,同比增长15%,净利润率为百分之八。",
        "Q2 revenue reached $3.5 million, down 3.2% quarter over quarter.",
        "总资产达500万元,环比下降2个百分点。"
    ]
    for s in samples:
        print("输入:", s)
        for r in extract(s):
            print("  ", r)
        print()
运行与验证
运行:python extract.py。观察输出中每条实体是否包含 type / text / value / unit / direction 五个字段。
通过条件:
- 第一句应识别出
1.2亿元(money)、15%(growth_rate, 增长)、百分之八(percentage, value=8)。 - 第二句应识别出
$3.5 million(money, unit=百万美元)、3.2%(growth_rate, 下降)。 - 第三句应识别出
500万元(money)、2%(growth_rate, 下降)。
若某条缺失或类型错误,检查对应正则是否被增长率跨度过滤误伤。