1. 金融新闻标题分词与词性标注
任务说明
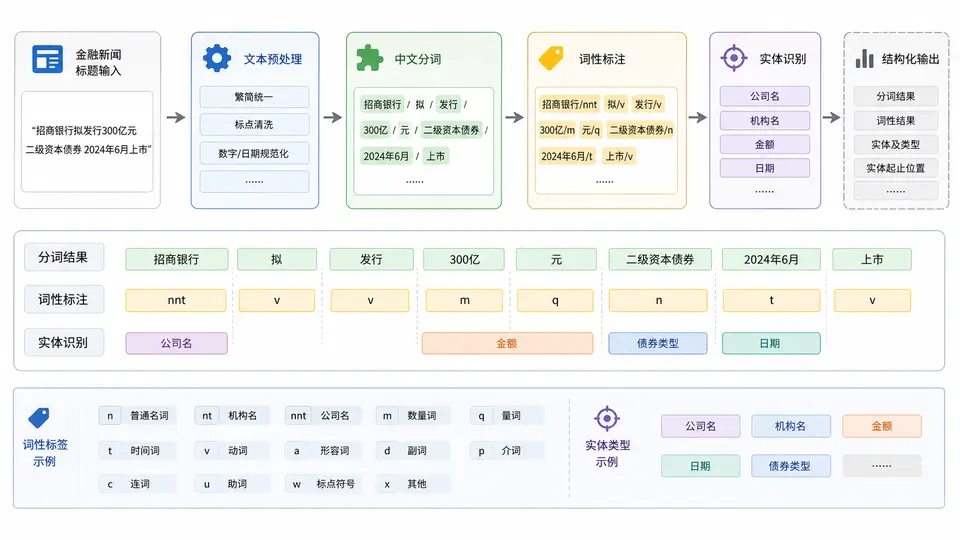
对金融新闻标题做中文分词与词性标注,并从中抽取公司名、机构名、金额、日期四类关键实体。使用 jieba 的 posseg 模块完成分词与词性标注,再按词性标签过滤实体。
环境与依赖
pip install jieba实现代码
import jieba.posseg as pseg

# 词性标签映射:jieba 的 nr=人名, nt=机构团体, ns=地名, m=数词, t=时间
ENTITY_RULES = {
    "company": {"nt"},          # 机构团体名(含公司)
    "org":     {"nt"},          # 机构名
    "money":   {"m"},           # 数词(金额核心)
    "date":    {"t"},           # 时间词
}

def analyze_title(title):
    """分词 + 词性标注,返回词列表和实体字典"""
    words = [(w.word, w.flag) for w in pseg.cut(title)]
    entities = {k: [] for k in ENTITY_RULES}
    for word, flag in words:
        for ent_type, flags in ENTITY_RULES.items():
            if flag in flags:
                entities[ent_type].append(word)
    return words, entities

def extract_entities(title):
    """只返回实体字典"""
    _, entities = analyze_title(title)
    return entities

if __name__ == "__main__":
    titles = [
        "贵州茅台2024年第三季度净利润同比增长15%",
        "中国平安拟收购深圳发展银行全部股份",
        "央行今日开展5000亿元逆回购操作",
        "阿里巴巴宣布在杭州投资100亿元建设数据中心",
    ]
    for t in titles:
        words, ents = analyze_title(t)
        print("标题:", t)
        print("分词:", "/".join(f"{w}({f})" for w, f in words))
        print("实体:", {k: v for k, v in ents.items() if v})
        print("-" * 50)
运行方式
python analyze.py验证方法与通过条件
- 运行后每条标题应输出分词结果(词+词性标签)和实体字典。
- 通过条件:金额类实体能捕获数词(如"5000亿""100亿"中的数词部分),日期类能捕获时间词(如"2024年"),机构类能捕获
nt标签词(如"央行""阿里巴巴")。 - 若某类实体为空列表,说明该标题中无对应词性词,属正常情况。
关键点
jieba 的 nt 标签同时覆盖公司和机构,因此 company 与 org 会得到相同结果;如需区分,可加载自定义词典为具体公司名指定标签。金额识别依赖数词 m,实际金额单位(亿/万)可能被切为独立词,可按需合并相邻数词与量词。